قمع الأخطاء وتشكيلها
يمكن أن يشير قمع الأخطاء إلى أي تقنية تتوقع وتحاول تجنب أنواع معينة من الضوضاء والأخطاء. من الأسهل شرح هذا من خلال أمثلة ملموسة، لكن ضع في اعتبارك أن هذه الطرق لا تقتصر على الأمثلة الموضحة هنا، ويتم استكشاف طرق جديدة باستمرار. في بعض الأحيان لا يمكن قمع الأخطاء، لكن يمكن التأثير على كيفية تراكمها. إذا استطعنا جعل الأخطاء تتراكم بشكل أبطأ، فقد نصف هذا بأنه قمع للخطأ الكلي، لكن الأدق اعتباره تشكيلاً للضوضاء. في هذا الدرس نغطي أمثلة نموذجية على قمع الأخطاء (الفصل الديناميكي) وتشكيل/صياغة الضوضاء (لف باولي).
سيتم إطلاق فيديو مرافق لهذا الدرس في الأيام القليلة القادمة، وسيتم تضمينه هنا.
الفصل الديناميكي
لنبدأ بحالة بسيطة جداً على كيوبت واحد، ونقدم نموذج ضوضاء بسيط. هذا غير كافٍ لشرح الفصل الديناميكي بشكل كامل، لكنه يعطينا مثالاً واضحاً. لنفترض أن لدينا كيوبت مُحضّراً في حالة تراكب باستخدام بوابة هادامارد:
يتم تصور هذه الحالة على كرة بلوخ كما هو موضح أدناه على اليسار. في الحالة المثالية بدون ضوضاء، سيظل هذا الكيوبت في هذه الحالة حتى تنفيذ العملية التالية. لكننا نعلم من الدرس السابق أن هذا ليس ما نلاحظه. تسبب الضوضاء تدهور المعلومات الكمية.
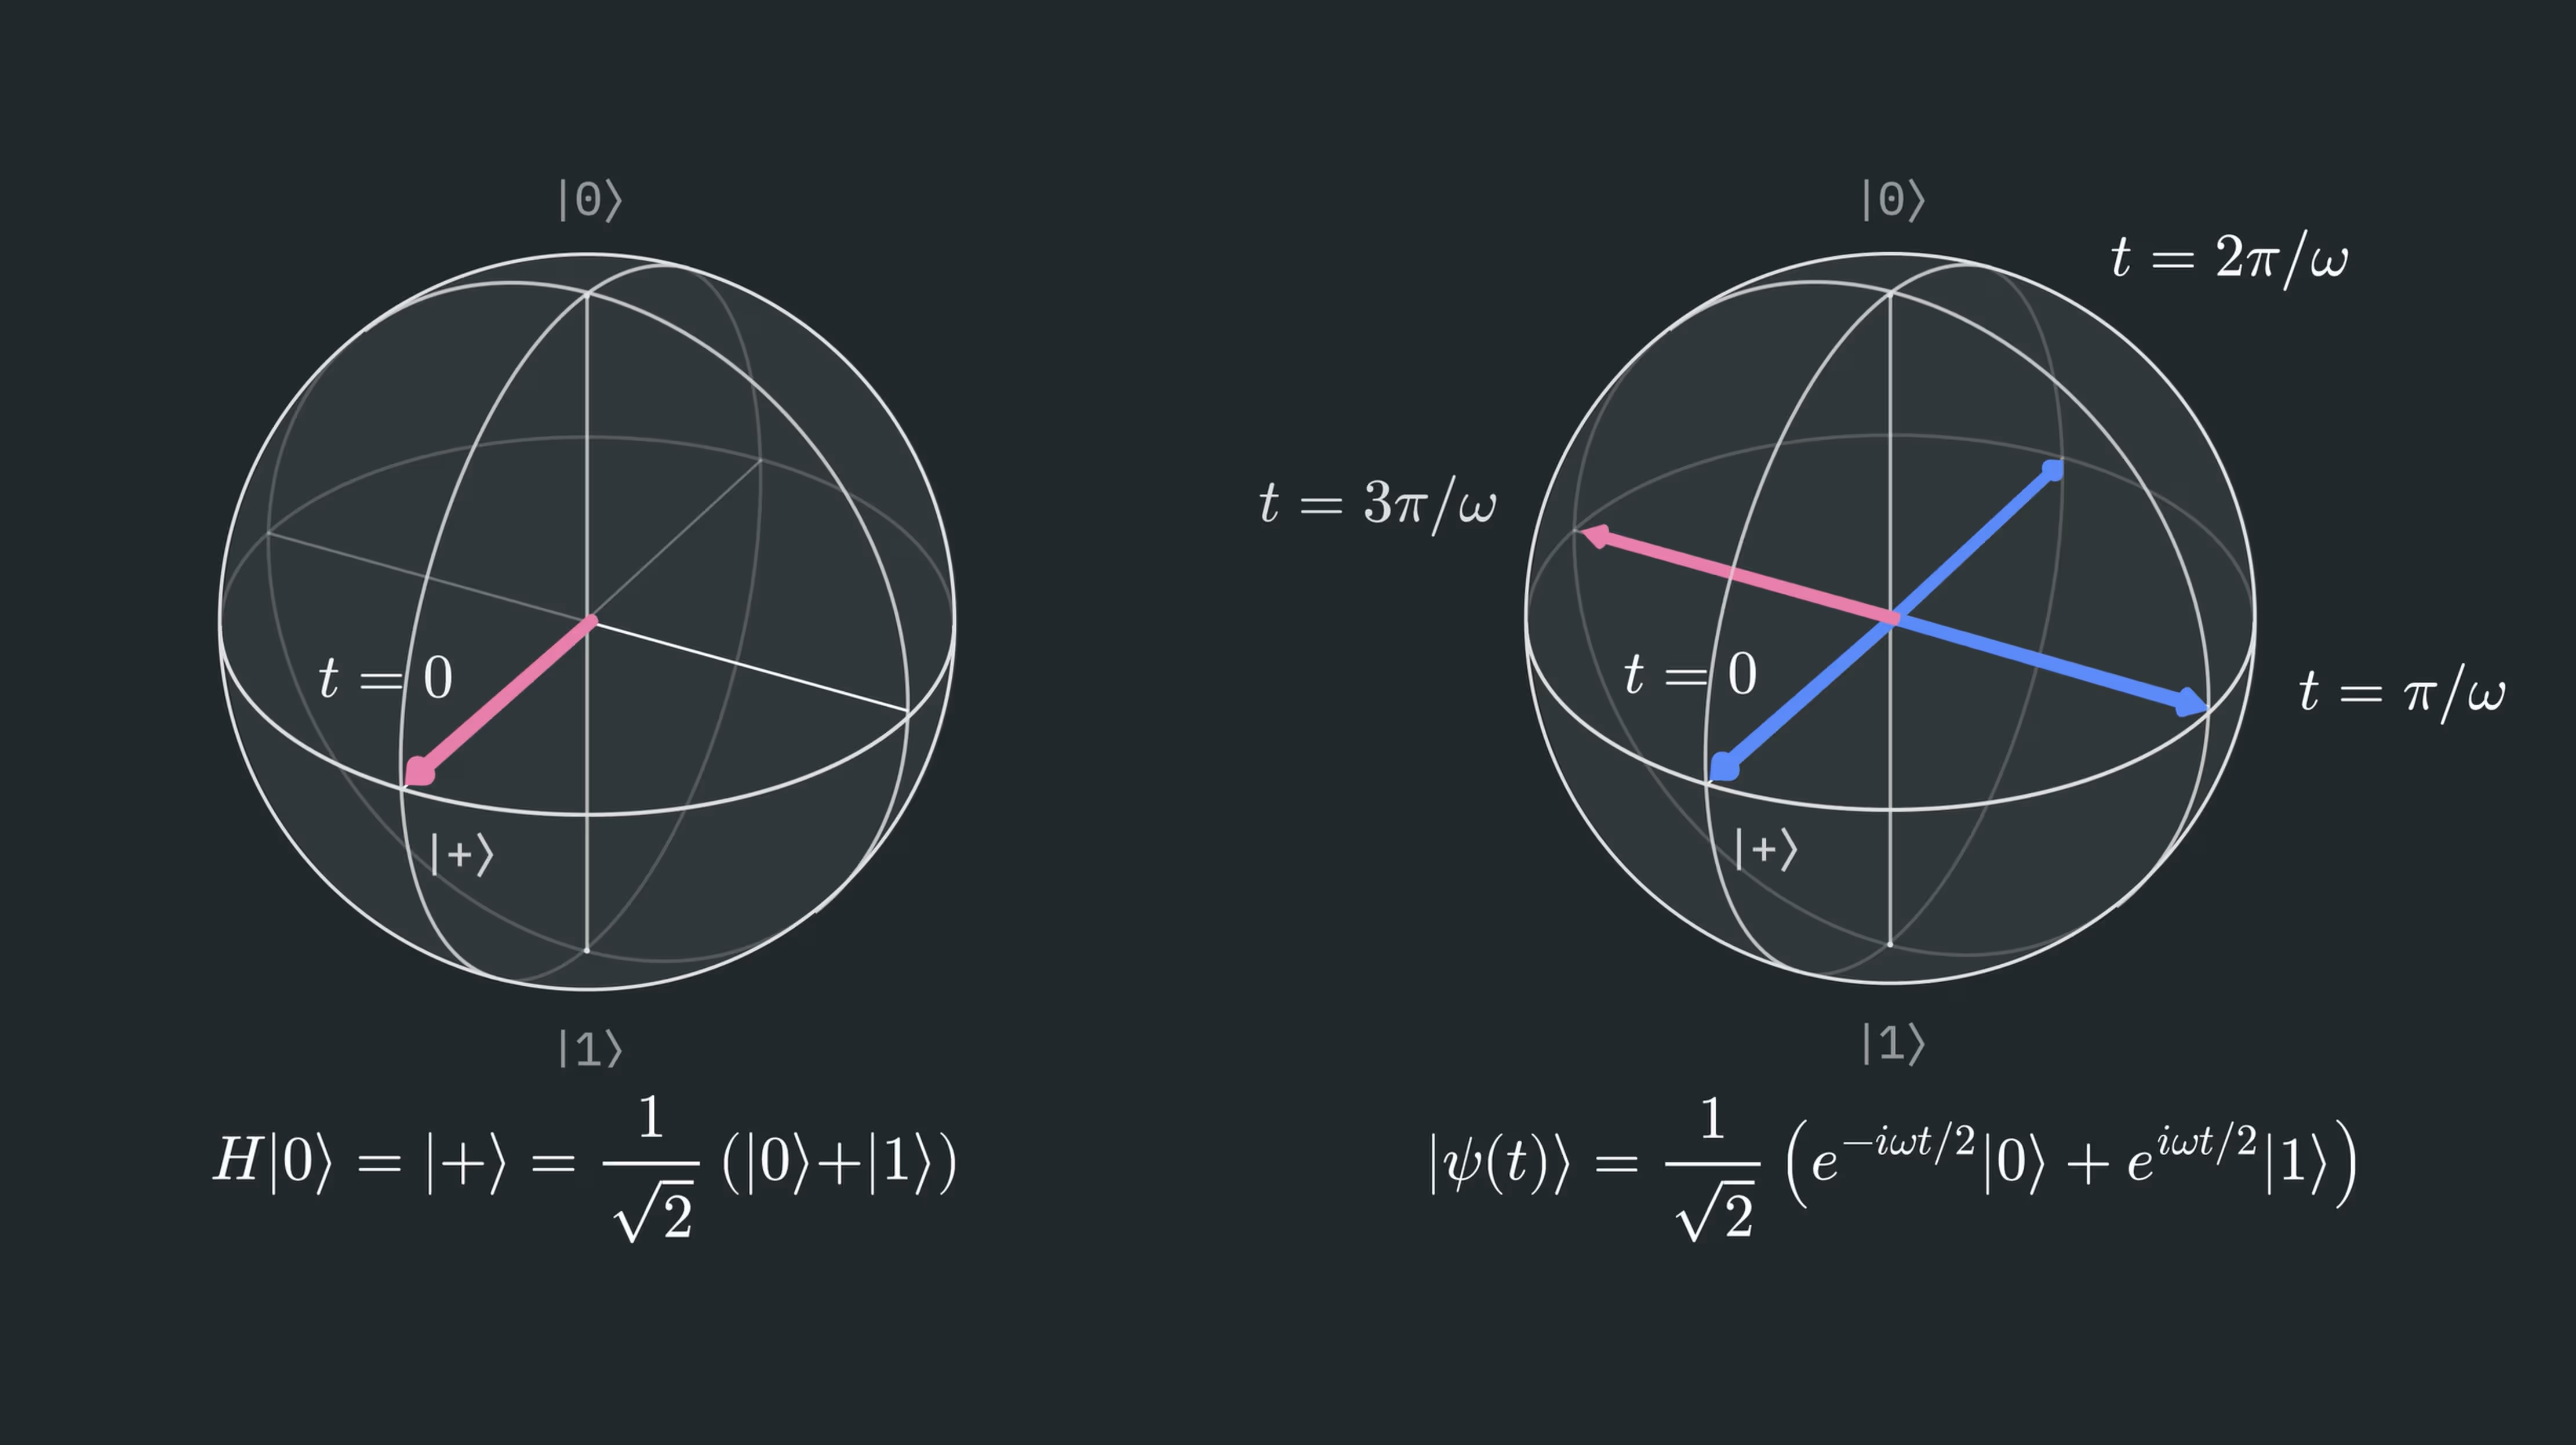
يمكن أن تتسبب الضوضاء أو الاقتران البيئي في تغيير الطور النسبي بين حالات الأساس. أي أن احتمالات و لا تتغير، لأن القيم المطلقة لمعاملاتها لا تتغير. بل تتغير أطوار السعات، مما يغيّر مكوناتها الحقيقية والتخيلية. لجعل هذا النقاش أكثر تحديداً، لنعتبر نوعاً واحداً من التفاعل يمكن أن يسبب هذا: الاقتران بمجال مغناطيسي موجّه في اتجاه Z: .
لنعتبر ما يحدث للحالة مع مرور الوقت:
هنا استخدمنا حقيقة أن المجال المغناطيسي في اتجاه Z يسبب مبادرة (precession) حول محور Z بتردد يعتمد على العزم المغناطيسي الفعّال وشدة المجال المغناطيسي. التفاصيل أقل أهمية من حقيقة أن هذا التفاعل يسبب تطوراً حول محور Z، مما يؤدي إلى تراكم أطوار متعاكسة لحالتي الأساس الحاسوبيتين. بتطبيق هذا المؤثر على كل حد في ، نجد ما يلي:
يتوافق هذا الطور المعتمد على الزمن مع المبادرة حول محور Z في صورة كرة بلوخ. هذا موضح في النصف الأيمن من الشكل أعلاه.
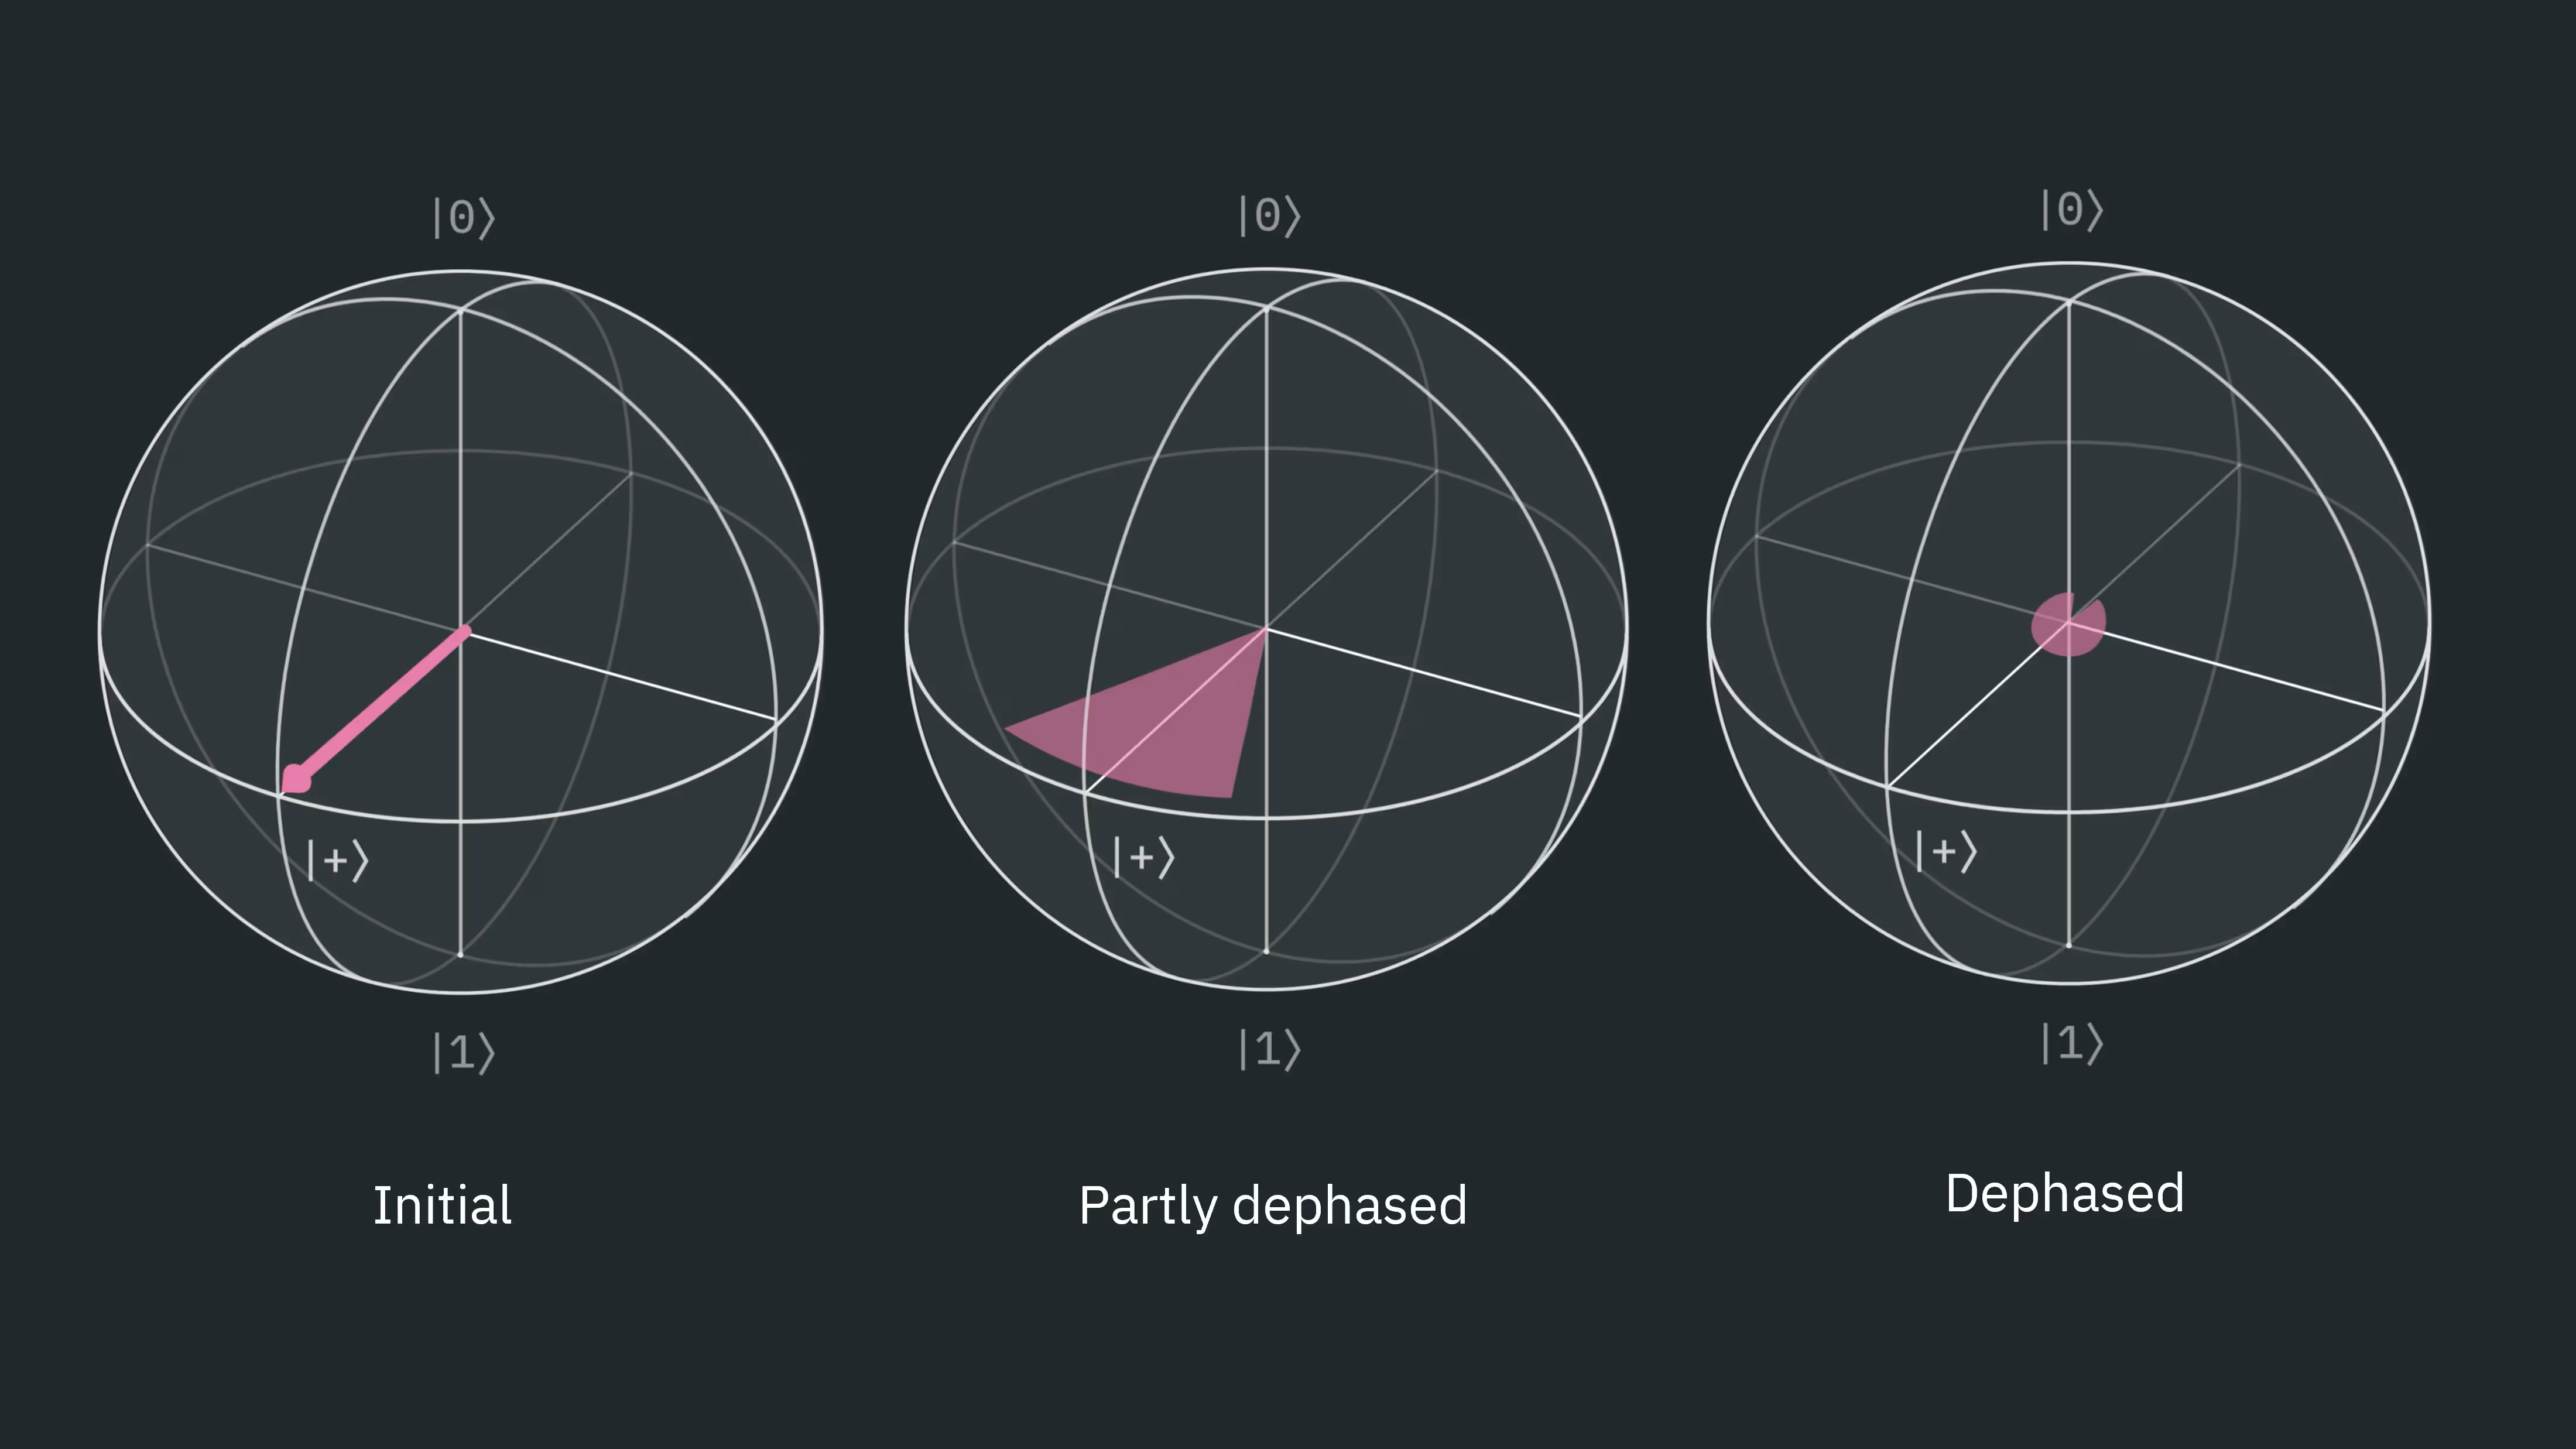
لو كنا نعلم أن هذا التفاعل يحدث بطريقة متحكم بها، لأمكننا التنبؤ به. لنمذجة هذا النوع من الضوضاء، ننظر بدلاً من ذلك في توزيع لقيم محتملة لشدة المجال المغناطيسي، تحدث كل منها باحتمال كلاسيكي معين (ستحتاج مصادر ضوضاء أخرى إلى نمذجة مختلفة). نحتاج إلى النظر فيما يحدث عندما يكون هناك احتمال كلاسيكي غير صفري بأن الحالة لم تدُر إطلاقاً، وأيضاً احتمال أنها دارت بمقدار صغير، أو حتى بمقدار كبير. هذا التوزيع للدورانات المحتملة هو سبب انتشار الحالة في صورة كرة بلوخ أدناه. إذا كان هناك المزيد من ضوضاء إزالة الطور هذه، سيكون الطور أقل تحديداً. في حد إزالة الطور القوية، يصبح الكيوبت مزال الطور بالكامل، مما يقابل فقدان التماسك الكمي المخزن في الحالة.
بالطبع، في تجربة ما لا فكرة لدينا عن الاقتران العشوائي الذي سيحدث. ماذا يمكننا أن نفعل حيال ذلك؟
لنفترض أن الاقتران البيئي يظل ثابتاً تقريباً خلال فترة زمنية . لنعتبر ما سيحدث لو اتبعنا هذه الوصفة:
-
اسمح للطور بالتغير لمدة
-
طبّق بوابة X على الكيوبت
-
اسمح لنفس الاقتران البيئي بالحدوث لفترة إضافية
-
طبّق بوابة X ثانية
بعد التطور الزمني الأولي، ستكون لدينا بالضبط الحالة أعلاه. بتطبيق بوابة X الأولى نحصل على:
الآن عندما تمر الفترة الثانية من ، يحدث نفس التفاعل. لكن الآن ترتبط السعات بحالات Z المعاكسة، مما يعني أن إشارة الدوران حول محور Z قد انعكست. بعد السماح للنظام بالتطور زمنياً لمدة أخرى نحصل على الحالة:
وبإدراج نحصل على:
تطبيق بوابة X الأخيرة لا يفعل شيئاً في هذه الحالة، لكنه ضروري عموماً:
لقد استعدنا الحالة الكمية الأصلية، بما في ذلك طورها النسبي. هذه العملية مثال بسيط للغاية على الفصل الديناميكي.
بشكل أعم، يتضمن الفصل الديناميكي (DD) إدراج بعض بوابات الكيوبت الواحد لتقليل تأثير التفاعلات مع أنظمة خارج الكيوبت (فصله عن البيئة). إن إعادة التركيز الكامل لجميع تاريخ الأطوار المحتملة إلى الحالة الأصلية، كما هو موضح أعلاه، مثالي إلى حد ما، لكنه لا يزال سيناريو ممكناً. دعنا نناقش متى يكون DD مفيداً وما هي التحذيرات الموجودة.
تحقق من فهمك
في النص أعلاه، مررنا بخطوات تأثير تسلسل DD من نوع XX على الحالة الابتدائية . تحقق مما إذا كانت نفس الخطوات أعلاه تعيد أيضاً الحالة إلى حالتها الابتدائية تحت نفس افتراضات المجال المغناطيسي بطيء التغير على طول اتجاه z.
الإجابة
بعد التطور الزمني الأولي، ستكون لدينا بالضبط الحالة أعلاه. بتطبيق بوابة X الأولى نحصل على:
الآن عندما تمر الفترة الثانية من ، يحدث نفس التفاعل. لكن الآن ترتبط السعات بحالات Z المعاكسة، مما يعني أن إشارة الدوران حول محور Z قد انعكست. بعد السماح للنظام بالتطور زمنياً لمدة أخرى نحصل على الحالة:
وبإدراج نحصل على
بتطبيق بوابة X الأخيرة، نحصل على:
متى نستخدم DD
التحذير الأول والأكثر وضوحاً هو أننا افترضنا قناة إزالة طور خالصة في معالجتنا. عادة ما تنتج التفاعلات الواقعية مزيجاً من إزالة الطور وآليات خطأ أخرى. في المعالجة أعلاه، اخترنا تطبيق بوابات X تحديداً. يُشار إلى هذا بتسلسل XX في الفصل الديناميكي. هذا التسلسل بالذات مناسب للأخطاء الخالصة من إزالة الطور. لكن هناك تسلسلات أخرى قد تكون أكثر قابلية للتطبيق على نطاق أوسع، مثل XY4 (موضح في مخطط الدائرة أدناه) وXY8 الأكثر تعقيداً.

تحذير آخر هو أن الفصل الديناميكي يضيف بوابات كيوبت واحد، والتي يمكن أن تضيف أخطاء كيوبت واحد بسبب عيوب البوابة أو حتى التداخل (crosstalk). عادة ما تكون معدلات أخطاء الكيوبت الواحد هذه أقل بكثير من أخطاء بوابات متعددة الكيوبتات، لذا هذا عادة ليس مصدر قلق كبير، لكنه شيء يجب مراعاته إذا كانت كيوبتات كثيرة تستخدم DD مرات عديدة عبر دائرتك.
يكون DD مفيداً عندما يكون للاقتران الخارجي وقت للتأثير على حالة الكيوبت. لأن الكيوبتات معزولة جيداً بعناية فائقة وينبغي أن تكون الاقترانات الخارجية ضعيفة، فإن هذا النوع من الضوضاء يكون ألحظ عندما يبقى الكيوبت خاملاً لفترات طويلة. بالنسبة لأوقات الخمول القصيرة، قد يكون تأثير DD هو إضافة أخطاء بوابة كيوبت واحد مع قمع ضوضاء قليلة جداً؛ وقد تنخفض بالفعل دقة دائرتك.
النقطة الأساسية: استخدم الفصل الديناميكي عندما تبقى الكيوبتات خاملة لفترات طويلة بما يكفي، وانتبه إلى نوع تسلسل DD المستخدم.
الفصل الديناميكي باستخدام Qiskit
لنستكشف استخدام DD من خلال دراسة حالة عدة كيوبتات مُحضّرة في حالة ، والتي تبقى بعد ذلك خاملة لفترة طويلة. في غياب الأخطاء، ينبغي أن يؤدي تحضير حالة متعددة الكيوبتات ثم تطبيق بوابة هادامارد قبل القياس (وبالتالي القياس في أساس X) دائماً إلى نتيجة 0. مع الضوضاء، ستكون نتيجة القياس 0 فقط في جزء من الوقت بدلاً من باحتمال 100%. نحسب متوسط قيمة توقع X عبر كيوبتات متعددة. أي أننا مهتمون بما يلي:
حيث مع مؤثر X في الموضع من اليمين و هي حالة النظام بأكمله.
تحتوي هذه الدائرة على تأخيرات متعمدة، وهو ما يُعد افتعالياً إلى حد ما لمعيار قياسي. لكن من الشائع جداً أن تحتوي الدوائر الحقيقية على كيوبتات تبقى خاملة أثناء جزء من التنفيذ. يمكنك اعتبار هذا نموذجاً مبسطاً لدائرة أكثر تعقيداً تبقى فيها بعض الكيوبتات خاملة لجزء من الحساب. غالباً ما يُشار إلى هذا النوع من القياس المرجعي المبني على تطور حالات باسم قياس رامزي المرجعي.
نبدأ بتحميل الحزم اللازمة وتهيئة الخدمة.
# Added by doQumentation — required packages for this notebook
!pip install -q matplotlib numpy qiskit qiskit-aer qiskit-ibm-runtime
# Load key packages

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime import SamplerV2 as Sampler
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager
from qiskit import QuantumRegister, ClassicalRegister, QuantumCircuit
import numpy as np

# --------- Configuration ----------

service = QiskitRuntimeService()  # assumes credentials are saved
backend = service.backend("ibm_fez")  # adjust if needed
الآن نحدد بعض دوال المساعدة. أولاً، نريد معالجة نقطة أوقات الخمول الطويلة. ماذا تعني "طويلة" بالضبط في هذا السياق؟ يمكننا ببساطة الإبلاغ عن وقت الخمول بالميكروثانية. لكن من المفيد معرفة عدد بوابات الكيوبتين التي يمكن تنفيذها خلال نفس الفترة. هذا يجعل أوقات الخمول أكثر دلالة مباشرة على عمق الدائرة الذي كان يمكن تنفيذه خلال نفس الفترة. تحصل دالة المساعدة الأولى على بوابة الكيوبتين الأصلية للـ backend وتحدد مدة تلك البوابة.
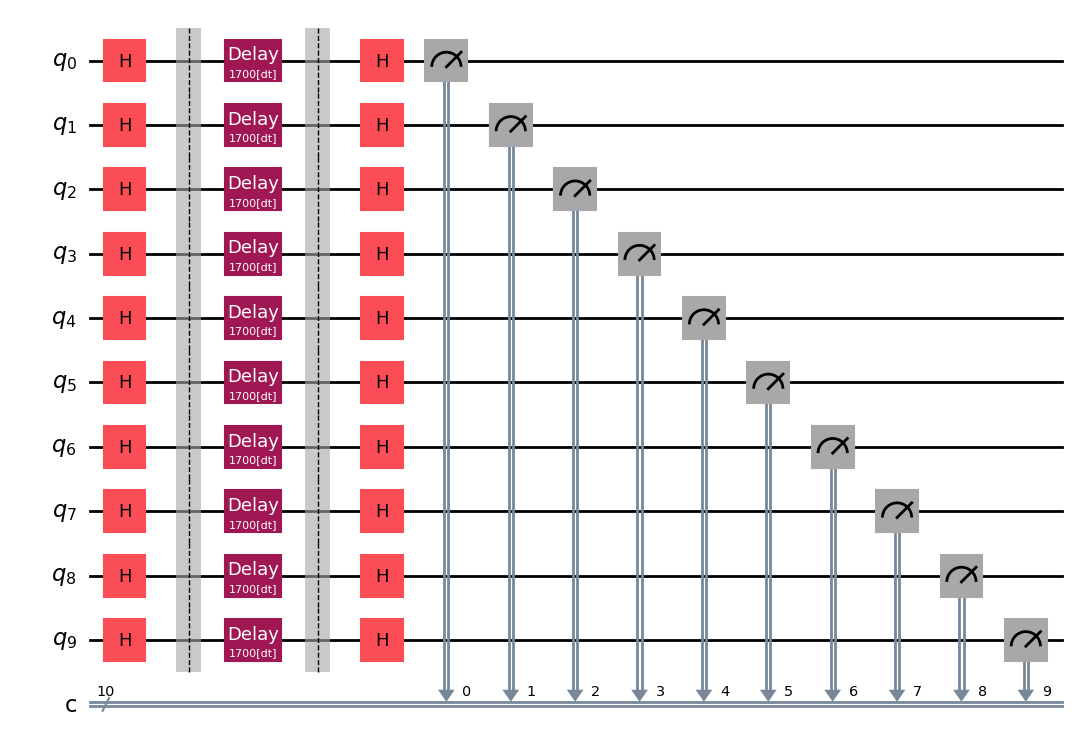
تنشئ الدالة الثانية ببساطة دائرة رامزي (واحدة بكيوبتات في حالة )، وتنفذ تأخيراً، وتدور باستخدام بوابة H، ثم تقيس. تذكر أن بوابة هادامارد (H) تحوّل إلى ، لذا فإن قياس في أساس Z بعد هادامارد يتوافق مع كون الكيوبت في مباشرة قبل هادامارد.
تحوّل دالتنا الأخيرة العدّات الخام لنتائج قياس 0 و1 إلى قيمة توقع لـ X.
from typing import Tuple
from qiskit.providers import Backend
from numpy.typing import NDArray

# --------- Utilities ----------
def detect_twoq_gate_and_duration(
    backend: Backend, pair: tuple[int, int] = (0, 1)
) -> Tuple[str, float]:
    props = backend.properties()
    candidates = ["cx", "ecr", "cz"]
    for name in candidates:
        try:
            dur = props.gate_length(name, list(pair))
            if dur is not None:
                return name, dur
        except Exception:
            pass
    raise RuntimeError(
        "Could not find a two-qubit gate duration among cx/ecr/cz on this backend."
    )

def make_multiqubit_ramsey_circuit(n: int, delay_dt_ticks: int) -> QuantumCircuit:
    q = QuantumRegister(n, "q")
    c = ClassicalRegister(n, "c")
    qc = QuantumCircuit(q, c)

    qc.h(q)
    qc.barrier()

    for i in range(n):
        qc.delay(delay_dt_ticks, q[i], unit="dt")
    qc.barrier()

    qc.h(q)
    qc.measure(q, c)
    return qc

def counts_to_x_expectations(counts: dict[str, int], n: int) -> NDArray[np.float64]:
    total = sum(counts.values())
    if total == 0:
        return np.zeros(n)

    p0 = np.zeros(n, dtype=float)
    for bitstring, cnt in counts.items():
        bits_rev = bitstring[::-1]
        for i in range(n):
            if bits_rev[i] == "0":
                p0[i] += cnt
    p0 /= total
    return 2.0 * p0 - 1.0
الآن نحدد تفاصيل اختبارنا، بما في ذلك عدد الكيوبتات وتسلسل البوابات المراد استخدامه في DD (في هذه الحالة XX). لاحظ بشكل خاص أننا نضبط مستوى التحسين إلى صفر. في الممارسة العملية، غالباً ما تختار مستوى تحسين أعلى؛ هنا نستخدم المستوى 0 لضمان بقاء تأثيرات الأخطاء المستهدفة بواسطة DD مرئية. أخيراً، نحدد الزمن المميز لبوابات الكيوبتين على هذا الـ backend ونطبع بعض الأوقات ذات الصلة.
n_qubits = 10  # number of qubits to test in parallel
shots = 4096
opt_level = 0  # we want to ignore optimization for now
num_steps = 6  # number of delay points
gates_per_step = 20  # "equivalent 2q gates" per step
dd_sequence = "XX"  # "XX" for your request; you might try "XY4" too

# --------- Derive timing: dt and 2q gate time ----------
dt = backend.dt  # seconds per dt
twoq_name, t2q = detect_twoq_gate_and_duration(backend, (0, 1))  # seconds
delay_unit_dt = int(round(t2q / dt))  # dt ticks equivalent to one 2q gate

print(f"Backend: {backend.name}")
print(f"dt = {dt*1e9:.3f} ns per tick")
print(f"Using 2q gate '{twoq_name}' with duration ~ {t2q*1e9:.1f} ns")
print(f"One 2q gate ≈ {delay_unit_dt} dt ticks")
Backend: ibm_fez
dt = 4.000 ns per tick
Using 2q gate 'cz' with duration ~ 68.0 ns
One 2q gate ≈ 17 dt ticks
الآن نبني دوائرنا ونحولها (transpile) للـ backend الذي اخترناه.
# --------- Build circuits for a sweep of delays ----------
pm = generate_preset_pass_manager(optimization_level=opt_level, backend=backend)

equiv_gates_list = [
    j * gates_per_step for j in range(num_steps)
]  # e.g., 0, 100, 200, ...
delay_dt_list = [int(round(delay_unit_dt * m)) for m in equiv_gates_list]
delay_us_list = [(dt * d) * 1e6 for d in delay_dt_list]  # for printing/plotting

circuits = []
for delay_dt in delay_dt_list:
    qc = make_multiqubit_ramsey_circuit(n_qubits, delay_dt)
    qc_isa = pm.run(qc)  # ISA-level scheduling/placement; DD is handled at runtime
    circuits.append(qc_isa)

print("Delay sweep (approx microseconds):", [f"{t:.2f}" for t in delay_us_list])
Delay sweep (approx microseconds): ['0.00', '1.36', '2.72', '4.08', '5.44', '6.80']
ينبغي أن نتصور دائرة واحدة على الأقل للتأكد من أننا رمّزنا دائرتنا بالحالات والتأخيرات المرغوبة. قد يكون من الأسهل تصور الدائرة قبل التحويل qc، أو يمكنك التحقق من الدائرة المحولة qc_isa.
qc.draw("mpl")
التنفيذ
نحن أخيراً جاهزون للتنفيذ على العتاد. نستخدم Sampler للحصول على قياسات عديدة لكل كيوبت، وسنستخدمه مرتين: مرة مع إيقاف DD صراحةً، ومرة مع تفعيل DD باستخدام تسلسل البوابات XX.
# --------- Run: NO DD ----------
sampler = Sampler(mode=backend)
sampler.options.default_shots = shots
sampler.options.dynamical_decoupling.enable = False

job = sampler.run(circuits)
res_nodd = job.result()
job_id = job.job_id()  # job id for dd off/false
print("job number for no dd is ", job_id)

# --------- Run: WITH DD (XX) ----------
sampler = Sampler(mode=backend)
sampler.options.default_shots = shots
sampler.options.dynamical_decoupling.enable = True
sampler.options.dynamical_decoupling.sequence_type = (
    dd_sequence  # "XX" first; you can try "XY4" too
)
sampler.options.dynamical_decoupling.scheduling_method = "alap"
sampler.options.dynamical_decoupling.extra_slack_distribution = "middle"

job = sampler.run(circuits)
res_dd = job.result()
job_id = job.job_id()  # job id for dd on/XX
print("job number for dd using XX is ", job_id)
يمكننا استخراج العدّات من الدوائر المختلفة.
# --------- Extract counts per circuit ----------

from typing import Iterable, Any

def extract_counts_list(res: Iterable[Any]) -> list[dict[str, int]]:
    counts_list: list[dict[str, int]] = []

    for r in res:  # each r corresponds to one circuit
        counts: dict[str, int] = r.data.c.get_counts()
        counts_list.append(counts)

    return counts_list

counts_list_nodd = extract_counts_list(res_nodd)
counts_list_dd = extract_counts_list(res_dd)
المعالجة اللاحقة
لدينا الآن العدّات من القياس، لكننا نريد تحويلها إلى قيمة توقع لـ X ثم حساب متوسط قيم التوقع هذه عبر جميع الكيوبتات التي استخدمناها، لمعرفة مدى الحفاظ على معلومات الطور. لذلك نستخدم دالتنا counts_to_x_expectations المعرّفة سابقاً.
# --------- Compute X-expectations and a scalar contrast ----------
# For each circuit (each delay), compute per-qubit <X> and average absolute contrast.

xexp_nodd = []
xexp_dd = []
contrast_nodd = []
contrast_dd = []

for counts in counts_list_nodd:
    x_vec = counts_to_x_expectations(counts, n_qubits)
    xexp_nodd.append(x_vec)
    contrast_nodd.append(float(np.mean(np.abs(x_vec))))  # average |<X>| across qubits

for counts in counts_list_dd:
    x_vec = counts_to_x_expectations(counts, n_qubits)
    xexp_dd.append(x_vec)
    contrast_dd.append(float(np.mean(np.abs(x_vec))))

# --------- Print a small summary ----------
print("\n=== Summary (average |<X>| per delay) ===")
for m, d_us, c0, c1 in zip(equiv_gates_list, delay_us_list, contrast_nodd, contrast_dd):
    print(
        f"Delay ~ {m:4d} * {twoq_name}  (~{d_us:7.2f} µs):  NoDD={c0: .3f},  DD({dd_sequence})={c1: .3f}"
    )

# Optionally, inspect per-qubit values for the last delay point
print("\nPer-qubit <X> (abs) at the longest delay:")
print("NoDD:", np.round(np.abs(xexp_nodd[-1]), 3))
print("DD  :", np.round(np.abs(xexp_dd[-1]), 3))
=== Summary (average |<X>| per delay) ===
Delay ~    0 * cz  (~   0.00 µs):  NoDD= 0.954,  DD(XX)= 0.961
Delay ~   20 * cz  (~   1.36 µs):  NoDD= 0.827,  DD(XX)= 0.927
Delay ~   40 * cz  (~   2.72 µs):  NoDD= 0.793,  DD(XX)= 0.900
Delay ~   60 * cz  (~   4.08 µs):  NoDD= 0.729,  DD(XX)= 0.876
Delay ~   80 * cz  (~   5.44 µs):  NoDD= 0.661,  DD(XX)= 0.854
Delay ~  100 * cz  (~   6.80 µs):  NoDD= 0.586,  DD(XX)= 0.826

Per-qubit <X> (abs) at the longest delay:
NoDD: [0.05  0.744 0.712 0.867 0.844 0.234 0.473 0.755 0.59  0.587]
DD  : [0.583 0.89  0.921 0.88  0.908 0.832 0.893 0.773 0.807 0.773]
أخيراً، لنرسم نتائجنا.
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values with no DD
ax.scatter(
    equiv_gates_list, contrast_nodd, c="blue", linestyle="-", label="No DD", alpha=0.7
)

## Add values with DD
ax.scatter(
    equiv_gates_list, contrast_dd, c="red", linestyle="-", label="With DD", alpha=0.7
)

# Add labels and plot
ax.set_xlabel("Idle Time in # of 2-qubit gates")
ax.set_ylabel("<X>")
ax.legend()
ax.set_title("Dephasing and DD")
ax.grid(True)

plt.show()
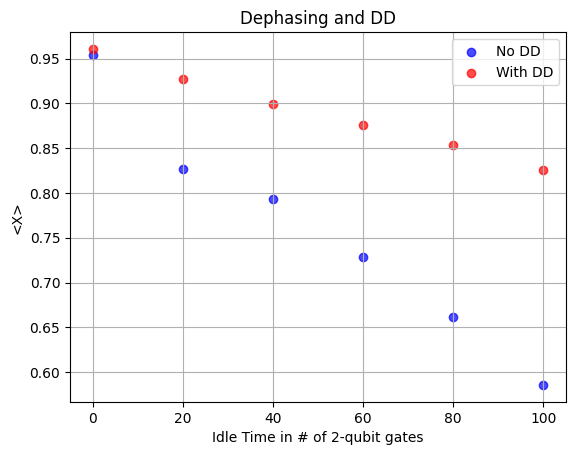
كما ترى، بدون تأخير صريح تكون قيم التوقع بالفعل قريبة من 1، وهو ما نتوقعه إذا تم الحفاظ على جميع معلومات الطور. إذا فُقدت جميع معلومات الطور، فلن يكون هناك أي تفضيل للدوران النهائي لإنتاج بدلاً من ، وستقترب قيمة التوقع المتوسطة من الصفر. في البيانات، نرى أنه مع زيادة أوقات التأخير، تنخفض قيمة التوقع المتوسطة لـ X، بدءاً بالاقتراب من الصفر. لاحظ أن DD كان فعّالاً جداً هنا؛ عادة ما تكون قيم التوقع مع DD أفضل بأكثر من 20% (أقرب إلى 1) من القيم بدون DD. لكن لاحظ أيضاً أن أول نقطة بيانات مؤخرة تتوافق مع تأخير يعادل تقريباً 100 عملية بوابة كيوبتين. هذا يعزز النقطة القائلة بأن DD أكثر فائدة عندما تبقى الكيوبتات خاملة لفترات طويلة نسبياً.
تحقق من فهمك
إذا طبقنا DD باستخدام XY4 على نفس الدائرة كما من قبل، هل تتوقع أن تعطي نتائج أفضل بكثير، أو أسوأ بكثير، أو مماثلة تقريباً، مقارنة بـ DD باستخدام XX؟ اشرح.
الإجابة
مماثلة تقريباً، ربما أسوأ قليلاً. كانت للدائرة التي استخدمناها حالات مُدارة إلى مستوى XY. تخزن هذه الحالة المعلومات بشكل أساسي في طورها، مما يجعلها حساسة بشكل خاص لأخطاء إزالة الطور بدلاً من استرخاء T1. قد يساعد XY4 مع مجموعة أوسع من الأخطاء، لكن XX محسّن بالفعل ليساعد الدائرة التي نستخدمها. قد يكون XY4 جيداً بنفس القدر، لكنه لن يضيف شيئاً جوهرياً، أو قد تسمح حقيقة أن XY4 يحتوي على بوابات أكثر بجعل أخطاء بوابات إضافية تجعل النتائج أسوأ قليلاً.
استخدمت النتيجة الأخيرة أبسط تسلسل بوابات DD وهو XX. لنرى كيفية تنفيذ تسلسل أكثر تعقيداً، XY4. نحدد Sampler في القسم التالي.
# --------- Run: WITH DD (XY4) ----------
dd_sequence = "XY4"

sampler = Sampler(mode=backend)
sampler.options.default_shots = shots
sampler.options.dynamical_decoupling.enable = True
sampler.options.dynamical_decoupling.sequence_type = dd_sequence
sampler.options.dynamical_decoupling.scheduling_method = "alap"
sampler.options.dynamical_decoupling.extra_slack_distribution = "middle"

job = sampler.run(circuits)
res_xy4 = job.result()
job_id = job.job_id()  # job id for dd on/XY4
print("job number for dd using Xy4 is ", job_id)
job number for dd using Xy4 is d6k6ti860irc7395d3hg
# --------- Extract counts per circuit ----------

counts_list_xy4 = extract_counts_list(res_xy4)
# --------- Compute X-expectations and a scalar contrast ----------
# For each circuit (each delay), compute per-qubit <X> and average absolute contrast.
xexp_xy4 = []
contrast_xy4 = []

for counts in counts_list_xy4:
    x_vec = counts_to_x_expectations(counts, n_qubits)
    xexp_xy4.append(x_vec)
    contrast_xy4.append(float(np.mean(np.abs(x_vec))))  # average |<X>| across qubits

# --------- Print a small summary ----------
print("\n=== Summary (average |<X>| per delay) ===")
for m, d_us, c0, c1, c2 in zip(
    equiv_gates_list, delay_us_list, contrast_nodd, contrast_dd, contrast_xy4
):
    print(
        f"Delay ~ {m:4d} * {twoq_name}  (~{d_us:7.2f} µs):  NoDD={c0: .3f},  DD({dd_sequence})={c1: .3f}"
    )

# Optionally, inspect per-qubit values for the last delay point
print("\nPer-qubit <X> (abs) at the longest delay:")
print("NoDD:", np.round(np.abs(xexp_nodd[-1]), 3))
print("DD XX :", np.round(np.abs(xexp_dd[-1]), 3))
print("DD XY4 :", np.round(np.abs(xexp_xy4[-1]), 3))
=== Summary (average |<X>| per delay) ===
Delay ~    0 * cz  (~   0.00 µs):  NoDD= 0.968,  DD(XY4)= 0.968
Delay ~  100 * cz  (~   6.80 µs):  NoDD= 0.612,  DD(XY4)= 0.839
Delay ~  200 * cz  (~  13.60 µs):  NoDD= 0.462,  DD(XY4)= 0.705
Delay ~  300 * cz  (~  20.40 µs):  NoDD= 0.339,  DD(XY4)= 0.580
Delay ~  400 * cz  (~  27.20 µs):  NoDD= 0.225,  DD(XY4)= 0.481
Delay ~  500 * cz  (~  34.00 µs):  NoDD= 0.204,  DD(XY4)= 0.393

Per-qubit <X> (abs) at the longest delay:
NoDD: [0.002 0.208 0.447 0.034 0.286 0.306 0.322 0.044 0.163 0.232]
DD XX : [0.433 0.669 0.526 0.516 0.572 0.284 0.303 0.055 0.365 0.208]
DD XY4 : [0.38  0.662 0.521 0.538 0.621 0.252 0.353 0.038 0.239 0.073]
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values with no DD
ax.scatter(
    equiv_gates_list, contrast_nodd, c="blue", linestyle="-", label="No DD", alpha=0.7
)

## Add values with DD using XX sequence
ax.scatter(
    equiv_gates_list, contrast_dd, c="red", linestyle="-", label="With XX", alpha=0.7
)

## Add values with DD using XY4 sequence
ax.scatter(
    equiv_gates_list,
    contrast_xy4,
    c="black",
    linestyle="-",
    label="With XY4",
    alpha=0.7,
)

# Add labels and plot
ax.set_xlabel("Idle Time in # of 2-qubit gates")
ax.set_ylabel("<X>_av")
ax.legend()
ax.set_title("Dephasing and DD")
ax.grid(True)

plt.show()
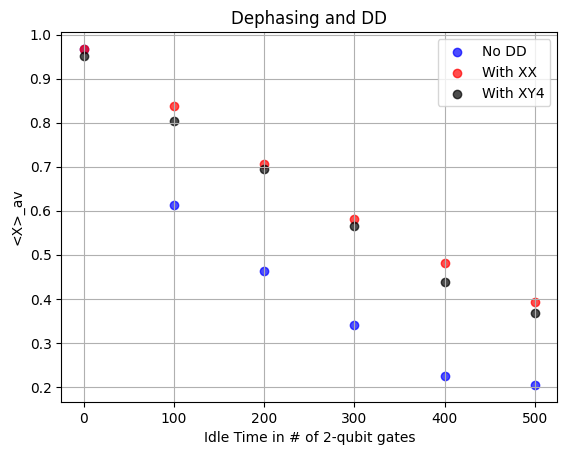
نرى هنا أن XY4 ليس مختلفاً بشكل ملحوظ عن XX. قد يكون أسوأ قليلاً جداً بسبب البوابات الإضافية في تسلسل XY4، لكن الأهم أننا شرحنا بالفعل لماذا سيكون لـ XX التأثير المرغوب في الحفاظ على الطور تحديداً لحالة مثل . لا يوجد سبب للاعتقاد بأن تسلسلاً مختلفاً سيحسن النتائج لحالة ابتدائية كهذه.
تحقق من فهمك
تحقق من أن تسلسل XY4 يترك الحالة دون تغيير حتى طور شامل (global phase).
الإجابة
لف باولي
ينبغي أن نبدأ بملاحظة أن لف باولي غالباً ما يُستخدم ليس كتقنية قمع أخطاء، بل كتقنية تشكيل أخطاء: فهي تجعل الضوضاء/الأخطاء تتصرف بشكل مختلف، وأحياناً بشكل أكثر قابلية للتنبؤ، لتمكين طرق أخرى. رغم أن لف باولي لا يمنع الأخطاء، فقد يمنع تراكمها المتماسك.
في دائرة كمية، تتجمع مصادر مختلفة متعددة من الخطأ معاً. يمكن أن تتجمع الأخطاء بطرق مختلفة، وأبرزها بشكل متماسك و_بشكل غير متماسك_. يعني التراكم المتماسك للأخطاء أن الضوضاء أو التطبيقات غير المثالية تميل جميعها إلى دفع الأخطاء في نفس الاتجاه عبر طبقات وبوابات متعددة. مثال على ذلك هو الدوران الزائد المتماسك عند تطبيق بوابة دوران.
لنعتبر بوابة دوران مثالية، مثل ، التي تدور حول محور X بالضبط بمقدار . بالطبع، تنفيذ البوابة ليس مثالياً، وقد يكون الدوران الفعلي لتطبيق واحد، وقد يكون حتى أن لها نفس الإشارة دائماً، وربما متشابهة في المقدار عبر تطبيقات عديدة لـ . وبالتالي فإن التطبيق المتكرر لبوابات الدوران يمكن أن يؤدي إلى تراكم متماسك لهذه الدورانات الزائدة (أو الناقصة) العديدة، .
التراكم غير المتماسك للأخطاء هو العكس تماماً: أخطاء في اتجاهات عشوائية بإشارات عشوائية، بحيث لا تتداخل الأخطاء في طبقات مختلفة دائماً بشكل إضافي، بل أحياناً تلغي بعضها أو تجتمع بطريقة تربيعية. من الواضح أن الأخطاء غير المتماسكة تتراكم بشكل أبطأ من حيث التأثير الكلي على حالة الكيوبت. رسم بياني توضيحي لهذا موضح في الشكل أدناه. هذا تبسيط. الأخطاء الكمية الحقيقية ليست مقيدة بفضاء ديكارتي ثنائي الأبعاد؛ ولن تكون لجميع مساهمات الأخطاء نفس المقدار، وهناك تعقيدات أكثر. لكن الحدس وراء صورة كهذه مفيد: تميل الأخطاء المتماسكة إلى التراكم بشكل أسرع من الأخطاء غير المتماسكة.
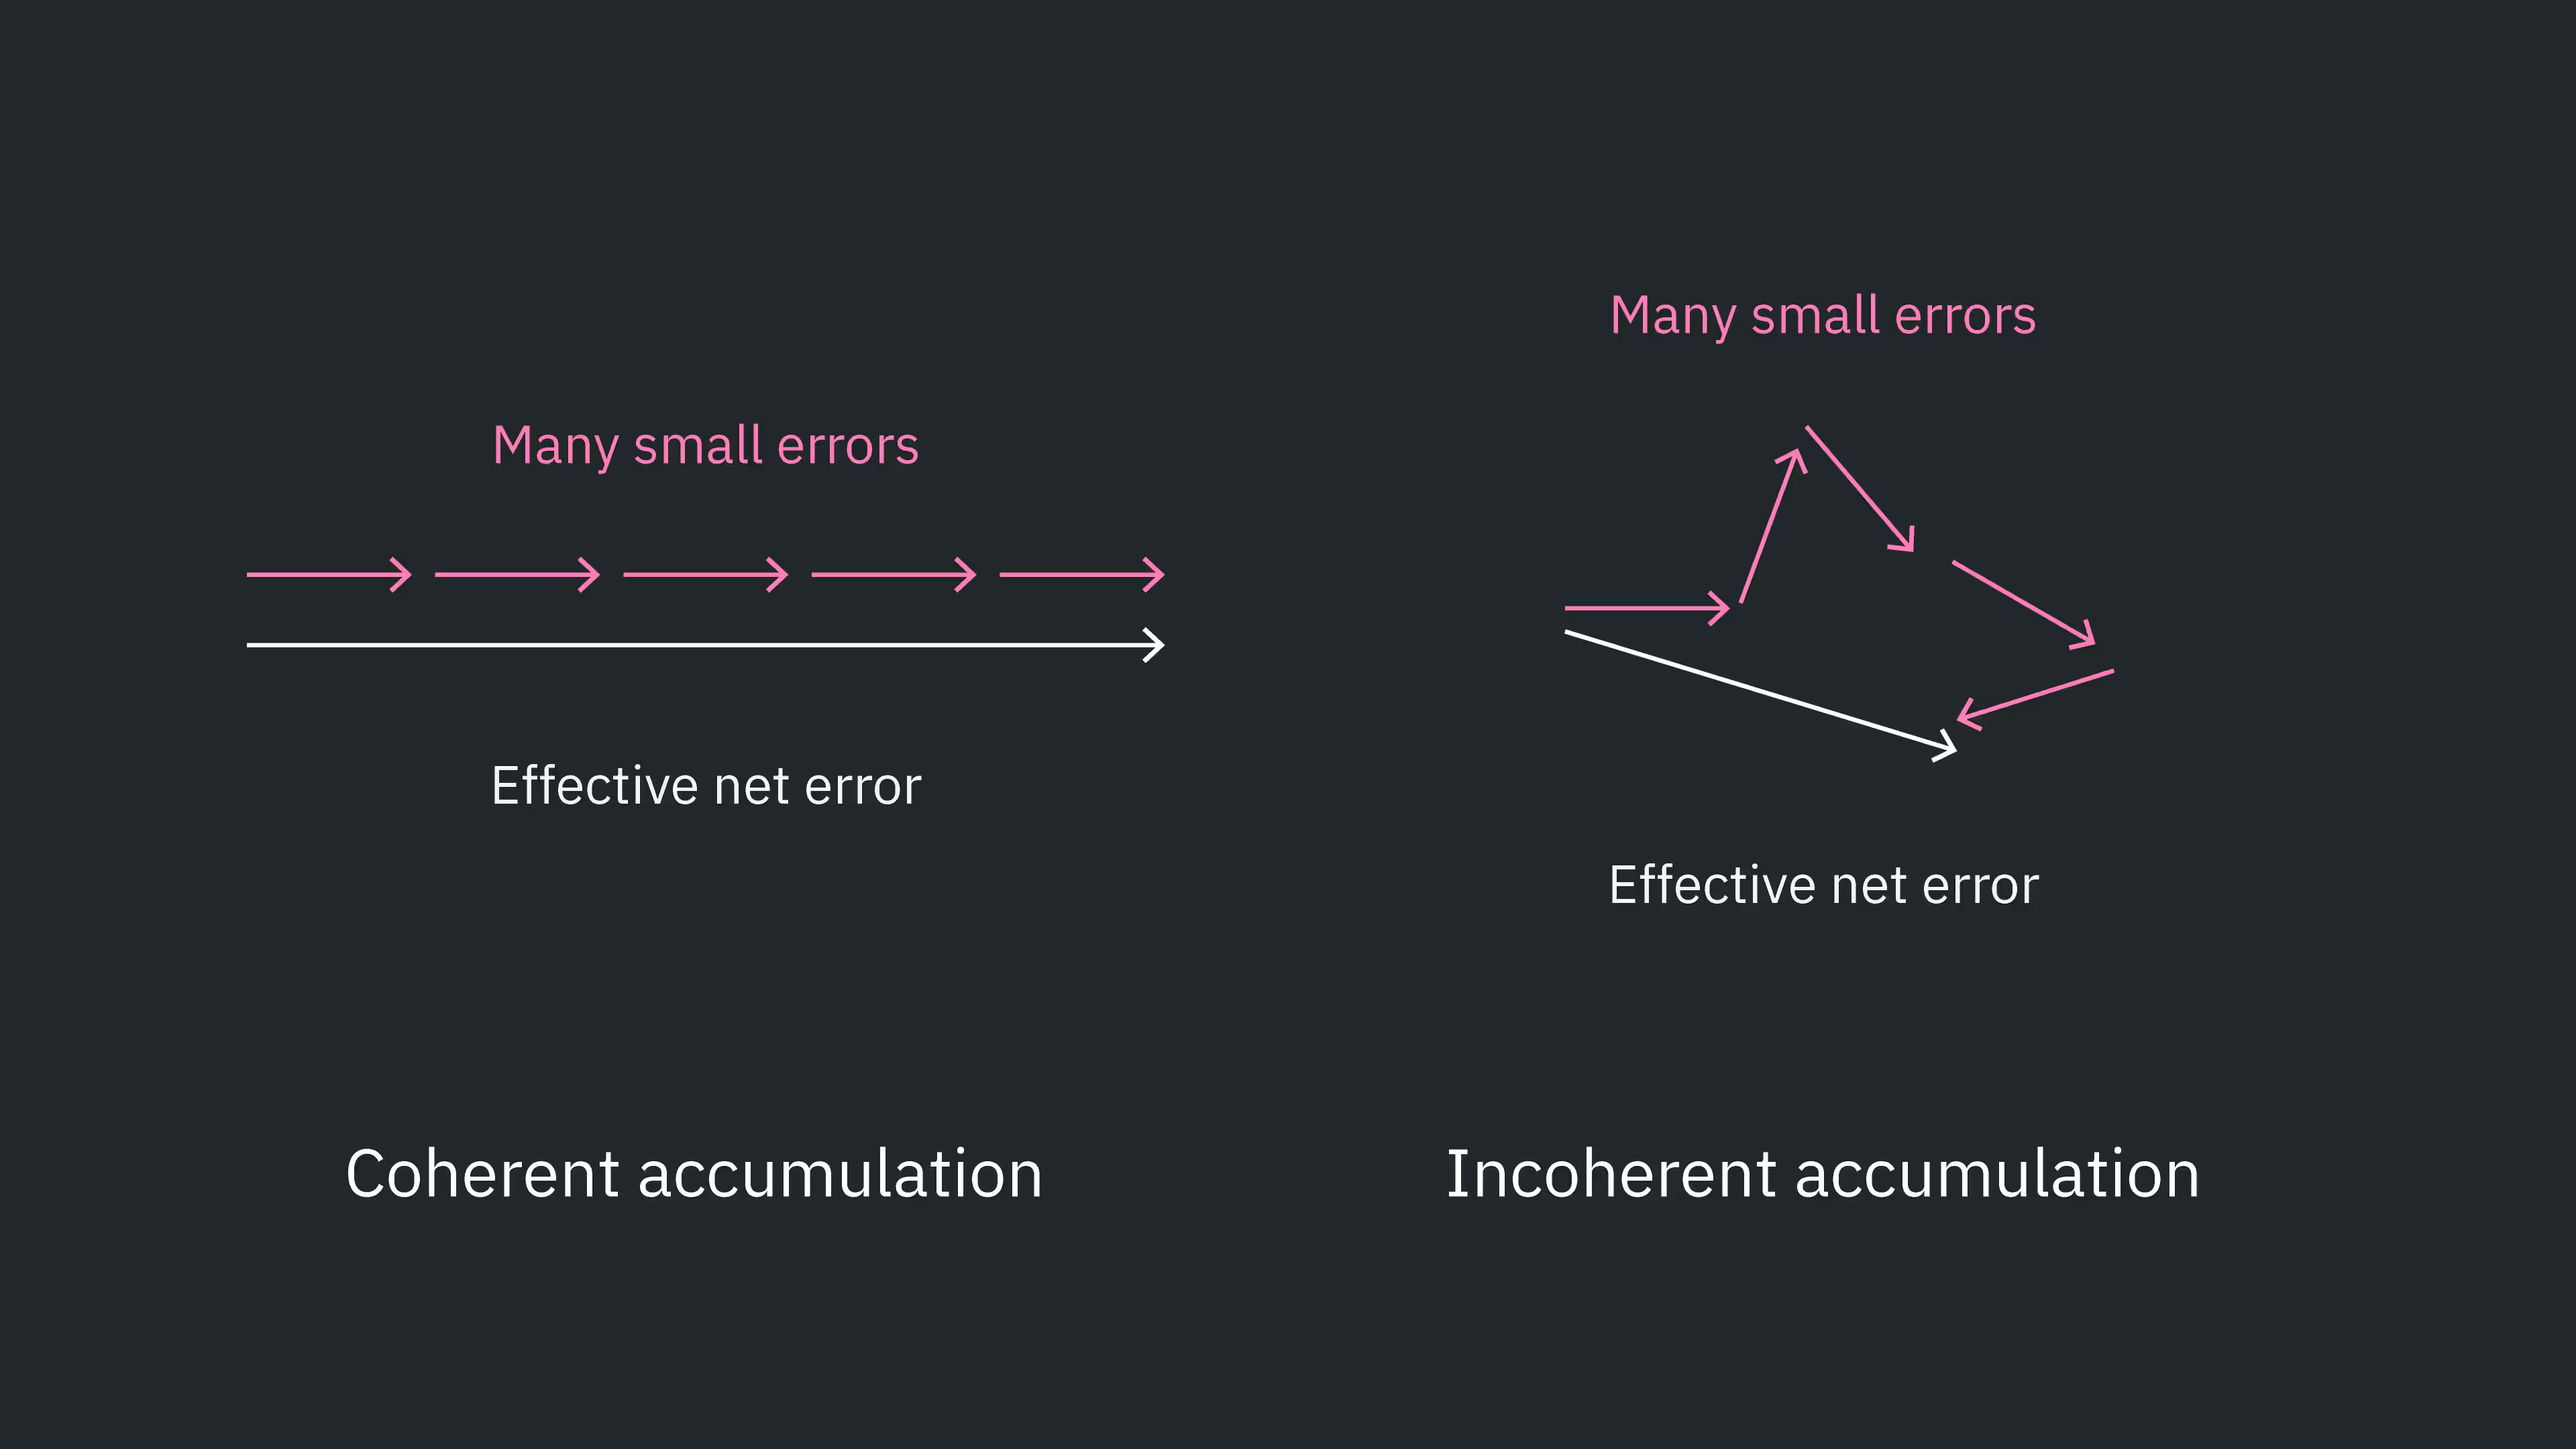
غالباً ما يمكن الحصول على نتائج بدقة أعلى عن طريق تحويل التراكم المتماسك للأخطاء إلى تراكم غير متماسك. الطريقة الرئيسية لتحقيق ذلك تسمى لف باولي.
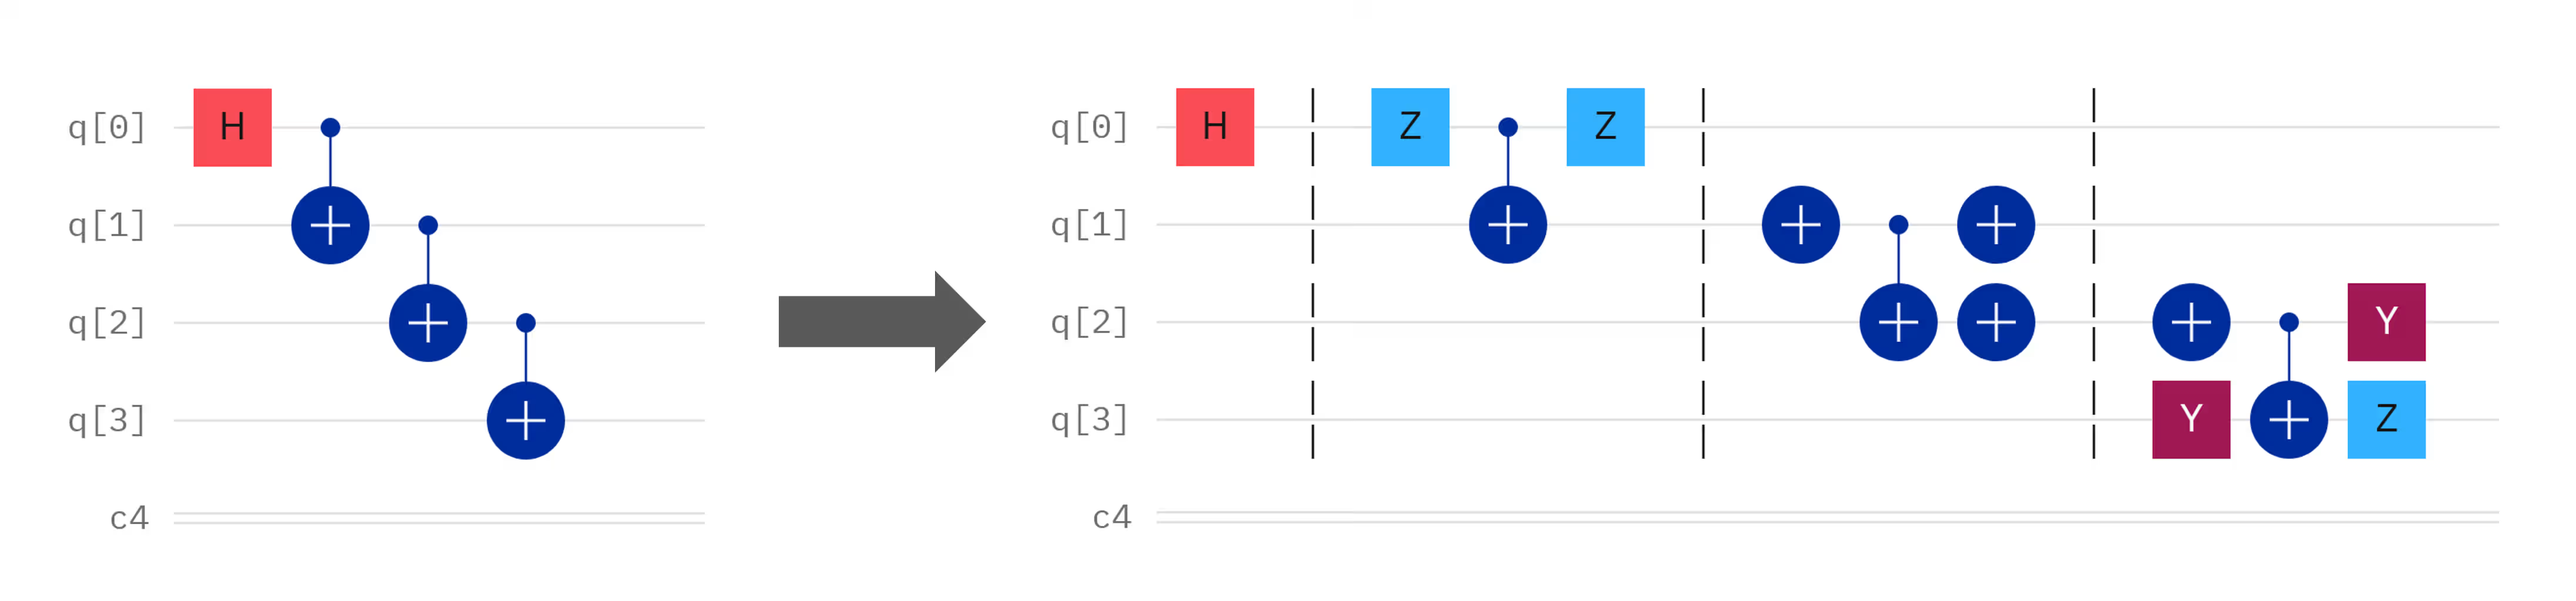
يشير لف باولي إلى إضافة تركيبات من بوابات باولي قبل وبعد عملية بوابة مرغوبة بطريقة تجعل . هنا، و ليستا بوابتي باولي منفردتين، بل مجموعات من مؤثرات باولي غالباً ما تعمل على كيوبتات متعددة. قد ترى أحياناً قولاً بأن تأثير بوابات باولي الإضافية "مكافئ للمؤثر المحايد (identity)". لكن هذا غير دقيق ومحتمل أن يكون مربكاً. تفصل بين بوابات باولي والهدف هو ترك التأثير المنطقي لجميع البوابات مساوياً لـ . أحياناً تُسمى بـ "الحمولة" (payload) لتمييز هذه العملية المقصودة عن البوابات المضافة للقمع. تُظهر بعض أمثلة لف باولي حول بوابة CNOT أدناه.

لنمر عبر مثال واحد فقط للتحقق من أن اللف يترك التأثير المنطقي للحمولة دون تغيير. دون فقدان العمومية، لتكن حالتا الكيوبتين المتضمنتين و هما:
كالعادة، نستخدم اصطلاح ترتيب الكيوبتات . بتطبيق بوابة CX مع كهدف نحصل على
الآن لنعتبر الدائرة الثالثة الموضحة، باستخدام بوابات X للف باولي. يمكننا ببساطة ضرب المصفوفات معاً والتحقق من أنها تعطي مصفوفة CNOT. بدلاً من ذلك، يمكننا تتبع العملية على حالة كمية اعتباطية عبر الدائرة، كما نفعل أدناه. تم تسمية الحالات في نقاط مختلفة من الدائرة من a إلى d.

هذا هو بالضبط الذي حصلنا عليه من قبل بدون لف. بالفعل، يترك تسلسل البوابات الملفوف هذا التأثير المنطقي للحمولة دون تغيير. لكن، إذا تم اختيار تسلسلات لف صالحة مختلفة عشوائياً من طبقة إلى أخرى، يمكن تحويل التراكم المتماسك للأخطاء إلى تراكم عشوائي (غير متماسك) بشكل فعّال. لتوضيح ذلك، لا يختار المرء نمط لف واحد ويستخدمه في جميع أنحاء الدائرة. بدلاً من ذلك، يتم اختيار تسلسلات لف صالحة مختلفة لطبقات مختلفة. قد يبدو مثال بطبقات تشابك عديدة كما يلي.
تحقق من فهمك
تحقق من أن لف باولي في اللوحة الرابعة في الشكل أعلاه يترك أيضاً التأثير المنطقي لـ CNOT دون تغيير.
الإجابة
نتبع المثال أعلاه ونوضح أن التأثير على أي حالة كيوبتين اعتباطية مكافئ لعملية CNOT. سنشير إلى النقاط الموسومة في هذا المخطط.

هذا مكافئ لتأثير CNOT مع الكيوبت 0 كتحكم والكيوبت 1 كهدف.
هل يمكنك ابتكار تسلسل لف باولي لبوابة CNOT لم يُعرض أعلاه؟
الإجابة
نعم، هناك أمثلة عديدة أخرى. أحدها هو قبل CNOT، و و بعد CNOT.
متى نستخدم لف باولي
كما هو مقدم هنا، يُطبق لف باولي فقط على البوابات متعددة الكيوبتات. تطبيق بروتوكول مماثل على بوابات كيوبت واحد سيتطلب منطقاً مختلفاً وعادة ما لا يكون مفيداً عملياً. يستخدم لف باولي نفسه عدة بوابات كيوبت واحد (بوابات باولي). من المرجح أن تُدخل بوابات باولي الإضافية أخطاء أكثر مما يُكتسب من عشوئة أي تراكم متماسك للأخطاء. معدلات الأخطاء المرتبطة ببوابات الكيوبتين أكبر بكثير من تلك المرتبطة ببوابات الكيوبت الواحد. علاوة على ذلك، بعض بوابات الكيوبت الواحد غير كليفوردية، والتي لا يمكن لفها بالكامل. لهذا السبب يتضمن Qiskit خيارات لف باولي التي تلف تلقائياً حول بوابات الكيوبتين، وليس حول بوابات الكيوبت الواحد.
كان هذا ضمنياً في الشكل أعلاه: نُفّذ لف باولي حول بوابات CX، لكن ليس حول بوابة هادامارد.
لنرَ مثالين على لف باولي عملياً.
لف باولي لقمع التراكم المتماسك
لملاحظة كيف يمكن للف باولي تحويل التراكم المتماسك للأخطاء إلى تراكم غير متماسك أبطأ، نريد دائرة ومُلاحَظاً يعملان كاختبار إجهاد للخطأ المتماسك. الغرض الوحيد هو جعل أخطاء الكيوبتين المتراكمة بشكل متماسك مرئية، ثم إظهار كيف يحوّل لف باولي هذا التراكم المتماسك إلى اضمحلال عشوائي.
بوابات CNOT (أو CZ) مصدر شائع للأخطاء المتماسكة. أبسط تجربة يمكننا القيام بها في هذه الحالة هي تحضير حالة (لنقل )، وتطبيق طبقات من أزواج بوابات CNOT (باستخدام حقيقة أن CNOT اثنين ينتجان مؤثر محايد)، والتحقق من كيفية تراكم الأخطاء مع زيادة عدد الطبقات، سواء مع لف باولي أو بدونه.
المُلاحَظ ذو الاهتمام هو على كيوبت واحد، والذي نرسمه كدالة لعدد تكرارات أزواج CNOT.
# --- Imports ---

import numpy as np
from qiskit import QuantumCircuit
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime import SamplerV2 as Sampler
# Build the circuit with CX/CX identity per layer

def identity_cx_pairs(layers: int) -> QuantumCircuit:
    q = QuantumRegister(2, "q")
    c = ClassicalRegister(1, "c")  # we only measure q0
    qc = QuantumCircuit(q, c, name=f"N={layers}")

    # |+> on q0
    qc.h(q[0])

    for _ in range(layers):
        qc.barrier()
        qc.cx(q[0], q[1])
        qc.cx(q[0], q[1])

    # Measure in X basis: H then measure q0

    qc.h(q[0])
    qc.measure(q[0], c[0])

    return qc
لأننا أدرنا أساسنا قبل القياسات، فإن قياس يتوافق مع كون الحالة في مباشرة قبل بوابة هادامارد الأخيرة، وبالمثل لـ و. لذلك، يمكن حساب قيمة التوقع لدينا ببساطة من عدّات ناقص عدّات .
# Compute <X> from SamplerV2 counts

def x_expect_from_counts(counts: dict[str, int]) -> float:
    shots = sum(counts.values())
    p0 = counts.get("0", 0) / shots
    p1 = counts.get("1", 0) / shots
    return p0 - p1  # <X> = P(0) - P(1) after H,measure
نختار عدداً معقولاً من طبقات CNOT التي نسمح للخطأ بالتراكم عليها، نبني دوائرنا، ثم نحولها (transpile).
# Choose the number of layers for the experiment
N_layers_list = [0, 1, 2, 3, 4, 5]

circuits = [identity_cx_pairs(n) for n in N_layers_list]

# Transpile to backend ISA so that primitives run native instructions
pm = generate_preset_pass_manager(backend=backend, optimization_level=0)
isa_circuits = [pm.run(c) for c in circuits]
ضع في اعتبارك أن كل طبقة تتكون من أكثر من بوابة كيوبتين واحدة. راقب عمق الكيوبتين المحوّل باستخدام الدالة أدناه.
# We can check the 2-qubit depths of any of our circuits like this:
print(
    "two-qubit depth",
    isa_circuits[5].decompose().depth(lambda instr: len(instr.qubits) > 1),
)
two-qubit depth 15
# Configure two Samplers: (A) no twirling, (B) gate twirling
#    - No DD, no measurement twirling in both (to isolate gate twirling)
# ------------------------------
shots = 8192

# (A) No twirling
sampler_no_twirl = Sampler(mode=backend)
# Ensure no extra suppression/mitigation:
sampler_no_twirl.options.dynamical_decoupling.enable = False
# Be explicit about twirling:
sampler_no_twirl.options.twirling.enable_gates = False
sampler_no_twirl.options.twirling.enable_measure = (
    False  # TREX-style measurement twirling off
)
sampler_no_twirl.options.default_shots = shots  # default shots for this primitive

# (B) Gate twirling ON
sampler_twirl = Sampler(mode=backend)
sampler_twirl.options.dynamical_decoupling.enable = False
sampler_twirl.options.twirling.enable_gates = True  # <-- enable Pauli gate twirling
sampler_twirl.options.twirling.enable_measure = False
sampler_twirl.options.default_shots = shots

# (Optional) Inspect options dicts if you’re curious
# print(asdict(sampler_no_twirl.options))
# print(asdict(sampler_twirl.options))
الآن ننفذ المهام (jobs).
# Run both jobs; extract counts; compute <X>

# Helper to run a sampler and compute <X> per circuit
def run_and_x_expect(sampler: Sampler, circ_list: list[QuantumCircuit]) -> list[float]:
    job = sampler.run(
        circ_list
    )  # shots taken from options.default_shots unless overridden
    result = job.result()
    # For SamplerV2, use join_data().get_counts() to combine registers if needed
    exp_vals = []
    for pub in result:
        counts = pub.join_data().get_counts()
        exp_vals.append(x_expect_from_counts(counts))
    return exp_vals

x_no_twirl = run_and_x_expect(sampler_no_twirl, isa_circuits)
x_twirl = run_and_x_expect(sampler_twirl, isa_circuits)

# ------------------------------
# 6) Print a small table
# ------------------------------
print("\nN_layers   <X> (no twirl)   <X> (gate twirl)")
for n, a, b in zip(N_layers_list, x_no_twirl, x_twirl):
    print(f"{n:7d}   {a:14.6f}   {b:14.6f}")
N_layers   <X> (no twirl)   <X> (gate twirl)
      0         0.984375         0.987549
      1         0.934326         0.936523
      2         0.844238         0.892822
      3         0.712158         0.879395
      4         0.592529         0.844971
      5         0.449463         0.785156
أخيراً، نتصور هذه النتائج.
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values using XX
ax.scatter(
    N_layers_list, x_no_twirl, c="blue", linestyle="-", label="No twirl", alpha=0.7
)

## Add values with XY4
ax.scatter(N_layers_list, x_twirl, c="red", linestyle="-", label="Twirled", alpha=0.7)

# Add labels and plot
ax.set_xlabel("CX layers")
ax.set_ylabel("<X>")
ax.legend()
ax.set_title("Pauli twirling")
ax.grid(True)

plt.show()
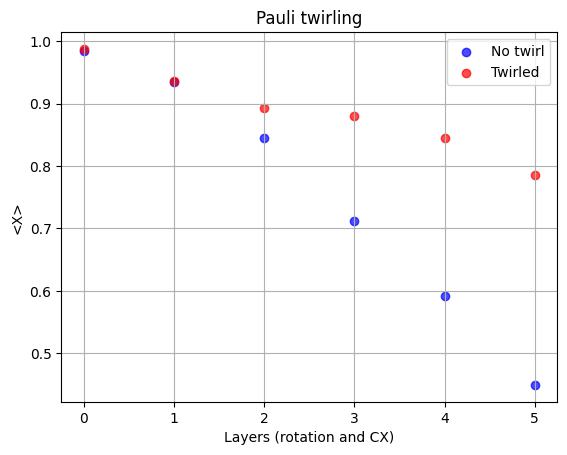
يمكننا أن نرى بوضوح أن الدائرة الملفوفة تعطي قيمة توقع أقرب إلى المثالية . حقق هذا المثال غرضه، لكن لننتقل إلى شيء أكثر فائدة: اللف في إنتاج حالات شديدة التشابك.
لف باولي في تحضير حالة GHZ
أظهر المثال السابق حالة مقنعة للف باولي في تدمير التراكم المتماسك للأخطاء المرتبطة ببوابات CNOT. يستخدم إنتاج حالة GHZ العديد من بوابات CNOT لإنتاج حالات شديدة التشابك مفيدة للعديد من تطبيقات الحوسبة الكمية. لنستكشف كيف يساعد لف باولي في هذا السياق، مع حالات GHZ متزايدة الحجم.
# Imports if not already loaded in previous cells
# from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager
# from qiskit import QuantumRegister, ClassicalRegister, QuantumCircuit

# Define a GHZ circuit building function, so that we can build GHZ states of increasing size.

def ghz_circuit(n: int) -> QuantumCircuit:
    q = QuantumRegister(n, "q")
    c = ClassicalRegister(n, "c")
    qc = QuantumCircuit(q, c)

    qc.h(q[0])
    for i in range(n - 1):
        qc.cx(q[i], q[i + 1])

    qc.barrier()

    qc.measure(q, c)
    return qc

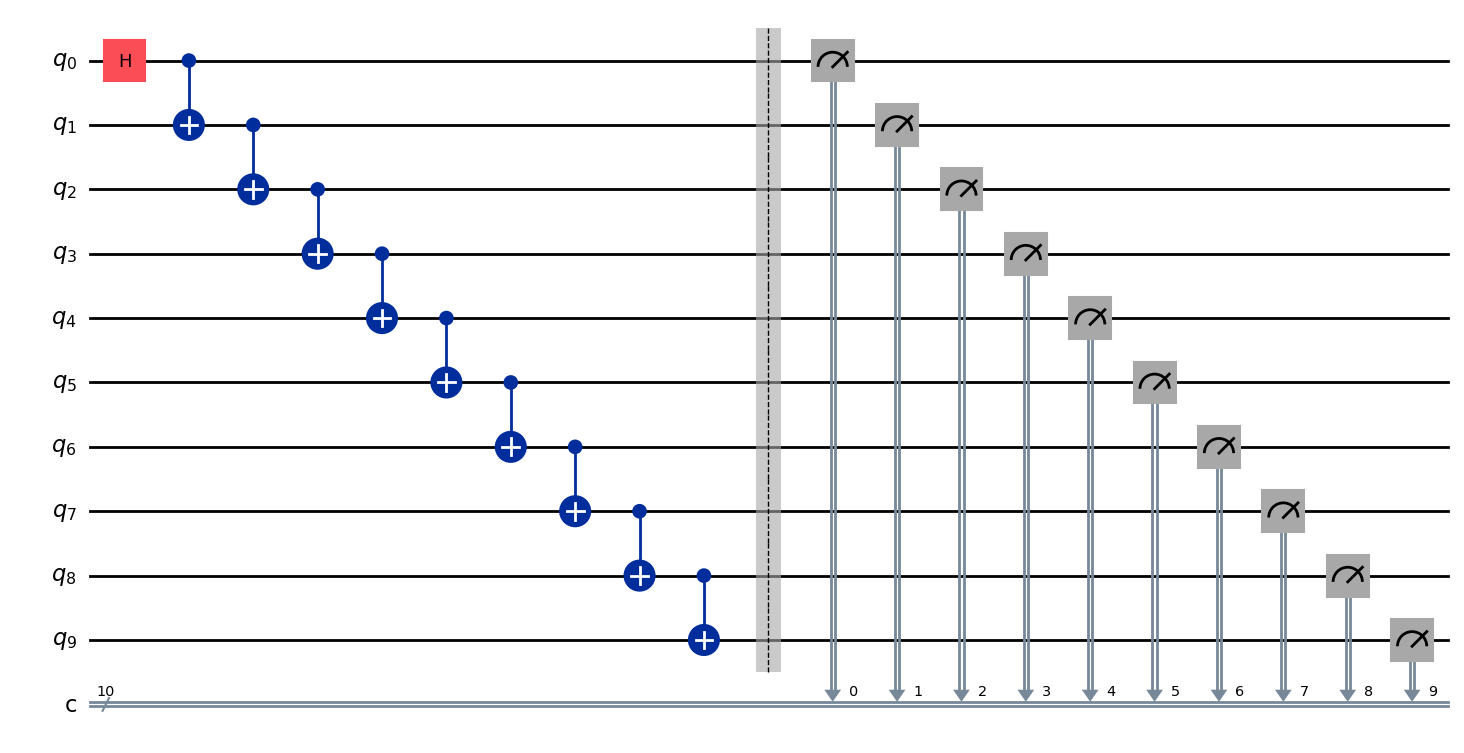
# Build a test state with 10 qubits to remind ourselves of GHZ structure.

num_qubits = 10

qc_ghz = ghz_circuit(num_qubits)
qc_isa = pm.run(qc_ghz)
qc_ghz.draw("mpl")
الآن نبني دوائرنا ونحولها. في هذه الحالة، ليس لدينا أي بوابات مكررة اصطناعياً تختزل إلى مؤثر محايد. لذا يمكننا السماح لمدير التمريرات (pass manager) بأداء المزيد من التحسين لنا. سنضبطه على المستوى ثلاثة.
# Set up a pass manager

opt_level = 3
# --------- Build circuits for a sweep of delays ----------
pm = generate_preset_pass_manager(optimization_level=opt_level, backend=backend)

# Build GHZ circuits of increasing size.

nmin = 5
nmax = 15
circuits = []
for n in range(nmin, nmax):
    qc = ghz_circuit(n)
    qc_isa = pm.run(qc)
    circuits.append(qc_isa)
يمكننا أن نرى أن المُحسّن خرّط دائرتنا المجردة إلى الكيوبتات 123 و124 و136 و142 و143.
circuits[0].draw("mpl")
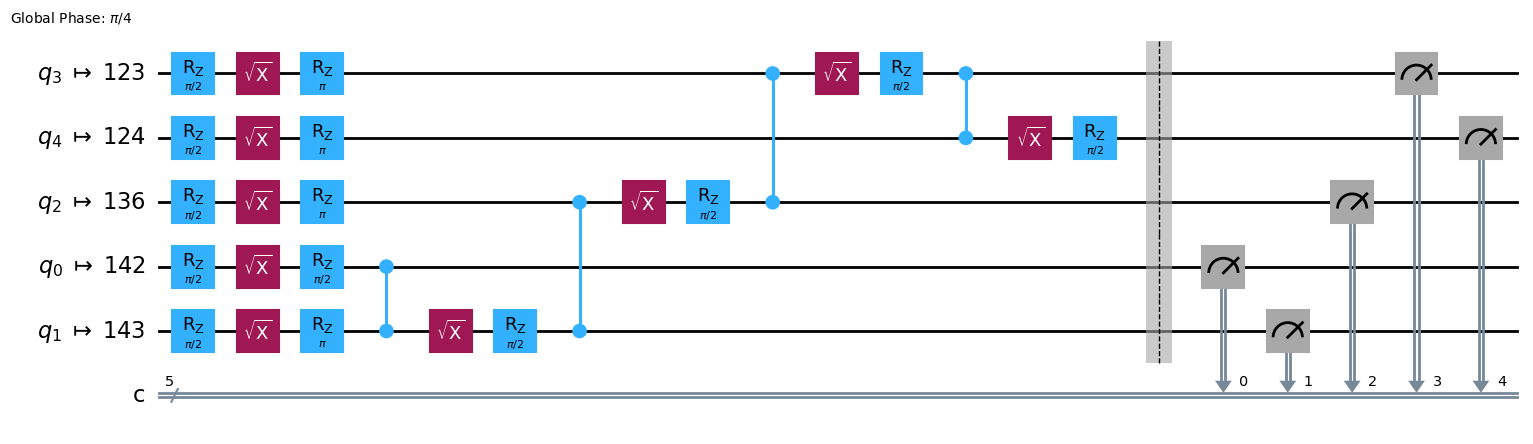
لفهم السبب، لننظر إلى خريطة تخطيط الـ backend الخاص بنا (في هذه الصورة، ibm_fez، لكن يمكنك إجراء تحليلات مماثلة على أي backend).
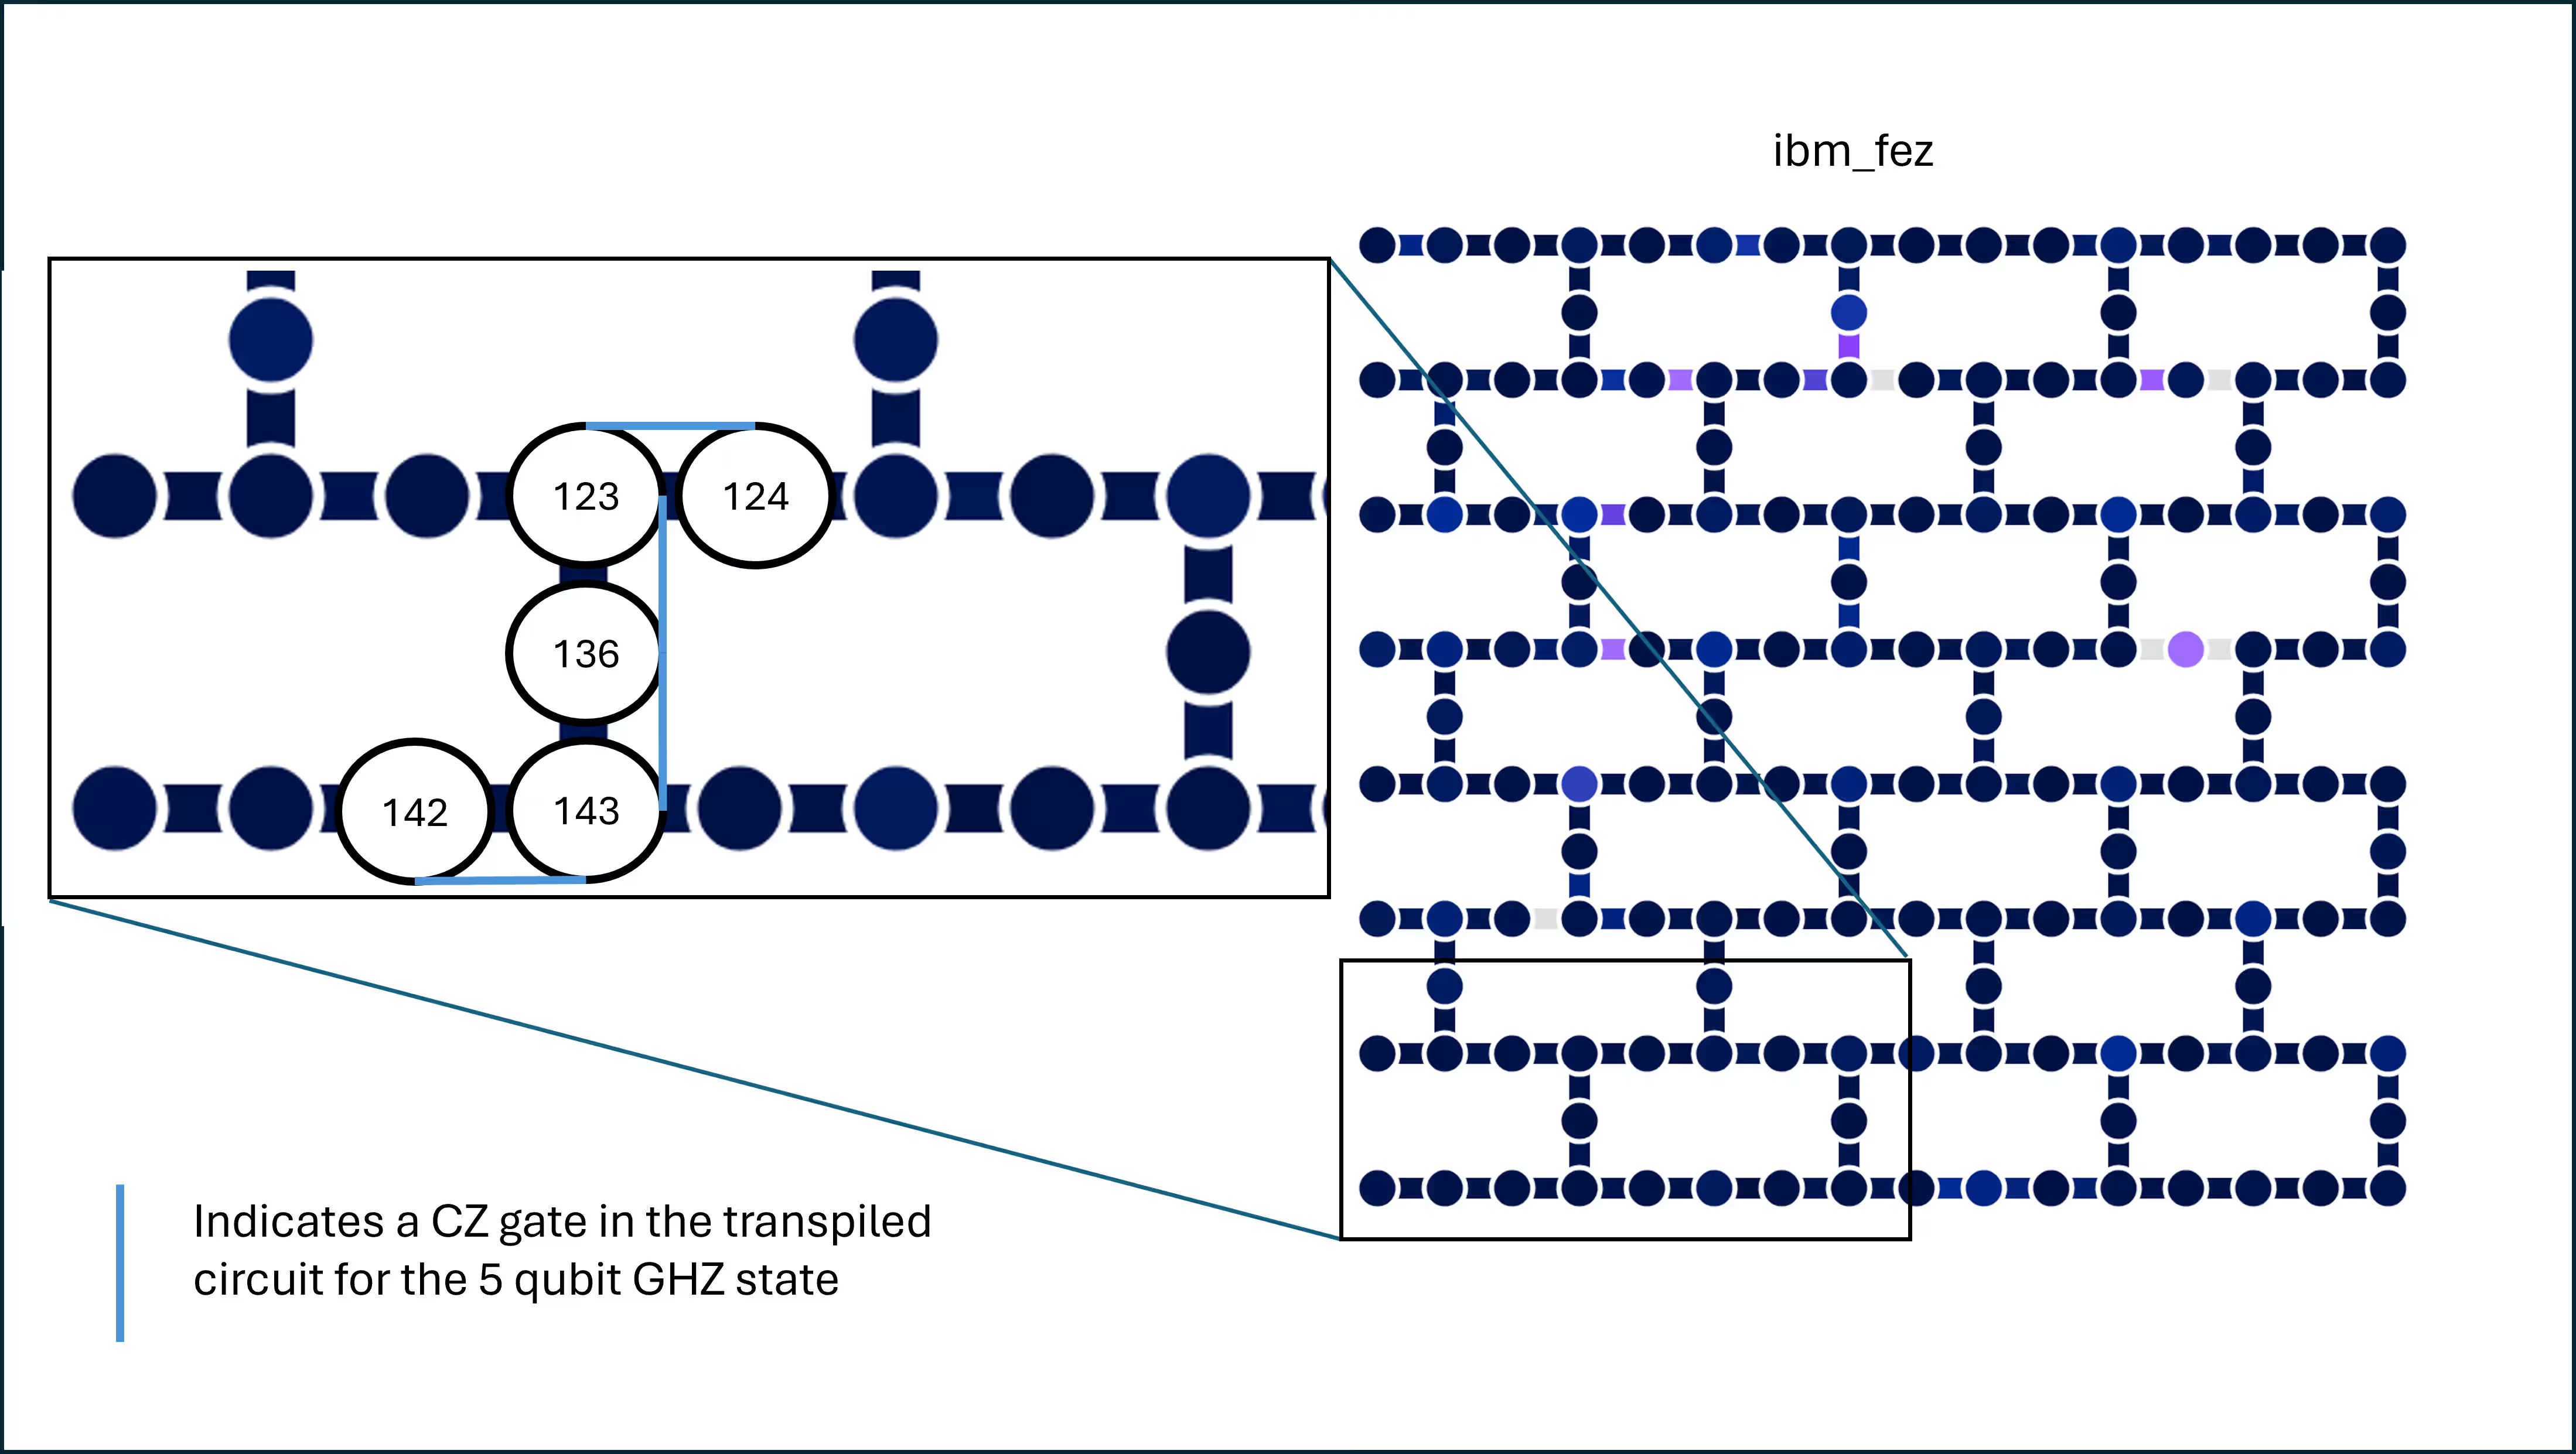
نرى أن الكيوبتات اختيرت في سلسلة لتقليل بوابات التبديل (swap) وبالتالي عمق الدائرة. علاوة على ذلك، كل بوابة CZ منفذة في الدائرة بين كيوبتات متجاورة. أخيراً، جميع الكيوبتات الخمسة لها معدلات خطأ منخفضة نسبياً، بما في ذلك معدلات خطأ تخصيص القراءة (readout-assignment). يمكنك التحقق من معدلات الأخطاء هذه على أي backend في صفحة موارد الحوسبة. إيجاد تخطيط كهذا ليس صعباً لسلسلة خطية بسيطة، لكن مع تزايد تعقيد المسائل، يصبح تحسين تخطيط الدائرة أكثر صعوبة وأكثر قيمة.
الآن نضبط أداتنا الأساسية Sampler. نوقف أدوات القمع/التخفيف الأخرى للتركيز على لف باولي.
# Configure two Samplers: (A) no twirling, (B) gate twirling
# No DD, no measurement twirling in both (to isolate gate twirling)

shots = 8192

# (A) No twirling
sampler_no_twirl = Sampler(mode=backend)
# Ensure no extra suppression/mitigation:
sampler_no_twirl.options.dynamical_decoupling.enable = False
# Be explicit about twirling:
sampler_no_twirl.options.twirling.enable_gates = False
sampler_no_twirl.options.twirling.enable_measure = (
    False  # TREX-style measurement twirling off
)
sampler_no_twirl.options.default_shots = shots  # default shots for this primitive

# (B) Gate twirling ON
sampler_twirl = Sampler(mode=backend)
sampler_twirl.options.dynamical_decoupling.enable = False
sampler_twirl.options.twirling.enable_gates = True  # <-- enable Pauli gate twirling
sampler_twirl.options.twirling.enable_measure = False
sampler_twirl.options.default_shots = shots

# (Optional) Inspect options dicts if you’re curious
# print(asdict(sampler_no_twirl.options))
# print(asdict(sampler_twirl.options))
أخيراً، ننفذ مهامنا. يمكنك اختيارياً طباعة أرقام معرفات المهام (job ID) لاسترجاعها لاحقاً.
job = sampler_twirl.run(circuits)
res_ghz_twirl = job.result()
job_id = job.job_id()  # job id for twirling on/true
print("job number for twirling the ghz prep is ", job_id)

job = sampler_no_twirl.run(circuits)
res_ghz_no_twirl = job.result()
job_id = job.job_id()  # job id for twirling off/false
print("job number for NO twirling the ghz prep is ", job_id)
job number for twirling the ghz prep is  d7h967bjne2c7393s0b0
job number for NO twirling the ghz prep is  d7h96f7b91ec73aufing
نستخرج عدّات كل حالة أساس حاسوبية مُقاسة لجميع الدوائر، مع اللف وبدونه.
# --------- Extract counts per circuit ----------
def extract_counts_list(res):
    counts_list = []
    for r in res:  # each r corresponds to one circuit
        # r.data.<classical_register_name>.get_counts()
        counts = r.data.c.get_counts()
        counts_list.append(counts)
    return counts_list

counts_list_ghz_twirl = extract_counts_list(res_ghz_twirl)
counts_list_ghz_no_twirl = extract_counts_list(res_ghz_no_twirl)
print(counts_list_ghz_twirl[0])
print(counts_list_ghz_twirl[4])
{'11111': 3440, '11101': 87, '00000': 3434, '10111': 87, '00001': 168, '10011': 4, '11000': 102, '00011': 39, '01111': 93, '00111': 111, '01000': 90, '11110': 235, '00110': 6, '00010': 75, '11011': 30, '11100': 42, '10000': 82, '00101': 7, '10001': 2, '11001': 6, '11010': 5, '01010': 3, '01110': 7, '00100': 14, '10101': 1, '10110': 8, '01001': 6, '10100': 1, '01101': 4, '01011': 1, '10010': 2}
{'111111111': 2683, '000000000': 2976, '111000000': 53, '110000000': 74, '111111100': 47, '111011111': 76, '111111110': 195, '111111000': 67, '000000010': 66, '011111110': 10, '011110001': 1, '101110111': 7, '101011111': 9, '111110111': 87, '111100000': 96, '111011000': 2, '010000000': 60, '111111010': 3, '100000000': 110, '111111011': 32, '000000111': 51, '000100000': 84, '000011111': 82, '000000001': 176, '100000010': 6, '111100001': 3, '000000011': 36, '101111111': 98, '100000011': 2, '001111111': 75, '000001000': 60, '000011101': 4, '110111111': 38, '111111101': 72, '111100100': 3, '000100010': 1, '001011101': 1, '000000110': 8, '110000011': 1, '000111111': 48, '000000100': 23, '000001111': 65, '010000101': 2, '000100001': 8, '111110000': 51, '010001111': 1, '111000111': 2, '111000001': 2, '000111100': 1, '011111111': 116, '111110001': 1, '000011110': 10, '000010000': 23, '000101111': 3, '000101110': 1, '011110111': 4, '010000111': 7, '111101111': 36, '001000000': 40, '010100000': 3, '101111110': 8, '110111000': 5, '000000101': 8, '010000010': 4, '000110001': 2, '110111110': 4, '111100010': 2, '111010111': 2, '000001110': 5, '111110101': 3, '001110000': 4, '101100000': 5, '001111110': 8, '100000001': 5, '111011110': 3, '111110100': 5, '110001011': 1, '001110111': 4, '000010110': 2, '111001111': 2, '000011000': 5, '010111110': 1, '000101000': 4, '101000000': 4, '100111111': 4, '111110011': 2, '000101100': 1, '101111100': 2, '111011100': 1, '001111011': 3, '011111011': 3, '110100000': 5, '000001011': 3, '111110110': 5, '111111001': 5, '000001001': 8, '010000001': 5, '011111101': 2, '001010111': 1, '011101110': 1, '110110110': 1, '001111100': 3, '100001000': 3, '001000011': 1, '001011111': 6, '110000010': 2, '110010000': 1, '010011111': 2, '111101101': 3, '101110000': 1, '111100111': 6, '010111111': 5, '110110000': 2, '011011111': 2, '110011111': 1, '110000111': 6, '001000001': 2, '001100000': 3, '101101111': 1, '000111110': 5, '111011101': 2, '100100000': 2, '101111101': 3, '001001111': 1, '001010000': 2, '111001000': 1, '011110000': 2, '011101111': 3, '000001100': 1, '110101000': 1, '011000000': 4, '111101000': 3, '110000001': 4, '000010111': 4, '011111100': 1, '111000010': 1, '101011000': 1, '101111000': 2, '001101111': 1, '010001100': 1, '000100011': 1, '111110010': 1, '111101110': 1, '100001111': 1, '100011011': 1, '010110111': 1, '001110110': 2, '100000100': 1, '001000110': 1, '100011111': 2, '010010001': 1, '111010110': 1, '011110110': 1, '000111000': 2, '000100111': 1, '011010000': 1, '001111000': 2, '100010000': 1, '011111000': 2, '110111100': 2, '110110111': 1, '110001000': 1, '000110111': 1, '000101011': 1, '000110000': 1, '011100000': 3, '001000010': 1, '001001000': 1, '001000111': 1, '001111101': 3, '111101011': 1, '111010000': 1, '100000101': 1, '000010010': 1, '001011110': 1, '000011011': 1, '111101100': 1}
نعلم أن التوزيع المثالي لحالة GHZ هو ذلك الذي يعيد فيه نصف اللقطات والنصف الآخر . لنبني هذا للمقارنة.
ideal_dist = []
for n in range(nmin, nmax):
    ideal_dist.append({"0" * n: int(shots / 2), "1" * n: int(shots / 2)})
نستخدم الآن دقة هيلينغر (Hellinger fidelity) كمقياس لجودة حالتنا النهائية.
from qiskit.quantum_info import hellinger_fidelity

num_qubits = []
fidelities_twirl = []
fidelities_no_twirl = []
for n in range(len(ideal_dist)):
    num_qubits.append(nmin + n)
    fidelities_twirl.append(hellinger_fidelity(counts_list_ghz_twirl[n], ideal_dist[n]))
    fidelities_no_twirl.append(
        hellinger_fidelity(counts_list_ghz_no_twirl[n], ideal_dist[n])
    )
أخيراً نرسم نتائجنا.
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values using no twirling
ax.scatter(
    num_qubits,
    fidelities_no_twirl,
    c="blue",
    linestyle="-",
    label="No twirl",
    alpha=0.7,
)

## Add values with twirling
ax.scatter(
    num_qubits, fidelities_twirl, c="red", linestyle="-", label="Twirled", alpha=0.7
)

# Add labels and plot
ax.set_xlabel("Qubits in GHZ state")
ax.set_ylabel("Hellinger fidelity")
ax.legend()
ax.set_title("Pauli twirling in GHZ states")
ax.grid(True)

plt.show()
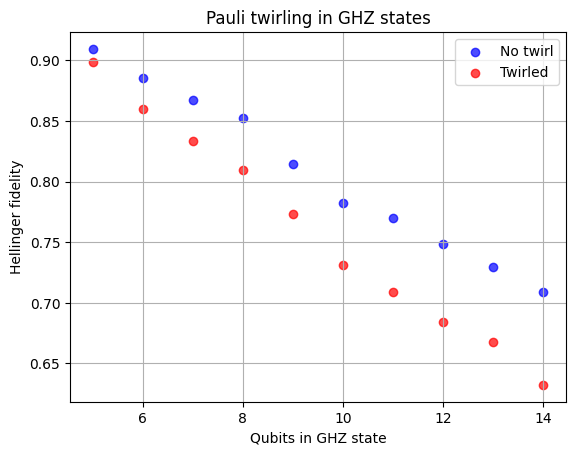
النتائج باستخدام لف باولي ليست أفضل (بل أسوأ قليلاً) من بدون لف. ماذا حدث؟
حدث أمران. أولاً، لا يقلل لف باولي من إجمالي كمية الضوضاء — بل يعيد تشكيل الأخطاء المتماسكة والمنهجية إلى أخطاء عشوائية من نوع باولي، بحيث يصبح نمو الخطأ قابلاً للتنبؤ والنمذجة. لم يكن هناك أبداً أي وعد بتقليل الخطأ، إلا في حالات خاصة.
ثانياً، في دوائر GHZ، يمكن لبعض الأخطاء المتماسكة أن تُلغي جزئياً أو تتصرف كإزاحات طور حميدة بسبب تناظر بنية GHZ؛ يزيل اللف هذه الحماية العرضية ويستبدلها بضوضاء باولي عشوائية غير مترابطة، لذا تصبح دقة GHZ أسوأ قليلاً تحت اللف.
يتطلب هذا الادعاء الثاني بعض التوضيح. الادعاء ليس أن دوائر GHZ محمية من جميع أنواع التراكم المتماسك للأخطاء، بل من بعض الأنواع فقط — وأن الحماية في تلك الحالات تُدمَّر باللف. تحديداً، لنعتبر الدوران الزائد المتماسك المرتبط ببوابات CX. لنسمِّ بوابة CX الحقيقية ذات الدوران الزائد :
حيث هو أي جداء لمؤثرات باولي، مثل ، ، ، ، إلخ. بالنسبة للحالات العامة، يمكن لأي من هذه الأخطاء في الدوران الزائد أن تؤثر على إحصائيات القياس (وبالتالي مقاييس إخلاص الحالة). لكن مجموعة فرعية من هذه الأخطاء تترك العديد من مراصد GHZ القياسية دون تغيير، بما في ذلك مؤثرات مثل و . في سياق تحضير حالة GHZ، تكون أخطاء الدوران الزائد ذات الصلة من هذا النوع كما يلي:
يبدو تحضير حالة GHZ الكاملة المكونة من كيوبت كما يلي:
بعد تحضير حالة GHZ، تكون الحالة مثاليًا:
هذه الحالة هي حالة ذاتية متزامنة لمجموعة كبيرة من مؤثرات باولي، بما في ذلك ما يلي:
بقيمة ذاتية . نتيجة لذلك، يتصرف مؤثر من الشكل على حالة GHZ كضرب في عامل الطور ، وهو ما لا يؤثر على مراصد GHZ القياسية مثل التماثل، أو الجمعي، أو التوزيعات السكانية في الأساس الحاسوبي. وبالتالي، على الرغم من أن أخطاء الدوران الزائد متماسكة ومنهجية، فإنها غير مرئية فعليًا للقياسات المستخدمة لتقييم إخلاص GHZ. بهذا المعنى، تتمتع دائرة GHZ بحماية تماسك عرضية: بعض أخطاء CX المتماسكة تتبادل مع بنية الحالة التي يتم تحضيرها، وبالتالي لا تُضعف الأداء المقاس.
يغيّر تشويش باولي هذا الوضع بشكل جذري. لا يحافظ التشويش على خطأ الدوران الزائد المتماسك كعملية حتمية . بدلاً من ذلك، يحوّل قناة الخطأ المتماسكة إلى قناة باولي عشوائية فعّالة. نتيجة لذلك، تتضمن قناة الخطأ الآن حدودًا مثل و و و ، وهي حدود لا تتبادل مع مثبتات GHZ.
عندما تحدث أخطاء باولي العشوائية هذه، فإنها تُنشئ أعطالًا حقيقية من نوع انقلاب البت وانقلاب الطور على كيوبتات فردية أو أزواج من الكيوبتات. تُخرج هذه الأخطاء الحالة من الفضاء الفرعي لمثبتات GHZ، وتقلل من التداخل بين و ، وتخفض مباشرةً إخلاص GHZ وإشارات التماثل متعددة الكيوبتات. بعبارة أخرى، يزيل تشويش باولي البنية المتماسكة للخطأ، لكنه يزيل أيضًا الإلغاء القائم على التماثل الذي كان يجعل تلك الأخطاء غير ضارة سابقًا. والنتيجة هي حالة GHZ أسوأ قليلًا — ليس لأن التشويش يضيف ضوضاء، بل لأنه يحوّل خطأً متماسكًا غير ضار في معظمه إلى أخطاء عشوائية مُضِرّة فعليًا.
يسلط هذا المثال الضوء على درس مهم: تشويش باولي ليس استراتيجية تحسين شاملة. وهو أكثر فائدة عندما تتراكم الأخطاء المتماسكة عبر الدائرة بطريقة مدمرة للإخلاص المطلوب. في الدوائر شديدة التماثل مثل تحضير حالة GHZ، تكون بعض الأخطاء المتماسكة متوافقة بشكل طبيعي مع مثبتات الحالة، وإجراء تعشيتها عمدًا يمكن أن يزيل هذه الحماية العرضية.
دمج الأساليب
يمكن من حيث المبدأ دمج تشويش باولي مع فك الترابط الديناميكي. لم نستخدم DD في هذه الحالة لسببين: أولًا، لا ينبغي أن تكون هناك أي فترات خمول طويلة جدًا في هذه الدائرة. وثانيًا، لا تُخزّن حالات GHZ معظم معلوماتها في تماسك الطور أحادي الكيوبت، خاصةً إذا كنا نلاحظ الإخلاص فقط من حيث عدّ السلاسل الثنائية، وليس من حيث الطور بين السلاسل الثنائية المرغوبة و .
لو قمنا بتوسيع تحضير GHZ إلى 100+ كيوبت، فقد تكون التأخيرات في قياس الكيوبتات الأولى/المبكرة طويلة بالفعل بما يكفي لتكون DD مفيدة. وهذا صحيح بشكل خاص عندما نأخذ في الاعتبار عمق الدائرة بعد الترجمة.
تشويش باولي في بنية صدى RTZ
مثالنا الأخير على تشويش باولي في سياق تقليل تراكم الخطأ المتماسك يستخدم دائرة بطبقات من تركيبات X-CZ-X-CZ. هذه تسلسلة بوابات معروفة جيدًا وتُستخدم غالبًا لإلغاء حدود خطأ ZZ المتماسكة في البوابات ثنائية الكيوبت، حتى بدون تشويش. لكن مع التشويش، يمكننا تقليل أو تعشية أشكال أخرى من تراكم الخطأ المتماسك.
سنبدأ بتعريف دالة لبناء دوائر شبيهة بـ RTZ بعدد متغير من الطبقات.
from qiskit import QuantumCircuit

def rtz_echo_circuit(n_qubits: int, depth: int) -> QuantumCircuit:
    """
    Construct an RTZ echo-style circuit.

    Args:
        n_qubits: Number of qubits in the circuit.
        depth: Number of repeated echo layers.

    Returns:
        A QuantumCircuit implementing the echo sequence with measurements.
    """
    q = QuantumRegister(n_qubits, "q")
    c = ClassicalRegister(n_qubits, "c")
    qc = QuantumCircuit(q, c)

    for _ in range(depth):
        qc.h(q)

        for i in range(0, n_qubits - 1, 2):
            qc.cz(q[i], q[i + 1])

        qc.x(q)

        for i in range(1, n_qubits - 1, 2):
            qc.cz(q[i], q[i + 1])

        qc.h(q)

    qc.measure(q, c)
    return qc
الآن نبني دوائر بعدد متزايد من الطبقات، حتى عمق إجمالي معقول ثنائي الكيوبت بعد الترجمة.
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

circuits = []
qcs = []
depths = list(range(3, 27, 4))
n_qubits = 10

opt_level = 0
pm = generate_preset_pass_manager(
    optimization_level=opt_level,
    backend=backend,
    initial_layout=[0, 1, 2, 3, 4, 5, 6, 7, 8, 9],
)

for d in depths:
    qc = rtz_echo_circuit(n_qubits, d)
    qcs.append(qc)
    qc_isa = pm.run(qc)
    circuits.append(qc_isa)
# We can check the 2-qubit depths of any of our circuits like this:
two_qubit_depths = []
for n in range(len(circuits)):
    two_qubit_depths.append(
        circuits[n].decompose().depth(lambda instr: len(instr.qubits) > 1)
    )
print(two_qubit_depths)
[6, 14, 22, 30, 38, 46]
qcs[0].draw("mpl")
# circuits[0].draw("mpl")
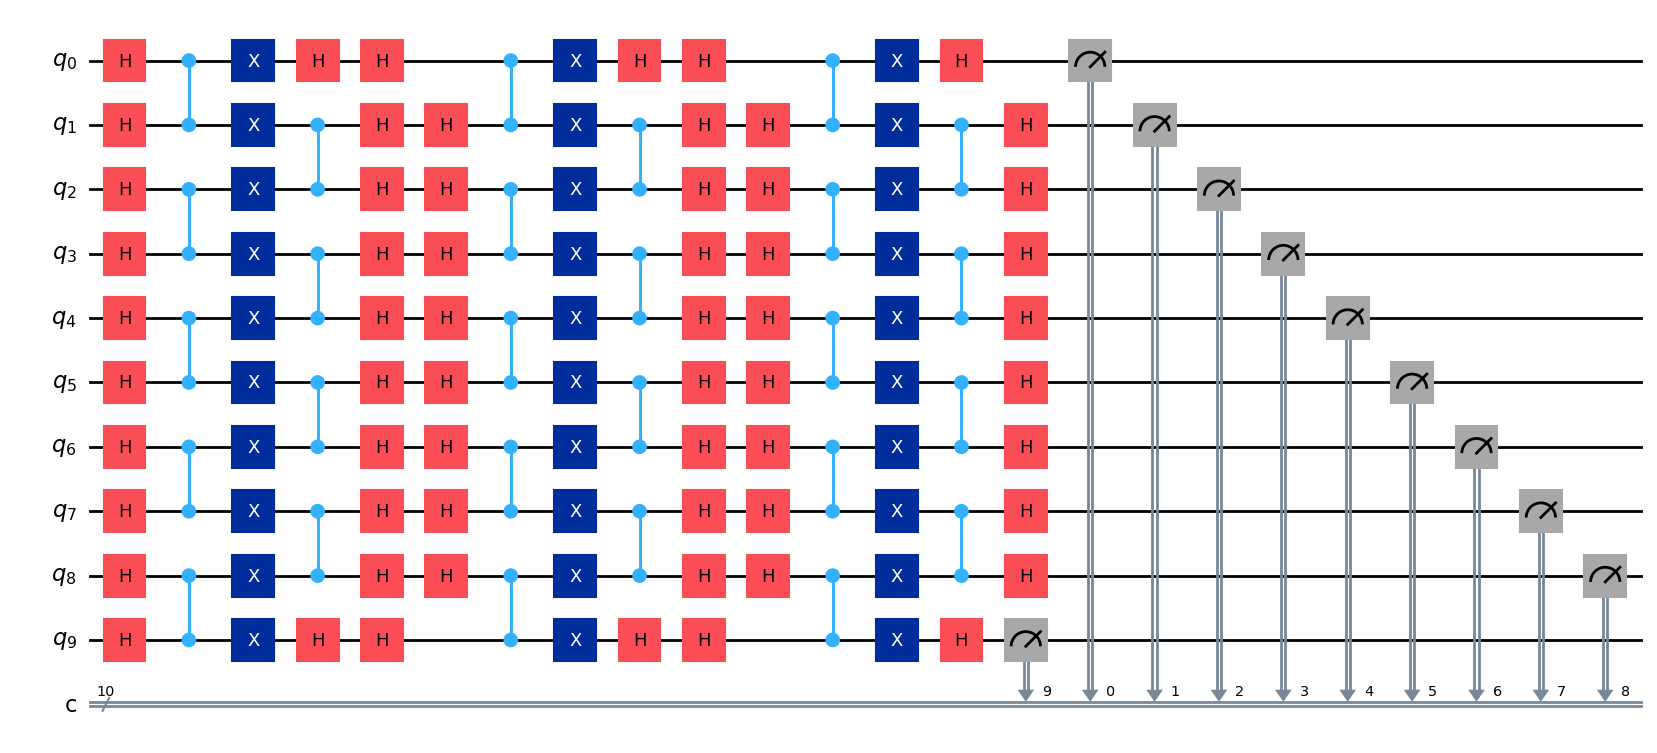
عند الطرف الأعلى، بعض هذه الدوائر عميقة جدًا. لنستخدم AerSimulator بدون نموذج ضوضاء للحصول على الحالات المثالية في نهاية كل من هذه الدوائر. يمكننا بعد ذلك قياس نتائجنا من حواسيب كمومية حقيقية باستخدام إخلاص هيلينغر.
from qiskit_aer import AerSimulator

sim = AerSimulator()
ideal_results = sim.run(circuits, shots=8192).result()
ideal_counts = ideal_results.get_counts()
الآن نُعرّف SamplerV2 مع التشويش، وآخر بدون تشويش.
from qiskit_ibm_runtime import SamplerV2 as Sampler

shots = 8192

# --- No Twirling ---
sampler_no = Sampler(mode=backend)
sampler_no.options.twirling.enable_gates = False
sampler_no.options.twirling.enable_measure = False
sampler_no.options.default_shots = shots

# --- With Twirling ---
sampler_tw = Sampler(mode=backend)
sampler_tw.options.twirling.enable_gates = True
sampler_tw.options.twirling.enable_measure = False
# sampler_tw.options.twirling.num_randomizations = "auto"
sampler_tw.options.twirling.num_randomizations = 32
sampler_tw.options.twirling.strategy = "active-circuit"
sampler_tw.options.default_shots = shots
الآن نُشغّل مهامنا.
# Each job took 17 sec (34 sec total) on ibm_fez. Your times might vary.

job_no = sampler_no.run(circuits)
job_tw = sampler_tw.run(circuits)

res_no = job_no.result()
res_tw = job_tw.result()
نحصل على العدّات من كل عملية تشغيل على حاسوب كمومي حقيقي.
counts_no = [r.data.c.get_counts() for r in res_no]
counts_tw = [r.data.c.get_counts() for r in res_tw]
الآن نجد إخلاص هيلينغر بمقارنة كل من هذه التشغيلات بنتائج AerSimulator الخالية من الضوضاء.
from qiskit.quantum_info import hellinger_fidelity

f_no = [hellinger_fidelity(counts_no[i], ideal_counts[i]) for i in range(len(circuits))]

f_tw = [hellinger_fidelity(counts_tw[i], ideal_counts[i]) for i in range(len(circuits))]
الآن نُصوّر نتائجنا.
import matplotlib.pyplot as plt

plt.figure(figsize=(8, 5))
plt.plot(two_qubit_depths, f_no, "o-", label="No Twirling")
plt.plot(two_qubit_depths, f_tw, "o-", label="With Twirling")
plt.xlabel("Two-qubit transpiled depth")
plt.ylabel("Hellinger Fidelity")
plt.title("RTZ Echo Circuit: Twirling vs No Twirling")
plt.legend()
plt.grid(True)
plt.show()
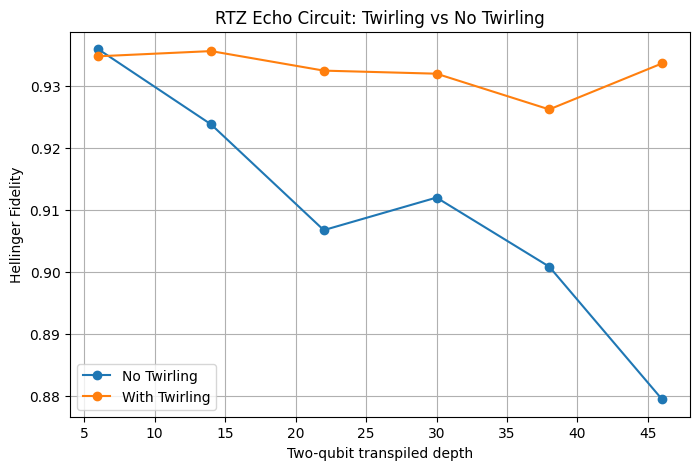
طوال هذا الدرس، درسنا حالات يُستخدم فيها تشويش باولي للحد من تراكم الخطأ المتماسك، وهو سياق يمكن وصفه فيه بأنه قمع الخطأ. ومع ذلك، غالبًا ما يكون تشويش باولي أكثر فائدة كأداة لإعادة تشكيل سلوك الخطأ، بتحويل الأخطاء المتماسكة إلى شكل أكثر قابلية للتنبؤ وأسهل في النمذجة. ستصبح فائدة هذا أكثر وضوحًا في سياق تقنيات تخفيف الخطأ مثل الاستقراء إلى الضوضاء الصفرية (ZNE)، التي تعتمد على تدرج ضوضاء قابل للتنبؤ بشكل معقول. يتم تناول هذا في الدرس التالي.