تخفيف الأخطاء
يقدّم هذا الدرس خلفية عن تقنيات تخفيف الأخطاء المختلفة ليساعدك على تكوين حدس عن كيفية استخدامها ومتى يكون ذلك أفضل. والمهم أن التطبيقات الحديثة لهذه التقنيات تستفيد من أدوات أكثر تطوراً، مثل Samplomatic وShaded Lightcones وExecutor. وسنتناول سير العمل هذه في دروس لاحقة.
يقدّم هذا الفيديو نظرة عامة على تقنيات تخفيف الأخطاء. والنص أدناه يضيف مزيداً من التفاصيل ويستكشف هذه الطرق باستخدام Qiskit.
نظرة عامة على تقنيات تخفيف الأخطاء
يشير تخفيف الأخطاء إلى أي عملية تحاول تقليل آثار الأخطاء في الحسابات الكمومية بعد حدوثها. وهو يختلف عن الكبت (suppression) الذي يحاول منع الأخطاء، وعن تصحيح الأخطاء الذي يرمّز المعلومات عبر كيوبتات فيزيائية كثيرة ويتحقق من اتساقها للحفاظ على المعلومات في كيوبت منطقي واحد. وعلى امتداد هذا الدرس، يُفهم تخفيف الأخطاء على أفضل وجه بوصفه طرقاً لبناء مقدّرات أفضل للقيم المتوقعة المثالية أو عيّنات أفضل للتوزيعات الاحتمالية، وليس بوصفه طرقاً لتصحيح الحالات الكمومية أثناء التنفيذ. سنفحص أدناه طرق تخفيف الأخطاء، وكلها متاحة في Qiskit وإضافاته (addons)، وهي أدوات واعدة في السعي نحو التفوق الكمومي.
استئصال أخطاء القراءة بالالتفاف العشوائي (TREX) يعشوِن عملية القياس بتطبيق عمليات باولي مختارة عشوائياً قبل القياس ثم إلغاء آثارها المعروفة كلاسيكياً على سلاسل البتات المرصودة. وفي ظل افتراضات مناسبة لضوضاء القياس، يحوّل هذا قناة خطأ القراءة إلى شكل أبسط وأكثر تناظراً يسهل معايرته وتخفيفه.
تخفيف القياس بلا مصفوفات (M3) هي تقنية قابلة للتوسع لتخفيف أخطاء القياس تتجنب بناء مصفوفة الإسناد أو معكوسها بشكل صريح.
الاستقراء إلى ضوضاء صفرية (ZNE) يقرّب القيمة التي سيكون عليها المرصود في غياب الضوضاء، وذلك بتكبير الضوضاء اصطناعياً بعامل معروف ثم الاستقراء عودةً إلى حالة الضوضاء الصفرية. ويتطلب هذا أن تتدرج الضوضاء بطريقة يمكن التنبؤ بها. وقد يتطلب هذا التنبؤ طرقاً أخرى نناقشها في هذا الدرس (تمديد النبضات، وطيّ البوابات، وتضخيم الأخطاء الاحتمالي (PEA)).
إلغاء الأخطاء الاحتمالي (PEC) من أقوى تقنيات تخفيف الأخطاء، لكنه أيضاً من أكثرها كلفة حسابياً. يعمل بتعلّم سلوك الضوضاء في النظام ومحاولة التراجع عنها ببناء تقدير غير متحيّز للحساب المثالي إحصائياً. ويُخرج PEC مرصودات مصحّحة إحصائياً، لا نتائج مصحّحة الأخطاء.
سنتعمق الآن في كل طريقة من هذه الطرق.
M3
أخطاء القياس من أكثر مصادر الضوضاء استمراراً وارتباطاً بالعتاد في الأجهزة الكمومية قصيرة المدى. فحتى عندما تُحضَّر الحالة الكمومية وتتطور بشكل صحيح، قد تُبلغ خطوة القراءة النهائية عن نتيجة خاطئة في أساس الحساب. وتنشأ هذه الأخطاء من التمييز غير الكامل بين الحالتين الفيزيائيتين المقابلتين لـ و، ومن الاسترخاء أثناء القياس، ومن عيوب إلكترونيات القياس. ونتيجة لذلك، كثيراً ما يكون توزيع سلاسل البتات المرصود نسخة مشوّهة من التوزيع الحقيقي (المثالي)، مع إعادة إسناد الاحتمال خطأً بين النتائج.
يعالج تخفيف القياس هذه المشكلة بنمذجة كيفية إسناد نتائج القياس خطأً بشكل صريح. وفي الصياغة القياسية، تُلتقط هذه الظاهرة بمصفوفة إسناد ، تمثّل عناصرها احتمال تسجيل النتيجة عندما تكون حالة الأساس الحقيقية . وإذا كانت ضوضاء القياس كلاسيكية وساكنة، فإن متجه الاحتمالات المرصود يرتبط بالتوزيع المثالي بعلاقة خطية بسيطة،
لاحظ أن مصفوفة الإسناد هي خريطة عشوائية كلاسيكية، وليست قناة كمومية. فهي تعمل على القراءات الكلاسيكية، لا على الحالات الكمومية الأساسية التي أُخذت منها العيّنات للحصول على القراءات.
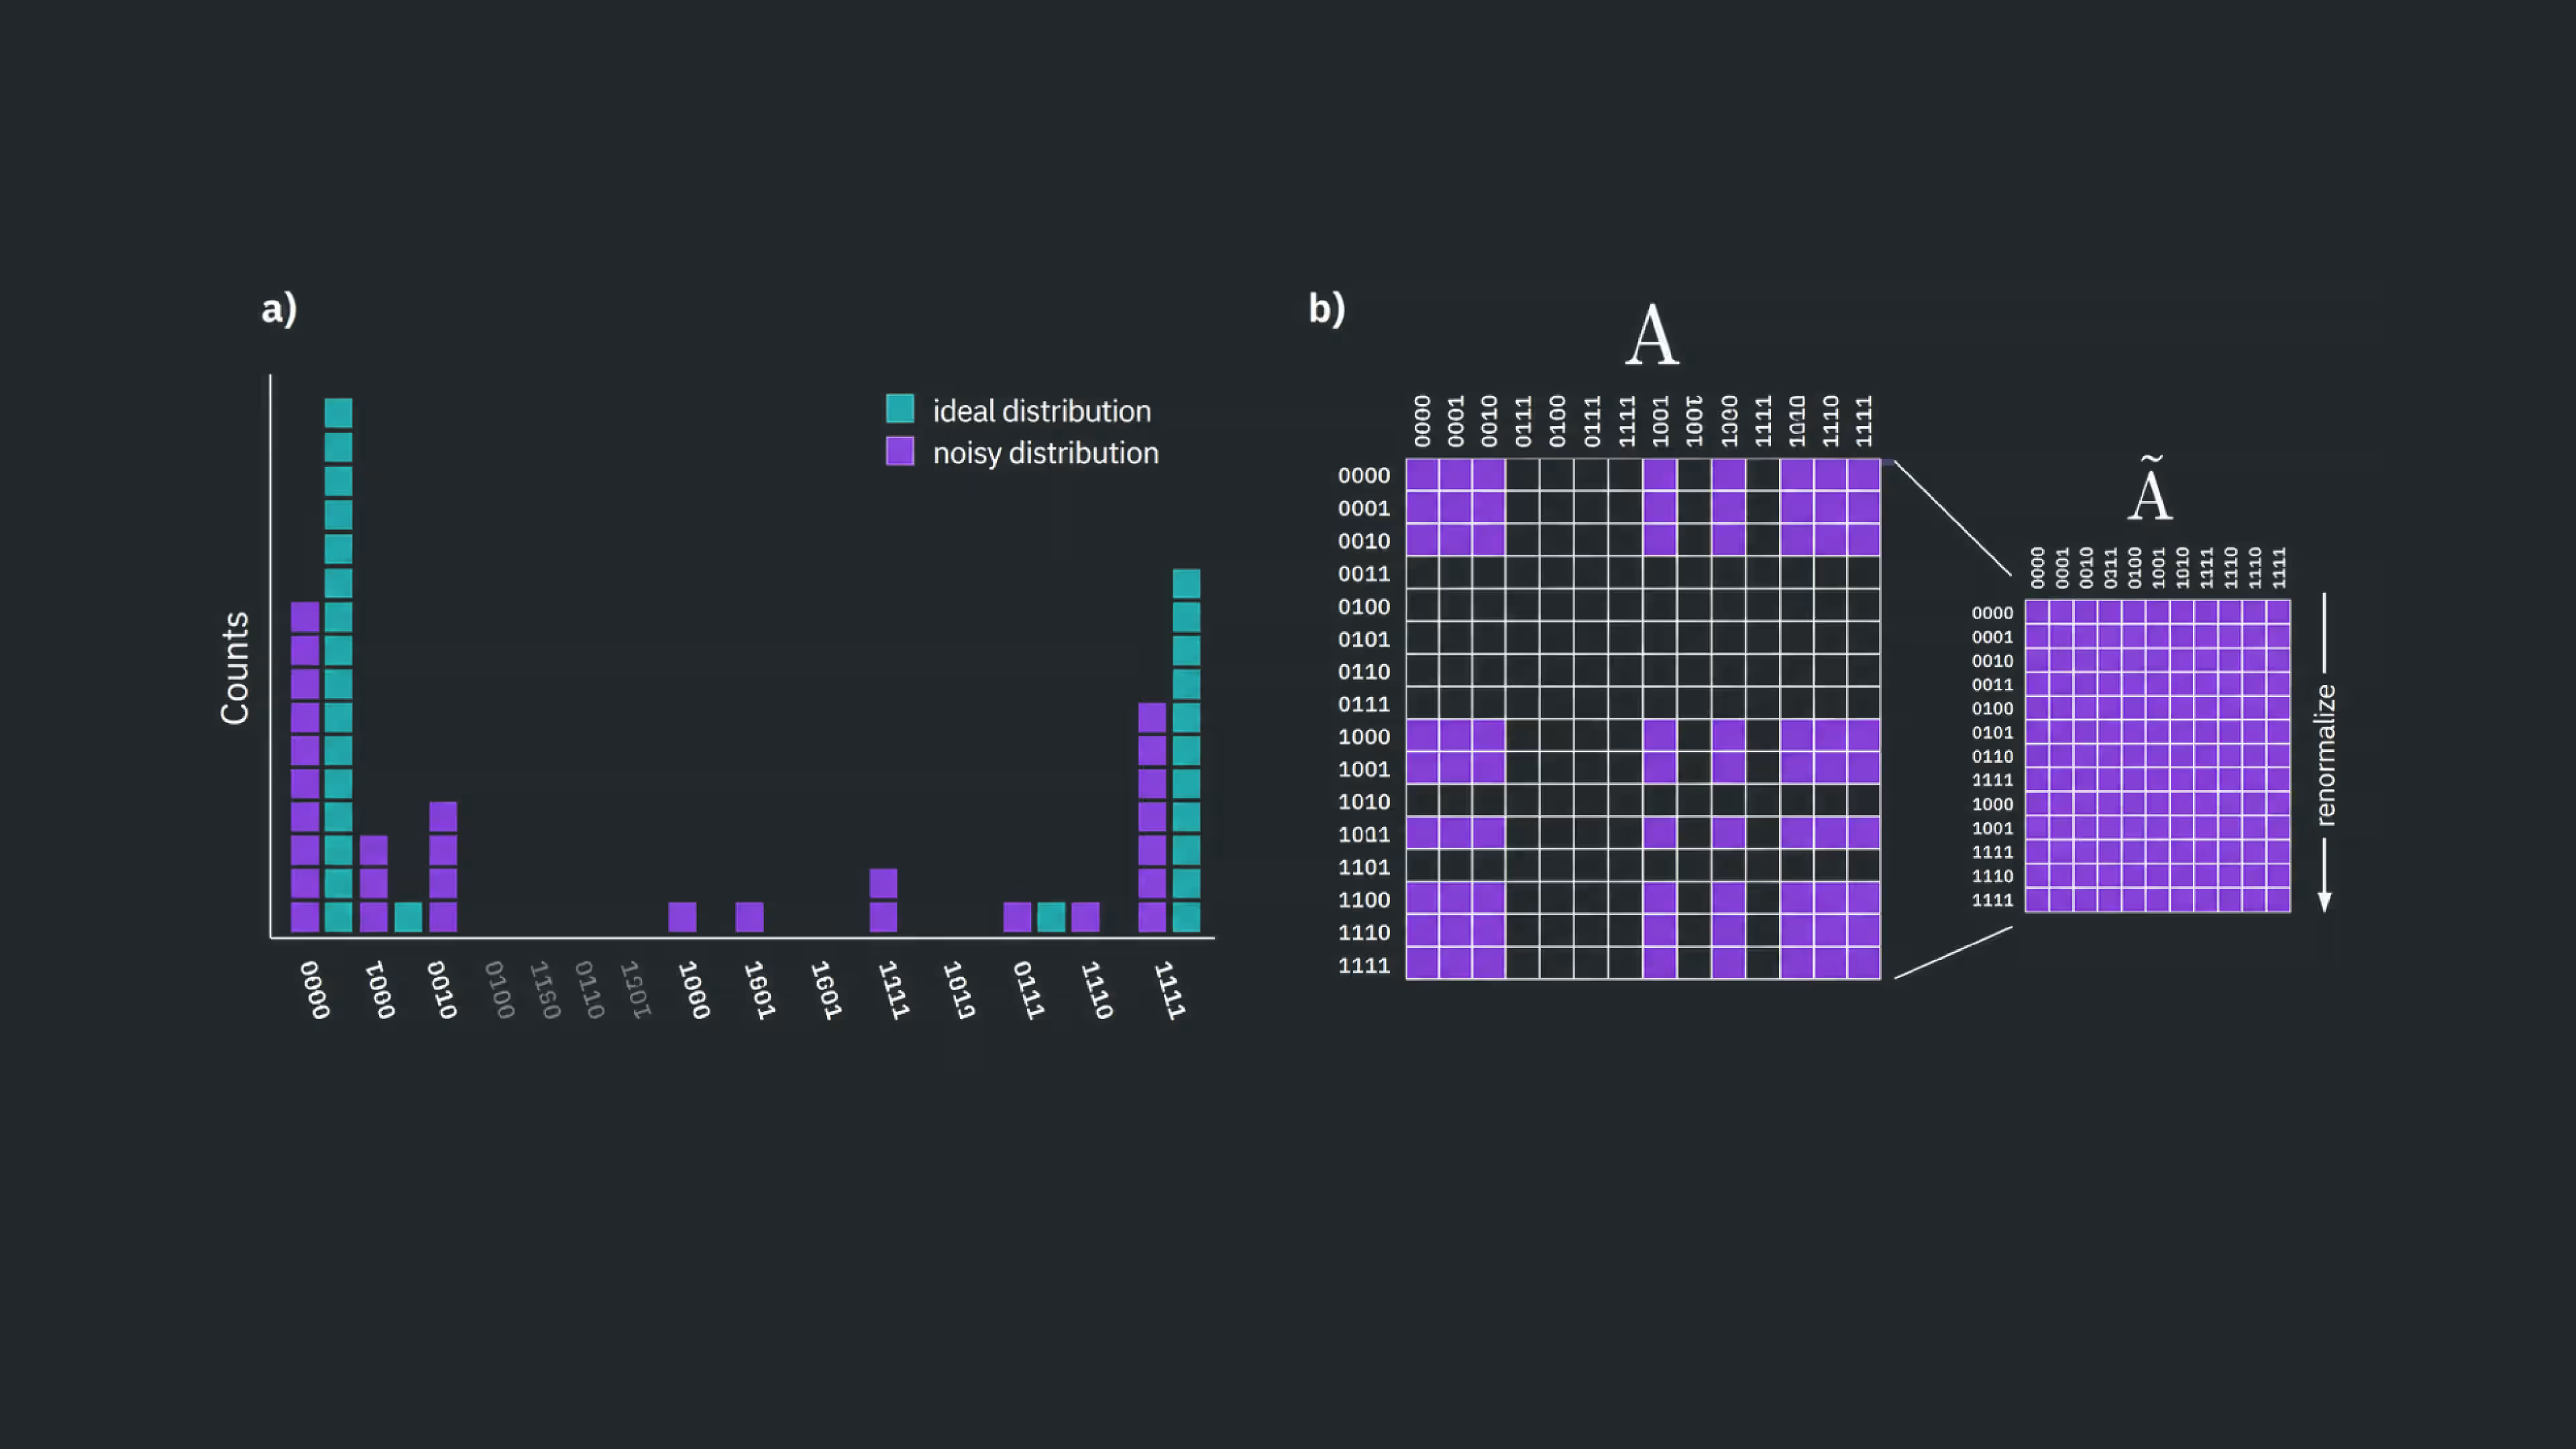
يستخدم تخفيف القياس بلا مصفوفات (M3) هذه البنية لبناء تقدير مخفَّف لـ دون تكوين المصفوفة الكاملة أو عكسها أبداً، وهو أمر غير ممكن لأعداد كبيرة من الكيوبتات. وبدلاً من ذلك، يستغل M3 حقيقة أن كثيراً من أحمال العمل الكمومية قصيرة المدى تنتج توزيعات ذات قمم حادة أو إنتروبيا منخفضة، فيركّز التخفيف فقط على مجموعة النتائج التي تسهم إسهاماً ملحوظاً في التوزيع المرصود.
لبناء نموذج الإسناد، يجب تشغيل تجارب معايرة إضافية على العتاد الكمومي. وتتضمن هذه عادةً تحضير حالات أساس حسابي معروفة وتسجيل كيفية إبلاغ نظام القياس عنها. ويتناسب حِمل المعايرة مع عدد الكيوبتات المقيسة، بينما تعتمد الكلفة الحسابية للتخفيف على بنية التوزيع المرصود. وهذه الكلفة أصغر بكثير مما يلزم لتوصيف مصفوفة الإسناد الكاملة بشكل صريح. ورغم أن حِمل المعايرة هذا حقيقي، فإنه خفيف مقارنةً بالتقنيات على مستوى الدائرة مثل الاستقراء إلى ضوضاء صفرية أو إلغاء الأخطاء الاحتمالي، مما يجعل M3 أداة عملية وشائعة الاستخدام لتخفيف أخطاء القراءة في التجارب الكمومية قصيرة المدى.
لاحظ أن المعايرة لا تفيد إلا بقدر ما تبقى عملية القياس مستقرة بما يكفي بين تشغيلات المعايرة والتجربة المستهدفة.
سننفّذ أولاً حالة بسيطة يدوياً لتوضيح طريقة العمل، ثم نستخدم الأدوات المدمجة في Qiskit لعرض استخدام M3 على نطاق أكثر واقعية.
مثال صغير على M3
نبدأ ببناء حالة Bell بسيطة.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "mthree": "mthree", "numpy": "numpy", "qiskit": "qiskit", "qiskit_aer": "qiskit-aer", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit import QuantumCircuit
import numpy as np

qc = QuantumCircuit(2, 2)
qc.h(0)
qc.cx(0, 1)
qc.measure([0, 1], [0, 1])
<qiskit.circuit.instructionset.InstructionSet at 0x714a5fa4d630>
يمكننا استخدام محاكي بنموذج ضوضاء لأننا نقتصر في هذا المثال على دائرة صغيرة جداً. نضبط نموذج الضوضاء صراحةً ليكون فيه خطأ قراءة بالشكل التالي:
if true=0: [95% chance of reading 0, 5% chance of reading 1]
if true=1: [8% chance of reading 0, 92% chance of reading 1]
معدلات أخطاء القراءة هذه أعلى بكثير مما نراه في حواسيب IBM® الكمومية الحقيقية. وقد اخترنا القيم المرتفعة لأسباب تعليمية، حتى نرى أثر M3 بوضوح.
from qiskit_aer import AerSimulator
from qiskit_aer.noise import NoiseModel, ReadoutError

ro_error = ReadoutError([[0.95, 0.05], [0.08, 0.92]])

noise_model = NoiseModel()
noise_model.add_readout_error(ro_error, [0])
noise_model.add_readout_error(ro_error, [1])

backend_noisy = AerSimulator(noise_model=noise_model)
يمكننا تشغيل الدائرة على المحاكي المضوضَء لملاحظة آثار خطأ القراءة.
result = backend_noisy.run(qc, shots=5000, seed_simulator=123).result()
raw_counts = result.get_counts()
raw_counts
{'01': 290, '11': 2165, '10': 304, '00': 2241}
في مثالنا التوضيحي، عرّفنا خطأ القراءة لنموذج الضوضاء. لكن عند استخدام حاسوب كمومي حقيقي، لا يكون خطأ القراءة معروفاً مسبقاً. بل يجب تقديره تجريبياً. ولهذا ننشئ دوائر تحضّر كيوبتاً في حالة أساس حسابي معروفة أو ثم نقيسه. وفي غياب خطأ القراءة سنقيس الحالة المحضّرة بالضبط. وبجمع إحصاءات من هذه القياسات، يمكننا بناء مصفوفة إسناد تصف خطأ القراءة. وفي هذا المثال التوضيحي، ينبغي أن تشبه المصفوفة التي عرّفناها.
في نظام أكثر واقعية، يجب تجميع الإحصاءات لكل كيوبت فيزيائي. وهذا ليس بسيطاً أحياناً، لأن عملية الترجمة (transpilation) تُسقط دائرة مجردة على العتاد فيتغير رقم الكيوبت. وسنعود إلى هذا في المثال التالي. وفي مثال المحاكي هذا، أسندنا نموذج خطأ القراءة نفسه إلى كل كيوبت، فيكفي توصيف واحد.
# Define a function to make a state and measure it.
def measure_state(state):
    qc = QuantumCircuit(1, 1)
    if state == 1:
        qc.x(0)
    qc.measure(0, 0)
    return backend_noisy.run(qc, shots=5000, seed_simulator=123).result().get_counts()
# Use the function to get statistics on readout errors
cal_counts_0 = measure_state(0)  # True state = 0
cal_counts_1 = measure_state(1)  # True state = 1

cal_counts_0, cal_counts_1
({'1': 244, '0': 4756}, {'0': 420, '1': 4580})
# Create the normalized readout error matrix

# def normalize(d):
#    s = sum(d.values())
#    return {k: v/s for k,v in d.items()}
# p0 = normalize(cal_counts_0)
# p1 = normalize(cal_counts_1)

p0 = {k: v / sum(cal_counts_0.values()) for k, v in cal_counts_0.items()}
p1 = {k: v / sum(cal_counts_1.values()) for k, v in cal_counts_1.items()}

A_1q = np.array(
    [
        [p0["0"], p1["0"]],  # row: measured 0, columns true 0/1
        [p0["1"], p1["1"]],
    ]
)
A_1q
array([[0.9512, 0.084 ],
       [0.0488, 0.916 ]])
لاحظ أن هذا قريب جداً من مصفوفة خطأ القراءة المستخدمة لبناء المحاكي.
مرة أخرى، على حاسوب كمومي حقيقي سيكون لدينا إحصاءات كهذه لعدة كيوبتات فيزيائية. أما في هذا المحاكي، فنفترض أن للكيوبتين أخطاء قراءة متطابقة ومستقلة، مما يتيح لنا بناء مصفوفة الإسناد ثنائية الكيوبت A_2q كجداء تنسوري للمصفوفات أحادية الكيوبت المقابلة. ولاحظ أيضاً أن الهدف من M3 ليس بناء مصفوفة الإسناد كاملة. بل يركّز M3 على مجموعة النتائج التي تسهم إسهاماً ملحوظاً في التوزيع المرصود. سنبني المصفوفة كاملة لمثالنا الصغير جداً لنرى كيف يعمل. إن تنفيذ M3 في qiskit-ibm-runtime أكثر تطوراً من هذا المثال التوضيحي لأنه يجب أن يتعامل مع كيوبتات كثيرة بخصائص قراءة مختلفة مع تجنب بناء مصفوفة الإسناد الكاملة.
A_2q = np.kron(A_1q, A_1q)
print(A_2q)
[[0.89794576 0.07107    0.07107    0.005625  ]
 [0.04965424 0.87653    0.00393    0.069375  ]
 [0.04965424 0.00393    0.87653    0.069375  ]
 [0.00274576 0.04847    0.04847    0.855625  ]]
في هذا المثال نفترض أن أخطاء القراءة على الكيوبتات المختلفة مستقلة، مما يتيح بناء مصفوفة الإسناد ثنائية الكيوبت كجداء تنسوري للمصفوفات أحادية الكيوبت المقابلة.
نحصل على النتائج الخام والمخفَّفة للمقارنة.
bitstrings = ["00", "01", "10", "11"]
# Normalize raw counts
raw_probs = np.array([raw_counts.get(b, 0) for b in bitstrings], dtype=float)
raw_probs /= raw_probs.sum()
raw_probs
array([0.4482, 0.0592, 0.0598, 0.4328])
في هذه المرحلة، وصّفنا تجريبياً كيف تشوّه عملية القياس احتمالات النتائج المثالية. وهدفنا الآن التراجع عن هذا التشويه وتطبيق التصحيح الناتج على الاحتمالات الخام.
لأننا نجري عكساً خطياً لا تصحيحاً فيزيائياً، فلا يلزم أن تكون "الاحتمالات" الناتجة موجبة دائماً. ومن المتوقع ظهور احتمالات شبه-احتمالية سالبة صغيرة جداً، وهي تعكس أن تخفيف القياس ينتج مقدِّراً وليس توزيعاً احتمالياً فيزيائياً.
# Explicit inversion is feasible only for very small systems
# This is why M3 avoids creating the entire A matrix.

A_inv = np.linalg.inv(A_2q)

# Note: mitigated_probs might contain negative values.
# This is expected and reflects estimator, not physical, probabilities.

mitigated_probs = A_inv @ raw_probs
print(mitigated_probs)
[ 4.96000451e-01 -4.69852308e-04 2.17747967e-04 5.04251654e-01]
نحوّل هذه إلى أعداد (counts) من أجل الرسم.
shots = sum(raw_counts.values())  # e.g., 5000
ideal_probs = [0.50, 0.00, 0.00, 0.50]  # ideal Bell distribution
# Convert probabilities to integer counts for plotting only.
# Not physically meaningful when probabilities are negative

def probs_to_counts(bitstrings, probs, shots):
    """
    Convert a probability vector into a Qiskit-style counts dictionary.
    Ensures integer shot counts and correct normalization.
    """
    counts = {}
    # First convert to raw integer counts
    int_counts = [round(p * shots) for p in probs]
    # Fix rounding error by adjusting the last entry
    diff = shots - sum(int_counts)
    int_counts[-1] += diff
    # Build dict
    for b, c in zip(bitstrings, int_counts):
        if c > 0:
            counts[b] = c
    return counts

mitigated_counts = probs_to_counts(bitstrings, mitigated_probs, shots)
ideal_counts = probs_to_counts(bitstrings, ideal_probs, shots)
أخيراً ننظر إلى التوزيعات الخام والمخفَّفة والمثالية. إن "الأعداد" المخفَّفة أدناه مجرد وسيلة مساعدة للتصور، حصلنا عليها بإعادة تحجيم الاحتمالات شبه-الاحتمالية المخفَّفة.
from qiskit.visualization import plot_histogram

plot_histogram(
    [raw_counts, mitigated_counts, ideal_counts],
    legend=["Raw", "Mitigated", "Ideal"],
    sort="asc",
    title="Raw vs Mitigated vs Ideal",
)
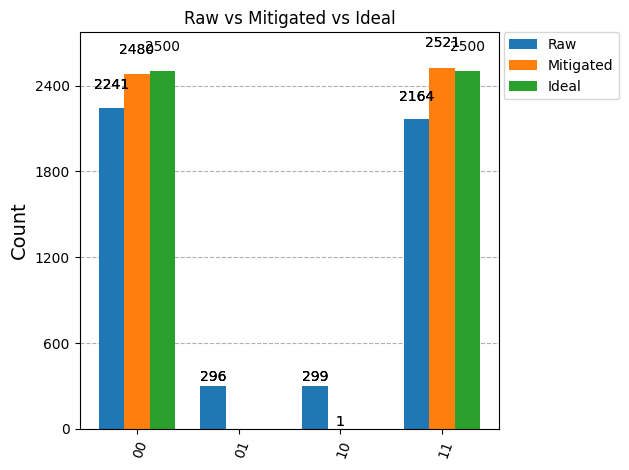
من الواضح أن نتائج M3 المخفَّفة أقرب بكثير إلى التوزيعات المثالية، ويمكننا أن نرى السبب.
تطبيق M3 على سير عمل أكثر واقعية أكثر تعقيداً بكثير. لاحظ ما يلي:
- تحتوي الحواسيب الكمومية الحقيقية على كيوبتات فيزيائية كثيرة، لكل منها خصائص خطأ قراءة خاصة به. ويجب نمذجة هذه الأخطاء ودمجها بشكل مناسب.
- تنمو مصفوفة الإسناد الكاملة أسياً مع عدد الكيوبتات وسرعان ما يصبح بناؤها صراحةً غير عملي. ولهذا يركّز M3 على مجموعة النتائج التي تسهم إسهاماً ملحوظاً في التوزيع المرصود بدلاً من بناء مصفوفة الإسناد كاملة.
- في المسائل الحقيقية محل الاهتمام، قد لا يكون التوزيع المثالي معروفاً.
لكل هذه الأسباب، يُغلَّف سير عمل التخفيف الكامل في إضافة Qiskit المسماة mthree.
مثال أكبر على M3
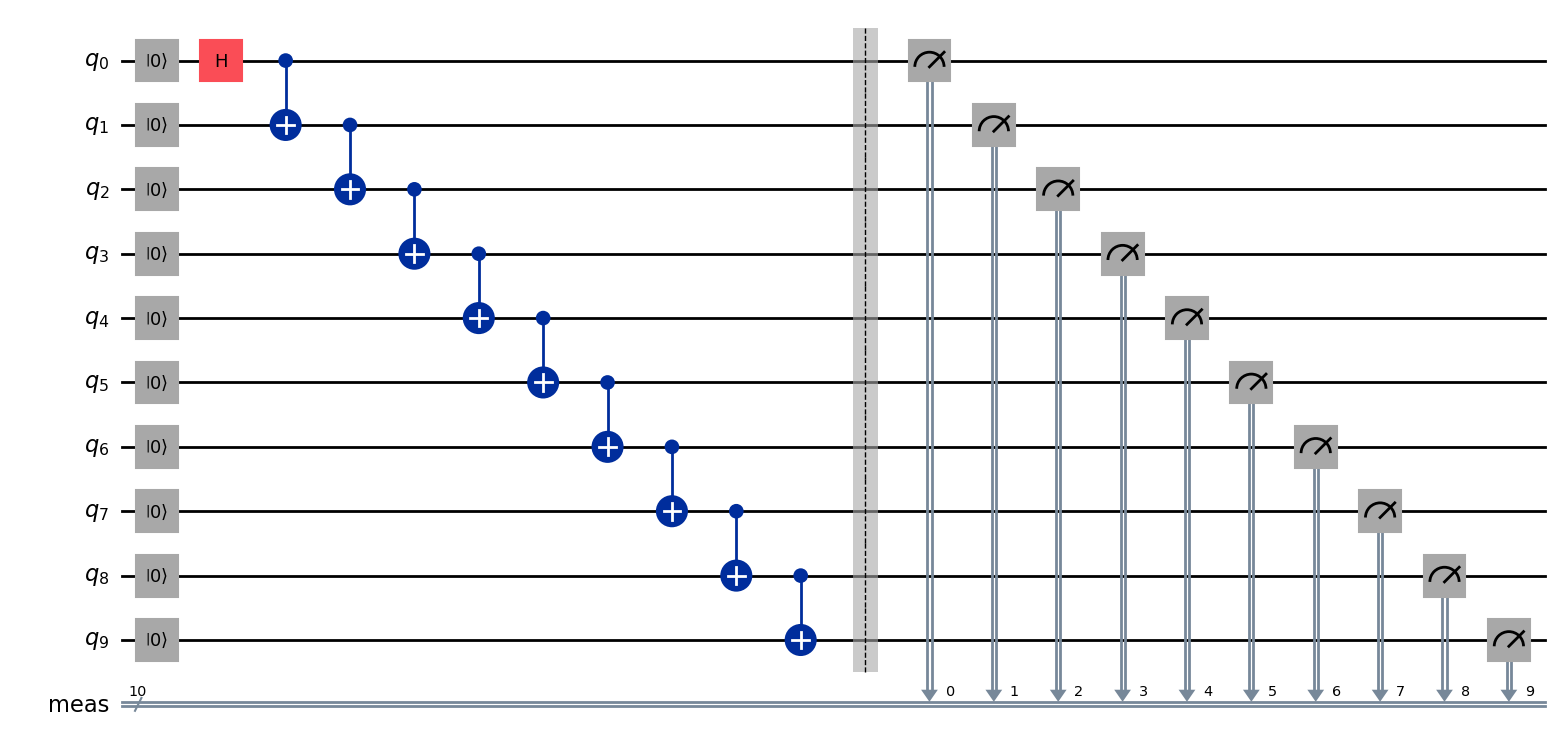
نطبّق الآن M3 على دائرة أكبر، يكون تحديد الفضاء الجزئي ذي الصلة من فيها يدوياً مرهقاً، لكنها لا تزال بسيطة بما يكفي لنعرف التوزيع المثالي: حالة GHZ. نبدأ باستيراد الحزمة mthree وتعريف دائرة GHZ الكمومية.
import numpy as np
from qiskit import QuantumCircuit

# from qiskit_ibm_runtime.fake_provider import FakeCasablancaV2
import mthree

num_qubits = 10

qc = QuantumCircuit(num_qubits)
qc.reset(range(num_qubits))
qc.h(0)
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)
qc.measure_all()
qc.draw("mpl")
لتشغيل هذا على حاسوب كمومي حقيقي، نستورد qiskit_ibm_runtime والحزم الضرورية الأخرى. نستخدم SamplerV2 للحصول على توزيع للمخرجات.
# Import packages needed for using real quantum computers

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime.executor_sampler import SamplerV2 as Sampler
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

# --------- Configuration ----------
service = QiskitRuntimeService(channel="ibm_quantum_platform", instance="your crn here")

# backend_real = service.backend("ibm_fez")     # adjust if needed
backend_real = service.least_busy(simulator=False, operational=True)
الآن نترجم (transpile) الدائرة إلى الـ Backend لدينا. نضبط مستوى التحسين على 0 هنا لنركّز على آثار M3 دون إضافة أدوات أخرى. وهذا يعني أن الدقة (fidelity) النهائية لن تمثّل ما يمكن بلوغه على عتاد IBM Quantum® باستخدام المجموعة الكاملة من الأدوات المتاحة، لكنه يتيح لنا التركيز تحديداً على فائدة M3.
# Exclude any optimization to focus only on M3 effects
opt_level = 0
pm = generate_preset_pass_manager(optimization_level=opt_level, backend=backend_real)
qc_isa = pm.run(qc)
نضبط الآن الـ Sampler، مع تعطيل تقنيات كبت الأخطاء الإضافية مثل الفصل الديناميكي (dynamical decoupling) والالتفاف العشوائي (twirling).
shots = 8192

# No twirling
sampler_no_twirl = Sampler(mode=backend_real)
sampler_no_twirl.options.twirling.enable_gates = False
sampler_no_twirl.options.twirling.enable_measure = False
sampler_no_twirl.options.default_shots = shots
sampler_no_twirl.options.dynamical_decoupling.enable = False
أخيراً، ننفّذ المهمة (job).
# This job took 7 seconds on ibm_fez. Your actual execution time can vary.
job = sampler_no_twirl.run([qc_isa])
res_real = job.result()
job_id = job.job_id()
print("job number for real  ", job_id)
job number for real d7ark4e5nvhs73a2fu6g
يمكننا استخراج الأعداد الخام من الدائرة أعلاه.
counts_real = []
for i in range(len(res_real)):
    counts_real.append(res_real[i].data.meas.get_counts())
نشغّل الآن mthree على الـ Backend لدينا لتوصيف نموذج الإسناد المستخدم في تخفيف القياس. ونعيد تحجيم التوزيع الخام باستخدام تلك المعلومات. لاحظ أن هذا قد ينتج أحياناً احتمالات سالبة صغيرة جداً (ومن هنا مصطلح الاحتمالات شبه-الاحتمالية).
# Added 6 sec on ibm_fez, on top of original 7 sec to run circuits. Your time might differ.
mit_real = mthree.M3Mitigation(backend_real)
mappings_real = mthree.utils.final_measurement_mapping(qc_isa)
mit_real.cals_from_system(mappings_real)
quasis_real = mit_real.apply_correction(counts_real, mappings_real)
ينتج تصحيح mthree احتمالات شبه-احتمالية بدلاً من أعداد. ويمكننا إعادة التحجيم إلى أعداد يدوياً. تحوّل الدالة المساعدة أدناه إلى أعداد وتقرّبها إلى قيم صحيحة. كذلك، في الدوائر الكبيرة ستوجد سلاسل خاطئة كثيرة ذات أعداد قليلة جداً لكنها تُزدحم بها المخططات التكرارية. وتحذف الدالة المساعدة الثانية أدناه أي سلاسل أعدادها أقل من عتبة نختارها، لنحصل على رؤية واضحة للحدود المهيمنة في التوزيع.
def quasidistribution_to_counts(quasi_list, shots):
    return [
        {bitstr: int(round(float(prob) * shots)) for bitstr, prob in quasi.items()}
        for quasi in quasi_list
    ]

def filter_counts_by_threshold(counts_list, t):
    filtered = []

    for counts in counts_list:
        new_counts = {}
        for bitstr, val in counts.items():
            c = int(round(float(val)))  # FORCE conversion
            if abs(c) >= t:
                new_counts[bitstr] = c
        filtered.append(new_counts)

    return filtered
quasi_counts = quasidistribution_to_counts(quasis_real, shots)
trim_threshold = 30
trimmed_quasi = filter_counts_by_threshold(quasi_counts, trim_threshold)
trimmed_raw = filter_counts_by_threshold(counts_real, trim_threshold)
يمكننا أيضاً بسهولة إنتاج التوزيع النظري المثالي الذي تتساوى فيه احتمالات حالتي الأصفار كلها والواحدات كلها، ويكون الاحتمال صفراً لكل النتائج الأخرى، وذلك للمقارنة.
ideal = [
    {
        "0" * num_qubits: int(round(float(shots) / 2)),
        "1" * num_qubits: int(round(float(shots) / 2)),
    }
]
أخيراً، يمكننا تصوّر نتائجنا.
from qiskit.visualization import plot_histogram

plot_histogram(
    [trimmed_raw[0], trimmed_quasi[0], ideal[0]],
    legend=["Raw", "Mitigated", "Ideal"],
    sort="asc",
    title="Raw vs Mitigated vs Ideal",
)
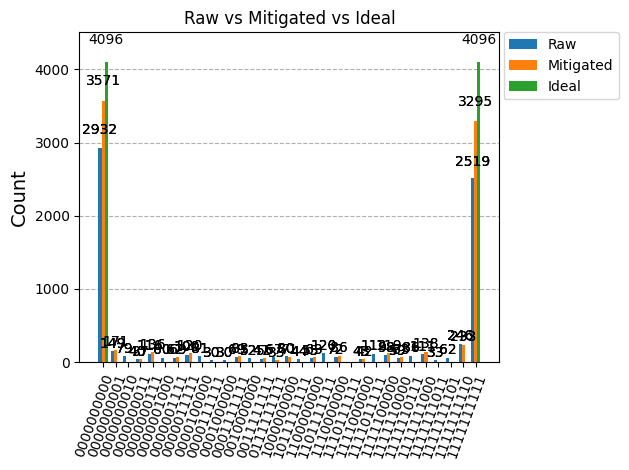
النتائج المخفَّفة أقرب إلى التوزيع المثالي من النتائج غير المخفَّفة. ويمكننا قياس ذلك بشكل أفضل باستخدام أعداد سلاسل البتات المثالية.
def extract_all_zero_and_all_one(counts):
    """
    Extract counts for the all-0 and all-1 bitstrings.

    Parameters
    ----------
    counts : dict[str, int]
        Counts dictionary.

    Returns
    -------
    dict[str, int]
        Dictionary containing only 00...0 and 11...1 entries if present.
    """
    n = len(next(iter(counts)))  # infer bitstring length
    zero_state = "0" * n
    one_state = "1" * n

    return {k: counts[k] for k in (zero_state, one_state) if k in counts}

correct_counts_raw = extract_all_zero_and_all_one(trimmed_raw[0])
correct_counts_mitigated = extract_all_zero_and_all_one(trimmed_quasi[0])
keys = ["0" * num_qubits, "1" * num_qubits]
fidelity_raw = (
    correct_counts_raw.get(keys[0]) + correct_counts_raw.get(keys[1])
) / shots
fidelity_mit = (
    correct_counts_mitigated.get(keys[0]) + correct_counts_mitigated.get(keys[1])
) / shots
print("Percent correct raw counts: ", fidelity_raw)
print("Percent correct mitigated counts: ", fidelity_mit)
Percent correct raw counts:  0.6654052734375
Percent correct mitigated counts:  0.838134765625
حسّنت هذه الأداة البسيطة دقتنا بنسبة 26% مقارنةً بالدقة غير المخفَّفة، بحِمل منخفض نسبياً. ومن الواضح أن M3 يمكن أن يكون ذا قيمة كبيرة. لكننا اخترنا دائرة GHZ لأنها حالة استخدام جيدة، إذ لها قمتان حادتان على حالتي خرج. بعض المسائل تنتج أعداداً موزعة بشكل أكثر تساوياً (حالات ذات إنتروبيا عالية). وفي الدوائر العميقة جداً ذات الكيوبتات الكثيرة، غالباً ما تؤدي أخطاء البوابات والضوضاء غير المرتبطة بأخطاء القياس إلى حالة عالية الإنتروبيا. وفي مثل هذه الحالات يعمل M3 على فضاء حالات كبير جداً. وهناك ثلاثة مقاربات ممكنة لذلك:
(1) تقبّل أن هذا قيد في M3.
(2) لاحظ أن الحد الأعلى لفضاء المصفوفة التي يكوّنها M3 هو num_shots num_shots، بدلاً من ، والأول أصغر بكثير عندما يكون عدد الكيوبتات كبيراً.
(3) بحذر شديد فقط، احذف سلاسل البتات ذات الاحتمال المنخفض جداً من الأعداد الخام المُدخلة إلى M3. قد يُدخل هذا انحيازاً، وقد يتعارض تقييد دعم حالاتك مع التقارب في مقاربات مثل طريقة Krylov. ولا ينبغي فعل ذلك إلا عندما تعرف بالضبط لماذا تفعله وتستطيع توقع كل آثاره. ولهذا السبب ليس هذا الاقتطاع ميزة مدمجة في M3.
لمزيد من المعلومات عن إضافة Qiskit المسماة mthree، راجع الأمثلة وتعليمات التثبيت والخلفية ومراجع API في التوثيق.
استئصال أخطاء القراءة بالالتفاف العشوائي (TREX)
استئصال أخطاء القراءة بالالتفاف العشوائي (TREX) هو تقنية لتخفيف أخطاء القياس تُستخدم في الحواسيب الكمومية الحديثة. هدفه إزالة الانحياز الناتج عن أخطاء القراءة الكلاسيكية دون الحاجة إلى توصيف كامل لمصفوفة إسناد القياس أو عكسها.
TREX ليس تصحيحاً للأخطاء ولا يحسّن دقة الحالة. بل يضمن أن مقدِّرات القيم المتوقعة غير متحيزة بالنسبة لضوضاء القراءة، حتى حدود الخطأ الإحصائي، وذلك بالمتوسط على أسس قياس عشوائية وإعادة التحجيم. وعلى عتاد IBM Quantum، يُعدّ TREX طريقة التخفيف الافتراضية لتقدير القيم المتوقعة ويقابل resilience_level = 1 في الأولية (primitive) Estimator من IBM Quantum.
طبيعة أخطاء القراءة في العتاد فائق التوصيل
في كيوبتات IBM فائقة التوصيل، تهيمن على أخطاء القراءة العوامل التالية:
-
احتمالات انقلاب بت غير متناظرة (على سبيل المثال، أكثر تكراراً من العكس)
-
استرخاء يعتمد على الحالة أثناء القياس نفسه
-
حديث متبادل (crosstalk) خفيف لكنه غير مهمل بين مرنانات القراءة المتجاورة
والمهم أنه يمكن غالباً نمذجة هذه الأخطاء كعملية عشوائية كلاسيكية تؤثر في نتائج القياس. ويستغل TREX فكرة معيارية من تكييف الضوضاء: عشوَنة (التفاف) إجراء القياس. وعادةً ما يسير TREX في مرحلتين:
-
الالتفاف و"فكّ الالتفاف" الكلاسيكي
-
إعادة تحجيم القيم المتوقعة باستخدام دوائر المعايرة
لنفترض أن القيمة المتوقعة للمرصود ترتبط بتقديرات مضوضَأة، على النحو التالي:
حيث عامل ثابت يحجّم التقدير و انحياز ناتج عن المصادر الموصوفة أعلاه. نستخدم هنا تذكيراً بأننا نعالج خطأ القراءة فقط هنا؛ وما زال هناك خطأ البوابات الذي يجب أخذه في الحسبان.
قبل القياس مباشرةً، يُقرَن كل كيوبت عشوائياً بمشغّل باولي (مثل I أو X). وتُفكّ التفاف نتائج القياس كلاسيكياً بعد ذلك.
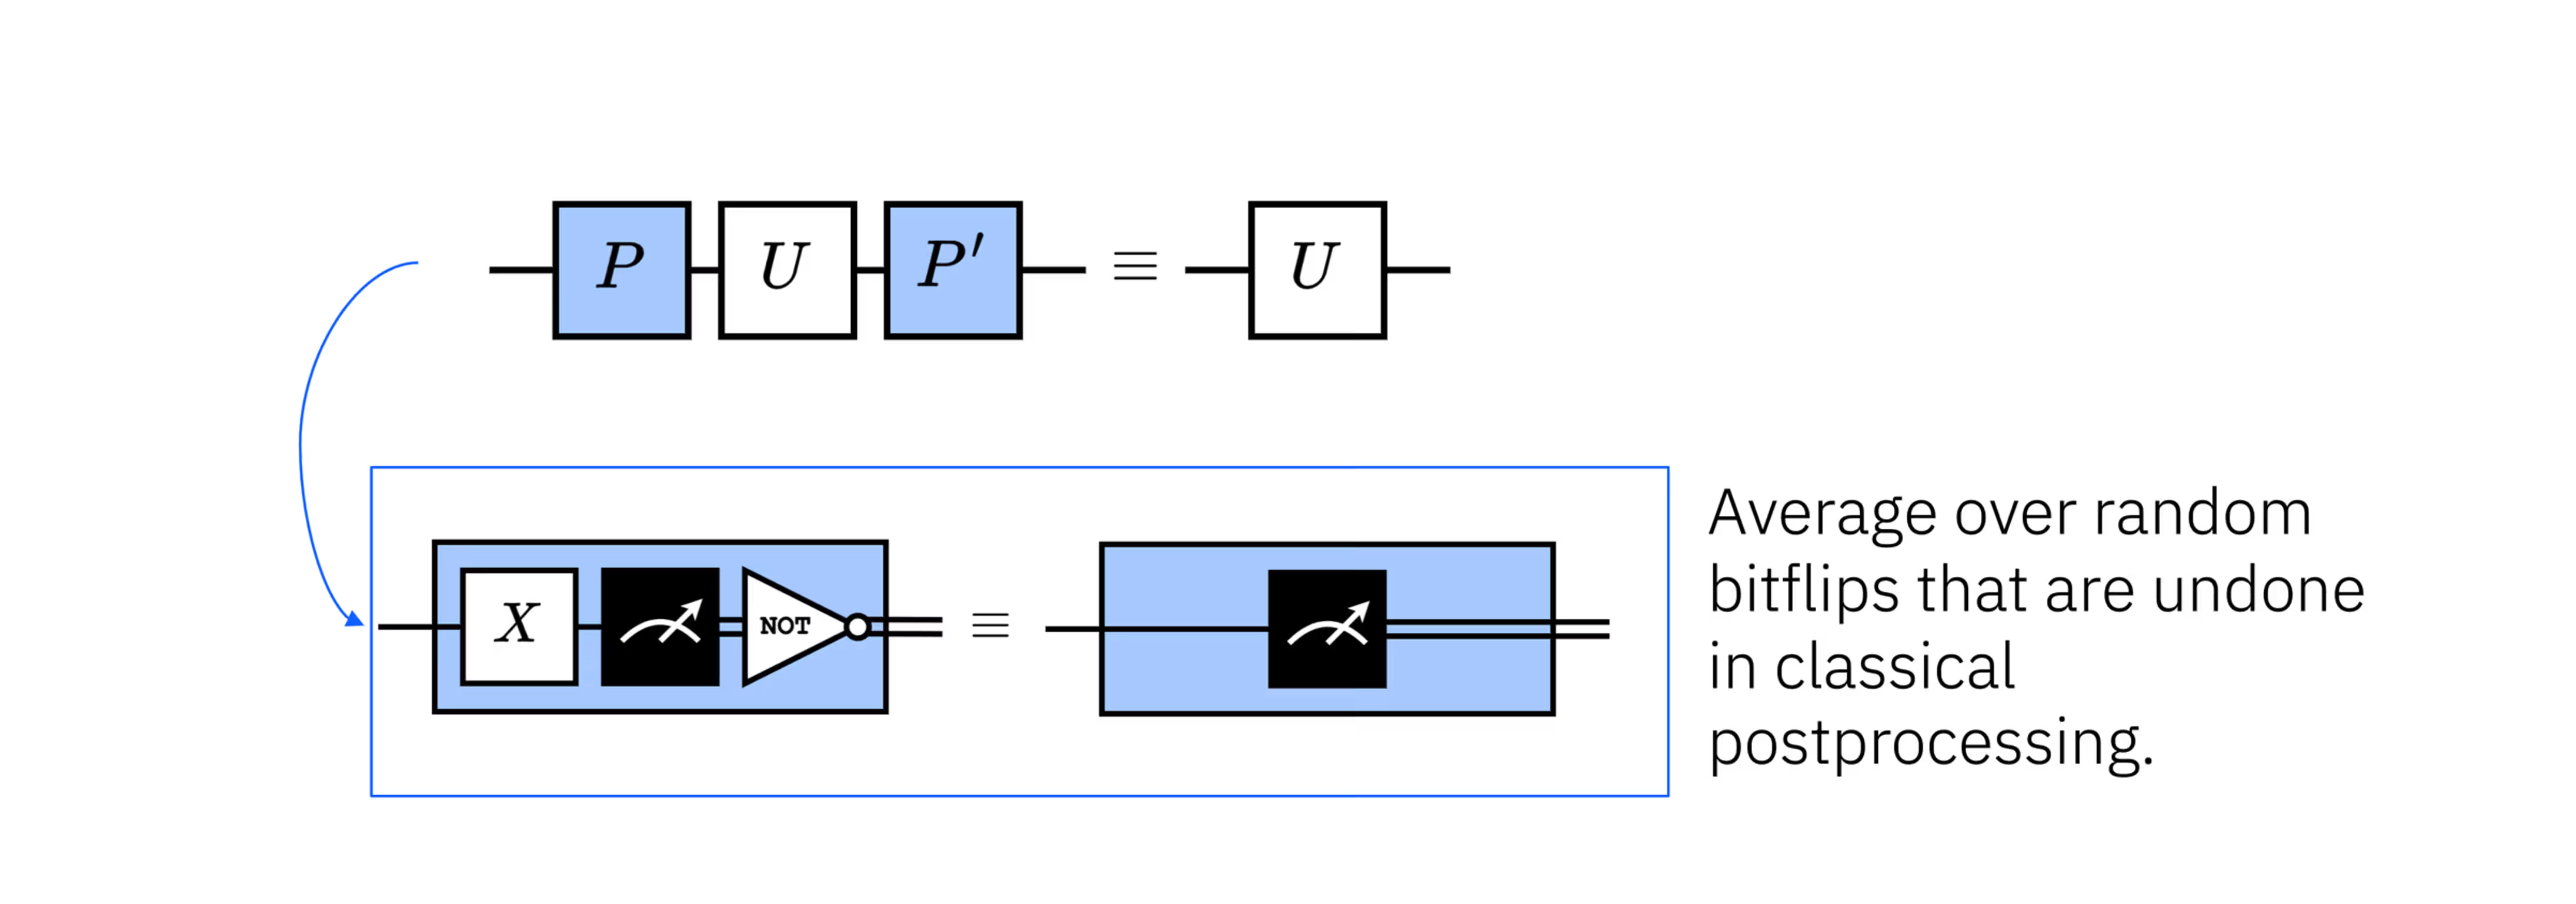
يؤدي المتوسط على هذه العشوائيات إلى تناظر قناة القراءة. ونتيجة لذلك، تتحول اللاتناظرات المنهجية في عملية القراءة إلى قناة خطأ أكثر تناظراً يمكن معالجة أثرها المتبقي بالمعايرة وإعادة التحجيم. وببساطة، لو كان هناك مثلاً انحياز نحو الحالة ، فسنفقد بعض قياسات . وبالالتفاف حول القياس، نبدّل عشوائياً أي نتيجة منطقية ترتبط بعملية القراءة الفيزيائية، ثم نتراجع عن هذا التبديل كلاسيكياً بعد ذلك. والمتوسط على قياسات عشوائية كثيرة كهذه يزيل التفضيل المنهجي لنتيجة مُبلَّغ عنها على الأخرى. وهذا يزيل انحياز القياس المهيمن في ظل افتراضات نموذج TREX، فيكون لدينا:
لكن قد تظل القيم المتوقعة بحاجة إلى إعادة تحجيم. والمرحلة الثانية هي استخدام دوائر المعايرة (دوائر ذات نتائج معروفة) لتقدير عامل التحجيم . ويمكن بعد ذلك استخدامه للحصول على تقدير محسّن بدرجة كبيرة.
تصبح القيم المتوقعة لمرصودات باولي مقدِّرات غير متحيزة لقيمها المثالية. ولا يُتعلَّم نموذج ضوضاء صريح ولا يُعكس، ولهذا فإن TREX مستقر عددياً وغير مكلف. ومرة أخرى، لم يُعالَج خطأ البوابات هنا.
في تقدير القيمة المتوقعة للمرصود ، قد يوجد تباين ناتج عن أخذ العيّنات المحدود، وقد توجد أنواع كثيرة من الأخطاء غير المترابطة والمترابطة، وقد يوجد أيضاً انحياز ناتج عن خطأ القراءة. وينشأ هذا الانحياز من مصادر مثل الانتقالات غير المتناظرة التي ناقشناها. وعملياً، يُنمذَج هذا الانحياز عادةً جيداً كقناة عشوائية كلاسيكية تعمل بعد التطور الكمومي. ويحوّل TREX قناة القياس الفعالة بحيث يكون مقدِّر غير متحيز بالنسبة لخطأ القراءة. ومن السهل نسبياً رؤية ذلك باستخدام أبسط مثال لبوابات الالتفاف: X. فإذا وُجد لاتناظر بين و، لكننا بدّلنا عشوائياً أي حالة تُقرأ (مع العكس لاحقاً كلاسيكياً)، فهذا يزيل اللاتناظر المنهجي بوضوح (مع أن أخذ العيّنات المحدود يعني أنه قد يبقى لاتناظر عشوائي طفيف في القياس). وعملياً، لا تقتصر بوابات الالتفاف في TREX على I وX، لكن هذا يكفي للتوضيح.
يتيح لنا TREX الحصول على تقدير للقيمة المتوقعة خالٍ من الانحياز الناتج عن خطأ القراءة. وقد يبقى انحياز من مصدر آخر (مثل الدوران الزائد المترابط)؛ فـ TREX يستهدف القراءة فقط. ولأن TREX يستبدل الانحياز المنهجي بتناظر عشوائي، فإنه يحوّل الانحياز عموماً إلى تباين عشوائي إضافي، مما يزيد تباين المقدِّر عند كلفة أخذ عيّنات ثابتة.
اختبر فهمك
لنفترض أننا نستخدم estimator على دائرة حضّرت الحالة في تقدير . ولنفترض كذلك أن أخطاء القياس تجعل النتائج المقابلة لـ تُبلَّغ على أنها بنسبة 10% من الوقت، بينما تُبلَّغ النتائج المقابلة لـ على أنها بنسبة 1% فقط. ويُدخل اللاتناظر بين أخطاء الإبلاغ هذه انحيازاً في القياس.
(أ) في غياب أي أخطاء قياس كهذه، ما القيمة المتوقعة المثالية للمرصود ؟
(ب) مع أخطاء القياس أو القراءة غير المتناظرة، ما القيمة المتوقعة للمرصود ؟
(ج) لننظر في مجموعة محدودة من بوابات باولي للالتفاف: I وX. افترض أن I وX تُطبَّقان عشوائياً باحتمال 50% في لقطات (shots) متعددة. وما زالت معدلات أخطاء القياس نفسها سارية. ثم تُلغى بوابة باولي (I أو X) كلاسيكياً. أنشئ جدولاً بكل النتائج الممكنة واحتمالاتها الناتجة عن التراكب الابتدائي وأخطاء القياس غير المتناظرة وبوابات باولي المسندة عشوائياً.
(د) استخدم الجدول لتحديد القيمة المتوقعة باستخدام استراتيجية الالتفاف.
(هـ) قارن القيم المتوقعة: المثالية، وبدون الالتفاف، ومع الالتفاف.
(و) ما الذي أُغفل في هذه المعالجة ويوجد في تطبيق TREX الكامل؟
الإجابة
(أ) يمكنك ببساطة استخدام الحدس والتناظر لتقول إن . ولإثبات ذلك صراحةً:
(ب) يمكن أن تنهار الحالة إلى أو عند القياس، بفرصة 50% لكل منهما. لكن من الـ 50% التي تنهار إلى الحالة ، سيُبلَّغ عن 1% منها (أو 0.5% من كل الحالات) خطأً على أنها . ومن الـ 50% التي تنهار إلى ، سيُبلَّغ عن 10% (أو 5% من كل الحالات) خطأً على أنها . وهذا يتركنا مع:
- 54.5%
- 45.5% ومع تجاهل كل الأنواع الأخرى من الأخطاء الممكنة، سنحصل على تقدير قدره
(c)
| Pauli | Ideal measurement outcome | Outcome after Pauli | Readout error | Undo Pauli | Final reported outcome | Probability |
|---|---|---|---|---|---|---|
| I | 0 | 0 | None | I | 0 | 50% 50% 99% = 24.75% |
| I | 0 | 0 | I | 1 | 50% 50% 1% = 0.25% | |
| I | 1 | 1 | None | I | 1 | 50% 50% 90% = 22.5% |
| I | 1 | 1 | I | 0 | 50% 50% 10% = 2.5% | |
| X | 0 | 1 | None | X | 0 | 50% 50% 90% = 22.5% |
| X | 0 | 1 | X | 1 | 50% 50% 10% = 2.5% | |
| X | 1 | 0 | None | X | 1 | 50% 50% 99% = 24.75% |
| X | 1 | 0 | X | 0 | 50% 50% 1% = 0.25% |
(د) من الأجزاء السابقة، نعرف القيم المتوقعة لـ Z في كل من الحالات النهائية. ولا علينا سوى أخذ المتوسط الموزون:
(هـ) في هذه الحالة البسيطة جداً، استعاد تطبيقنا للالتفاف القيمة المتوقعة المثالية بالضبط. وهذا ليس معتاداً. المعتاد أن الالتفاف يلغي الانحيازات مثل تلك الناتجة عن الانتقالات غير المتناظرة، ويعيد قيمة متوقعة أقرب إلى المثالية.
(و) هذا تطبيق على نموذج توضيحي. وقد تكون هناك أشياء عدة ناقصة. وأبرزها أننا لم نشغّل دوائر معايرة هنا لتقدير عامل إعادة التحجيم . وهذا ضروري عادةً.
تفاصيل التنفيذ
يُطبَّق TREX تلقائياً عند استخدام الأولية EstimatorV2 مع resilience_level = 1 (وهو الافتراضي). لاحظ أنه لا يُطبَّق تلقائياً على الأولية Sampler، لأن Sampler تُرجع توزيعات احتمالية كاملة بدلاً من قيم متوقعة.
عند تفعيل TREX، يولّد وقت التشغيل (runtime) متغيرات للدائرة ملتفة القياس بإدراج مشغّلات باولي عشوائية أحادية الكيوبت قبل القياس مباشرةً. وتعكس المعالجة اللاحقة الكلاسيكية هذه المشغّلات. وهذه المتغيرات عشوائية عبر اللقطات المختلفة وعبر الكيوبتات المختلفة ضمن اللقطة الواحدة. ثم تُدمج كل متغيرات الدائرة في مقدِّر واحد.
TREX قابل للتوسع جداً. فهو يتطلب دوائر معايرة إضافية، بحيث يكون حِمل أخذ العيّنات عادةً عاملاً ثابتاً صغيراً (غالباً 2-4 أضعاف). لكن التخفيف خاص بالمرصود، ولا يحافظ على التوزيع.
صُمّم TREX ليتكامل بسلاسة مع كثير من طرق كبت الأخطاء وتخفيفها، ومنها ما يلي:
-
الفصل الديناميكي (DD) - يعمل خلال أوقات الخمول، ومتعامد مع تخفيف القراءة.
-
الالتفاف بالبوابات أو بباولي - غالباً ما يكون مكمّلاً؛ فـ TREX يعتمد أصلاً على الالتفاف لكنه يستهدف ضوضاء القراءة فقط.
-
الاستقراء إلى ضوضاء صفرية (ZNE) - يستهدف ZNE ضوضاء البوابات، بينما يعالج TREX انحياز القياس. ويُستخدم هذا الجمع عند مستوى المرونة (resilience level) 2.
-
تضخيم الأخطاء الاحتمالي وإلغاء الأخطاء الاحتمالي في سير عمل Estimator.
لكن بعض الطرق لا يمكن (أو لا ينبغي) دمجها مع TREX:
-
تصحيح الاحتمالات على مستوى Sampler: لا يُرجع TREX احتمالات سلاسل بتات مصحّحة.
-
التخفيف اللاحق على بيانات TREX المخفَّفة أصلاً: قد يعيد التصحيح المزدوج إدخال الانحياز.
دمج TREX مع تخفيف أخطاء القراءة المعتمد على مصفوفة الإسناد مثل M3 أمر معقد. يفترض M3 قناة قياس ثابتة. أما TREX فيجعل القياس عشوائيًا عن قصد، مما يُبطل الافتراض الذي يعتمد عليه M3. بهذا المعنى لا يمكنك ببساطة دمج هاتين التقنيتين. ومع ذلك، إذا طبّقت الالتفاف العشوائي للقياس (measurement twirling) أثناء المعايرة المستخدمة في M3، فقد تتمكن من الاستفادة في الوقت نفسه من نهج شبيه بمصفوفة الإسناد ونهج تخفيف يعتمد على الالتفاف العشوائي (مع أن نهج الالتفاف العشوائي هذا ليس مطابقًا تمامًا لـ TREX). هذه فكرة متكررة عند دمج تقنيات التخفيف والكبت: إضافة التقنيات بشكل أعمى تفشل، أما إضافتها بحذر بحيث تكون "واعية" ببعضها فقد تنجح وقد تكون مفيدة جدًا.
يضمن TREX فقط قيم توقّع خالية من الانحياز الناتج عن أخطاء القراءة؛ فهو لا يقلل التباين، ولا يحمي من أنواع الانحياز الأخرى. وهو بالتأكيد لا يصحح كل الأخطاء. لكنه غالبًا تحسين كبير، ويمكن تحقيقه بكلفة إضافية أقل بكثير من بعض الطرق الأخرى التي تتطلب تعلّم نماذج ضوضاء كاملة. غالبًا ما يكون TREX أرخص وأمتن طريقة لتخفيف أخطاء القراءة، مما يجعله خيارًا افتراضيًا ممتازًا في التجارب.
TREX مع Qiskit
هنا ننشئ دارة بسيطة من كيوبتين، ونستخدم Estimator لتقدير قيمة التوقّع لمرصود بسيط جدًا هو ZX. قيمة التوقّع المثالية هي 1. سنقارن قيم التوقّع مع TREX وبدونه.
# Import packages needed for using real quantum computers

from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit_ibm_runtime import QiskitRuntimeService, EstimatorV2, Session
import numpy as np

# --------- Configuration ----------

backend = service.backend("ibm_fez")  # adjust if needed
أنشئ الدارة الكمّية البسيطة.
qc = QuantumCircuit(2)
qc.x(0)
qc.h(0)
qc.cx(0, 1)
qc.h(0)
qc.barrier()
qc.draw("mpl")

ترجِم الدارة باستخدام مدير تمريرات (pass manager).
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

pass_manager = generate_preset_pass_manager(optimization_level=1, backend=backend)

qc_t = pass_manager.run(qc)
طبّق على المرصود نفس التخطيط الناتج عن الترجمة.
# Observable: X on qubit 0, Z on qubit 1, ideal expectation value is 1.0.
observable = SparsePauliOp("ZX")
observable_t = observable.apply_layout(qc_t.layout)
شغّل التجربة على حاسوب كمّي حقيقي. نبدأ أولًا بـ reslience_level = 1؛ وهذه هي القيمة الافتراضية، لكننا كتبناها صراحةً للتمييز بين الحالتين.
# First, we run this on an ideal simulator to confirm the ideal expectation value.

from qiskit.primitives import StatevectorEstimator as Estimator

estimator = Estimator()

job = estimator.run(pubs=[(qc, observable)])

res = job.result()
val = res[0].data.evs

print("⟨ZX⟩ ideal:", val)
⟨Z₀⟩ ideal: 0.9999999999999996
# This took 27 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 1,  # TREX
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observable_t)])

    res = job.result()
    val = res[0].data.evs

print("⟨ZX⟩ with TREX:", val)
⟨Z₀⟩ with TREX: 0.9520029143897996
الآن نضبط resilience_level على 0 للتشغيل بدون TREX.
# This took 12 sec on ibm_fez. Your runtime might differ.
with Session(backend=backend) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 0,  # TREX off
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observable_t)])

    res = job.result()
    val = res[0].data.evs

print("⟨ZX⟩ without TREX:", val)
⟨Z₀⟩ without TREX: 0.8651
قيمة التوقّع أقرب بكثير إلى القيمة المثالية (1) مع TREX، كما هو متوقع. طبعًا كانت هذه قيمة توقّع واحدة على كيوبت واحد. الآن نجهّز دارة تستخدم بوابات غير كليفورد (non-Clifford) وكيوبتات كثيرة لنختبر هل يبقى تحسّن TREX متينًا في وضع مختلف.
import numpy as np

num_qubits = 20
qc = QuantumCircuit(num_qubits)
for i in range(num_qubits):
    qc.rx(np.pi * 7 / 8, i)
qc.barrier()
CircuitInstruction(operation=Instruction(name='barrier', num_qubits=20, num_clbits=0, params=[]), qubits=(<Qubit register=(20, "q"), index=0>, <Qubit register=(20, "q"), index=1>, <Qubit register=(20, "q"), index=2>, <Qubit register=(20, "q"), index=3>, <Qubit register=(20, "q"), index=4>, <Qubit register=(20, "q"), index=5>, <Qubit register=(20, "q"), index=6>, <Qubit register=(20, "q"), index=7>, <Qubit register=(20, "q"), index=8>, <Qubit register=(20, "q"), index=9>, <Qubit register=(20, "q"), index=10>, <Qubit register=(20, "q"), index=11>, <Qubit register=(20, "q"), index=12>, <Qubit register=(20, "q"), index=13>, <Qubit register=(20, "q"), index=14>, <Qubit register=(20, "q"), index=15>, <Qubit register=(20, "q"), index=16>, <Qubit register=(20, "q"), index=17>, <Qubit register=(20, "q"), index=18>, <Qubit register=(20, "q"), index=19>), clbits=())
هنا لا يوجد شيء مميز في زاوية الدوران . اخترنا ببساطة أي تراكب غير متساوٍ بين و لنفحص تأثيرات الانتقالات الخاطئة غير المتماثلة وكيف يعالجها TREX. بالنسبة لهذه الحالة، ستكون قيمة التوقّع المثالية لـ Z على كل كيوبت، في غياب أي أخطاء (قراءة أو غيرها):
لذلك نأمل أن نحصل على قيم توقّع قريبة من -0.924 على كل الكيوبتات. سنرى هل يحسّن TREX كل قيمة توقّع على حدة، وهل يحسّن المتوسط على كل الكيوبتات.
تحقق من فهمك
تحقق من قيمة التوقّع أعلاه عن طريق الحساب المباشر.
الإجابة
نترجم باستخدام مدير تمريرات.
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

pass_manager = generate_preset_pass_manager(optimization_level=1, backend=backend_real)

qc_t = pass_manager.run(qc)
الآن نبني مرصودًا واحدًا لكل كيوبت حتى نتمكن من تقدير كل قيم التوقّع العشرين في سير عمل واحد. أي أننا نريد، للكيوبت رقم ، مرصودًا كل مواضعه عناصر محايدة ، ما عدا الموضع حيث نريد . تذكّر أن تطبّق التخطيط المترجم على مرصوداتك أيضًا.
# Observables: Z on qubit i for all i.
observables = []
for i in range(num_qubits):
    obs_string = "I" * i + "Z" + "I" * (num_qubits - i - 1)
    obs = SparsePauliOp(obs_string)
    observables.append(obs)
observables_t = [obs.apply_layout(qc_t.layout) for obs in observables]
الآن يمكننا التنفيذ. خلية الشيفرة أدناه تستخدم session mode؛ وإذا لم يكن لديك وصول إلى الجلسات (sessions)، يمكنك استبدالها بـ batch mode لتشغيل سير العمل نفسه لكن مع احتمال وجود أوقات انتظار في الطابور بين الدارات.
# This took 20 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend_real) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 0,  # TREX turned off
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observables_t)])

    res_no_trex = job.result()
    val_no_trex = res_no_trex[0].data.evs

print("⟨Z_i⟩ without TREX:", val_no_trex)
⟨Z_i⟩ without TREX: [-0.90645 -0.89755 -0.89125 -0.9165  -0.87655 -0.91035 -0.8757  -0.87905
 -0.66035 -0.8876  -0.87125 -0.89975 -0.83745 -0.89755 -0.82645 -0.90325
 -0.84385 -0.90195 -0.85865 -0.8884 ]
# This took 36 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend_real) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 1,  # TREX
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observables_t)])

    res_trex = job.result()
    val_trex = res_trex[0].data.evs

print("⟨Z_i⟩ with TREX:", val_trex)
⟨Z_i⟩ with TREX: [-0.92086303 -0.90253698 -0.91688854 -0.93308327 -0.91273953 -0.9221892
 -0.903782   -0.93046052 -0.90348934 -0.90284174 -0.89499677 -0.91630959
 -0.89508481 -0.92233292 -0.90497141 -0.91867138 -0.91421506 -0.91646851
 -0.9268364  -0.91669818]
هنا نقارن متوسط الأخطاء المطلقة مع TREX وبدونه.
ideal = np.cos(7 * np.pi / 8)

mean_abs_error_no_trex = np.mean(np.abs(val_no_trex - ideal))
mean_abs_error_trex = np.mean(np.abs(val_trex - ideal))

print("The mean absolute error without TREX is: ", mean_abs_error_no_trex)
print("The mean absolute error with TREX is: ", mean_abs_error_trex)
The mean absolute error without TREX is:  0.05238453251128674
The mean absolute error with TREX is:  0.011980732757900719
zx = list(range(num_qubits))
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values with no DD
ax.scatter(zx, val_no_trex, c="blue", linestyle="-", label="No TREX", alpha=0.7)

## Add values with DD
ax.scatter(zx, val_trex, c="red", linestyle="-", label="With TREX", alpha=0.7)

# Add ideal reference line
ax.axhline(y=-0.924, color="black", linestyle="--", linewidth=2, label="Ideal ⟨Z⟩")

# Add labels and plot
ax.set_xlabel("Qubits")
ax.set_ylabel("<Z>")
ax.legend()
ax.set_title("<Z> in RX(7pi/8)|0> state with and without TREX")
ax.grid(True)

plt.show()
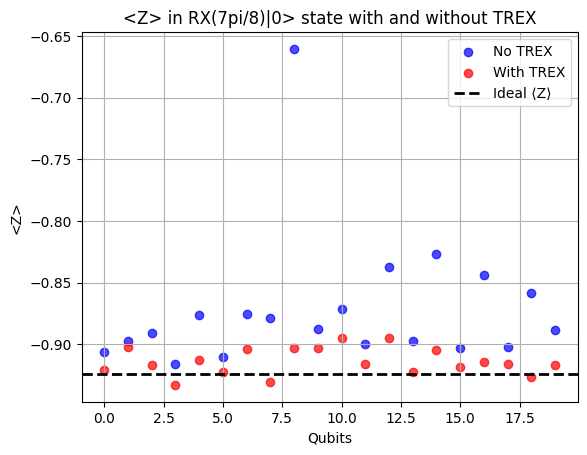
يبدو بالتأكيد أن TREX ساعد. فقد تحسّنت قيمة التوقّع على كل كيوبت، باستثناء وحيد هو الكيوبت 16. ومن المتوقع وجود قيمة شاذة كهذه. يمكننا قياس أثر TREX الكلي على الدارة بأخذ القيم المتوسطة.
mean_no_trex = sum(val_no_trex) / num_qubits
mean_trex = sum(val_trex) / num_qubits

print("Mean without TREX", mean_no_trex)
print("Mean with TREX", mean_trex)
Mean without TREX -0.8714950000000001
Mean with TREX -0.9137729590315635
في المتوسط، قرّب TREX نتائجنا بنحو 2.9% من النتائج المثالية، وترك لنا نتيجة تختلف في المتوسط عن القيمة النظرية المثالية بنسبة 0.4% فقط. هذا ممتاز، وهذا التحسين منخفض الكلفة هو بالضبط سبب كون TREX تخفيف الأخطاء الافتراضي في Estimator. لكن يجب أن نؤكد مرة أخرى أن TREX يزيل انحيازًا في خطأ القراءة، ولا يصحح كل أخطائنا. لقد اخترنا حالة ابتدائية كانت لديها فرصة جيدة لأن تتأثر بعدم التماثل في القراءة. كان الأثر سيختلف لو جهّزنا كل كيوبت في حالة مختلفة. وللدلالة البسيطة على أن هذا لا بد أن يكون صحيحًا، تخيّل ما سيحدث لو تركنا كل كيوبت في الحالة الأرضية . لن تكون هناك فرصة لملاحظة (أو تصحيح) عدم التماثل في خطأ القراءة بين الحالتين و .
الاستقراء إلى ضوضاء صفرية (ZNE)
الاستقراء إلى ضوضاء صفرية (ZNE) من أكثر تقنيات تخفيف الأخطاء استخدامًا. الاستراتيجية العامة سهلة الفهم أيضًا، رغم أن تفاصيل تنفيذها معقدة. يعمل ZNE على النحو التالي:
-
تشغيل دارة مستهدفة عند عدة "مستويات ضوضاء" — أي تعديلات على الدارة تجعل ضوضاءها تتدرج بطرق يمكن التنبؤ بها
-
تقدير المرصود المطلوب عند كل مقياس ضوضاء.
-
الاستقراء رجوعًا إلى ضوضاء صفرية باستخدام نموذج ملاءمة (خطي، متعدد الحدود، أسي، وهكذا).
النتيجة هي تقدير لما كان سيكون عليه المرصود في حد الضوضاء الصفرية الذي يقتضيه نموذج الاستقراء.
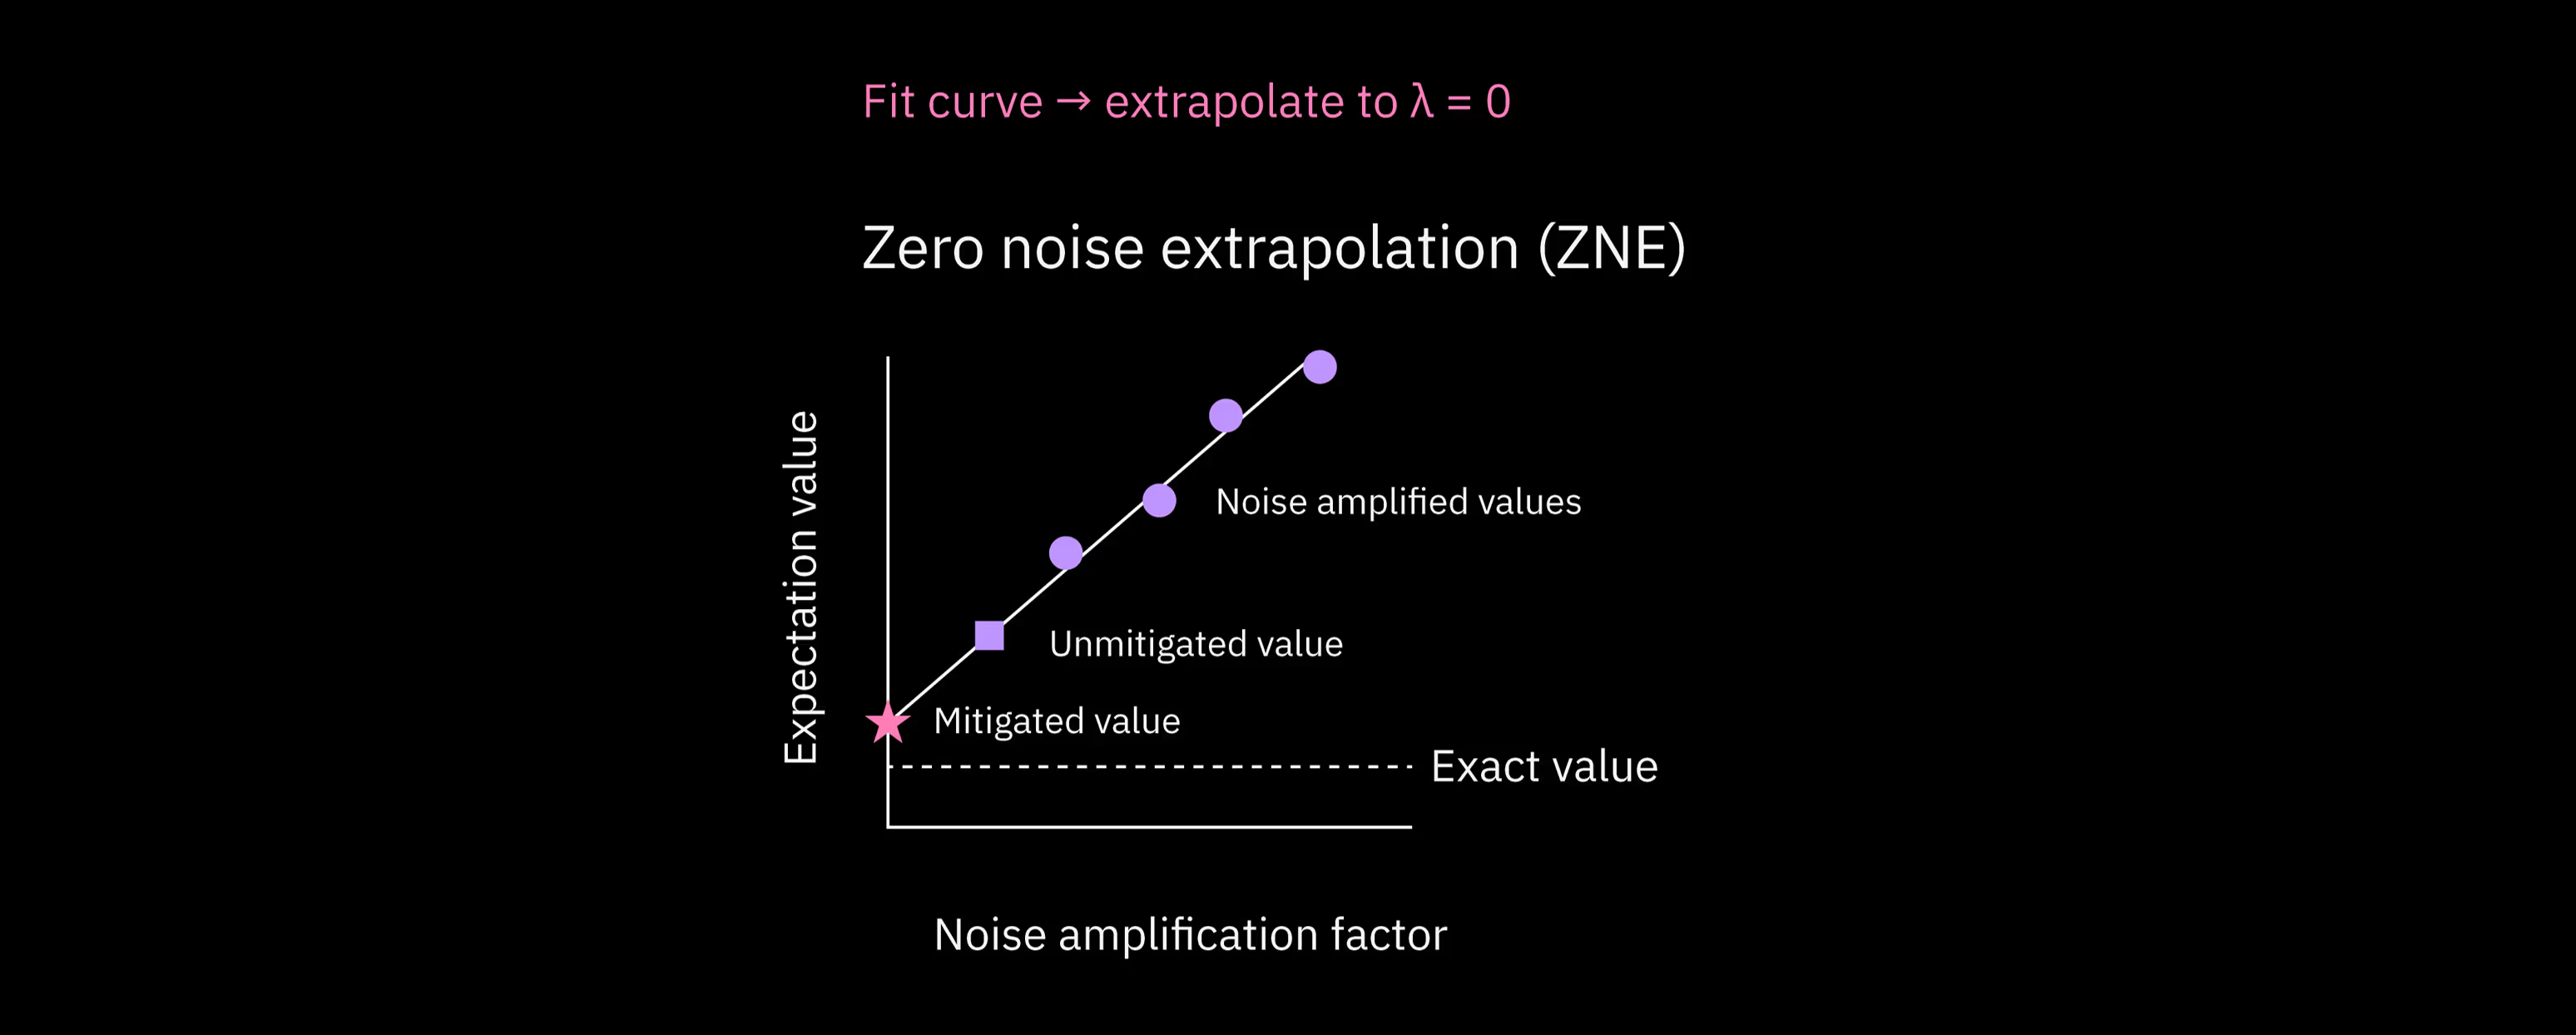
لا يضمن ZNE أن تزداد الضوضاء بسلاسة أو خطيًا عندما نعدّل الدارات. بل يفترض أن تدرّج الضوضاء منتظم بما يكفي للسماح بالاستقراء. يكمن التعقيد في ZNE في كيفية تعديل الدارات لتحقيق هذا الافتراض على أفضل وجه. سنفحص بعض الأساليب في هذا الدرس.
تدرّج موارد ZNE
في ZNE، الكلفة الإضافية هي في معظمها كلفة كمّية. أي أنه للحصول على قيم توقّع عند من مستويات الضوضاء، عليك تنفيذ تجربتك على من الدارات، لكل منها لقطات (shots) كثيرة. وللحفاظ على دقة إحصائية ثابتة، يزداد العدد الكلي للعينات عمومًا كلما أُضيفت دارات إضافية بتدرّج ضوضاء.
سيعتمد عدد مستويات الضوضاء التي تفحصها، ، على الطريقة المستخدمة لتدريج الضوضاء. في تقنية تدريج بسيطة (تسمى "طي البوابات" gate-folding، وسنناقشها أدناه)، يتراوح عادةً بين 3 و5. وتسمح طريقة مختلفة (تضخيم الضوضاء الاحتمالي (PNA)) بعوامل ضوضاء غير صحيحة، وتؤدي عادةً إلى مستويات ضوضاء أقل من طي البوابات. تتدرج الكلفة الإضافية الكلية تقريبًا على النحو التالي:
حيث هو عدد اللقطات الأساسي. أمر آخر يجب أخذه في الحسبان هو أنه إذا تضمّن تدريج الضوضاء بوابات مكررة، فقد يزداد عمق الدارة بعامل يتناسب مع قيمة تدريج الضوضاء. تدرّج الضوضاء المصاحب لزيادة العمق هو المقصود، لكن ضع العمق الكلي في اعتبارك.
يناسب ZNE المسائل التي تنطبق عليها النقاط التالية:
-
تحتاج إلى طريقة تخفيف عامة الغرض فعّالة على أنواع كثيرة من الأخطاء.
-
عمق الدارة ليس كبيرًا جدًا؛ يفشل ZNE عندما تصبح الدارة المُدرَّجة شديدة الضوضاء بحيث لا يمكن الاستقراء.
-
يمكنك تحمّل كلفة معتدلة في زمن التشغيل مقابل دقة أفضل.
عمليًا يجعل هذا ZNE مثاليًا للعديد من الدارات التبايُنية (variational)، وتقدير قيم التوقّع، وغيرها من الخوارزميات الكمّية القريبة المدى. وهو مُنفَّذ في Estimator باستخدام resilience_level = 2. لاحظ أن ZNE يستكمل خارجيًا في فضاء له نتيجة واحدة كدالة للضوضاء عبر الدارة. وهذا يعني أنه مناسب لمسائل التقدير، لكن ليس لمسائل أخذ العينات. فهو غير مصمم للعمل على توزيعات سلاسل البتات.
عوامل الضوضاء
كيف يمكننا بالضبط زيادة مستوى الضوضاء في دارة؟ هناك طريقتان رئيسيتان، رغم وجود أشكال كثيرة منهما.
-
استبدال بوابة أو كتلة بوابات بـ . ولأن البوابات في الحواسيب الكمّية وحدوية، نعلم أن بحيث منطقيًا: . لكن كل تكرار لـ أو يضيف خطأً مشابهًا أو مطابقًا، مما يتيح لنا رفع مستويات الضوضاء/الخطأ. لاحظ أن الاستبدال الموضح أعلاه ينقلنا من الضوضاء الأصلية للبوابة (مستوى الضوضاء 1) إلى ثلاثة أضعاف مستوى الضوضاء هذا في (مستوى الضوضاء 3). عمليًا يمكننا تكرار البوابتين الأخيرتين مرة: للحصول على مستوى ضوضاء . يسمى هذا طي البوابات (gate folding)، وهو تقنية شائعة جدًا لتدريج الضوضاء.
-
توجد طرق أخرى لزيادة مستوى الضوضاء، مثل تضخيم الخطأ الاحتمالي (PEA). في PEA نتعلم أولًا نموذج ضوضاء مناسبًا للدارة، يُعبَّر عنه عادةً بقناة باولي. ثم تُضخَّم الضوضاء بأخذ عينات من نسخة معاد تدريجها من قناة الضوضاء المتعلَّمة هذه. وبضبط أخذ العينات يمكنك تدريج شدة الضوضاء الفعلية بشكل مستمر، بما في ذلك القيم غير الصحيحة.
عمليًا، يمكن لطي البوابات أن يدرّج الأخطاء بموثوقية عالية جدًا، لكنه قد يؤدي أيضًا إلى دارات عميقة جدًا. فإذا كنت تحتاج إلى ثلاثة مستويات ضوضاء فقط (1 و3 و5)، فهذا يعني زيادة عمق دارتك بعامل 5 مع الاستمرار في الحصول على نتائج معقولة. لذلك، إذا كان عمق دارتك المستهدفة بعد الترجمة، من حيث البوابات ثنائية الكيوبت، 60 أو أكثر، فمن المرجح أن يكون PEA أنسب من طي البوابات.
يمكن طي البوابات إما محليًا (أي أن تكرر لكل بوابة ثنائية الكيوبت فور ظهورها)، أو يمكن تجميعها في كتلة من البوابات وتكرار الكتلة (مثل البوابات ). غالبًا ما يكون الطي المحلي أفضل بالنسبة للافتراضات التي يقوم عليها ZNE، لكن كلا الخيارين ممكن.
تدخل فروق دقيقة كثيرة في المعالجة الإحصائية للنتائج المدرَّجة ضوضائيًا في ZNE. على سبيل المثال، عند خمسة أضعاف مستوى الضوضاء ستكون نتائجك حتمًا أعلى تباينًا وأقل موثوقية. فهل ينبغي معاملتها بنفس وزن نقاط البيانات الأقل ضوضاء؟ لا. ومع ذلك، ولأغراض رؤية ZNE في العمل، سنتجاهل بعضًا من هذا التعقيد في تجربة نموذج مبسّط، سنبني فيها دارات مطوية يدويًا، ونجري استكمالًا خارجيًا ساذجًا بأوزان متساوية لتوضيح الخطوات الأساسية. لكننا سنتبع ذلك بتجربة تستخدم وظيفة ZNE المدمجة في Qiskit، وسنرى أنها تعالج التعقيد الذي نتخطاه بشكل أفضل بكثير.
ZNE يدويًا
نبدأ باختيار دارة كمّية ومرصود يمكننا حساب القيمة المتوقعة المثالية له في غياب الضوضاء والأخطاء. نختار حالة GHZ هي ، بعدد زوجي من الكيوبتات. مرصودنا هو . نختار هذا لعدة أسباب:
- القيمة المتوقعة بسيطة الحساب في الحالة المثالية. ولأن عدد الكيوبتات زوجي، نحصل إما على
1من كل مضروبة معًا، أو على-1من كل مضروبة معًا عددًا زوجيًا من المرات. - ستكون حساسة إلى حد ما للأخطاء والضوضاء، لأن خطأً واحدًا على كيوبت واحد يمكن أن يقلب النتيجة الإجمالية لتلك اللقطة من +1 إلى -1.
- القيمة المتوقعة بعيدة عن 0. قد يواجه ZNE صعوبات عندما تكون القيمة المتوقعة المثالية قريبة جدًا من الصفر، لأن مستويات الضوضاء العالية تميل إلى جعل النتائج عشوائية، فتصبح موجبة بقدر ما هي سالبة. والنتيجة أن قيم الضوضاء العالية ستنتهي بإعطاء قيم قريبة من المثالية؛ وهذا قد يجعل الاستقراء صعبًا جدًا.
مع وضع هذا الدافع في الاعتبار، لنبنِ دارتنا.
from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit.transpiler import generate_preset_pass_manager

from qiskit_ibm_runtime import (
    QiskitRuntimeService,
    Estimator,
    EstimatorOptions,
)
num_qubits = 10  # must be even

# # Noise amplification factors used for folding (2* integer +1 for gate folding)
noise_steps = [1, 3, 5]
ghz_amp = []

for j in noise_steps:
    qc = QuantumCircuit(num_qubits)
    qc.h(0)
    # Since CX^2 = I, odd repetitions implement folded versions of the gate.
    for i in range(num_qubits - 1):
        for gates in range(j):
            qc.cx(i, i + 1)
    qc.barrier()
    ghz_amp.append(qc)
لاحظ الدقة هنا: . فرغم أنه قيل إن طي البوابات يتألف من مؤثرات بالصيغة ، فإن البنية نفسها تبدو هنا كـ CNOT CNOT CNOT.
لنتأكد من أن الدارة رقم لدينا هي فعلًا دارة GHZ العادية:
ghz_amp[0].draw("mpl")
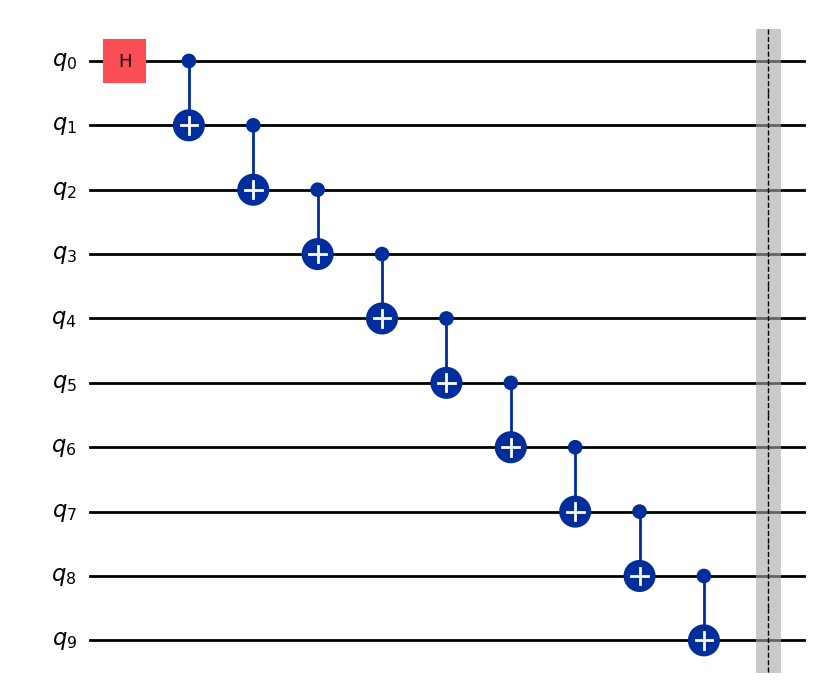
يمكنك النظر إلى الدارات الأخرى للتحقق من أن لها البنية المتوقعة.
الآن نبني مرصوداتنا.
pauli_string = "Z" * num_qubits
observable = SparsePauliOp(pauli_string)
observables = []
for j in range(len(noise_steps)):
    observables.append(observable)
نبني مدير تمريرات ونطبقه على دارتنا. ثم نأخذ التخطيطات ونطبقها على مرصوداتنا.
pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=0,
)

qcs_transpiled = []
obs_transpiled = []

for j in range(len(ghz_amp)):
    # Transpile the circuit
    qc_pm = pm.run(ghz_amp[j])
    qcs_transpiled.append(qc_pm)
    # Extract the final layout
    layout = qc_pm.layout
    # Apply the layout to the observable
    obs_transpiled.append(observable.apply_layout(layout))
نسّق الـ pubs.
pubs = [(qc, obs) for qc, obs in zip(qcs_transpiled, obs_transpiled)]
الآن نشغّل Estimator. نريد التركيز على دور ZNE، ولذلك قد نرغب في ضبط resilience_level = 0 لتجنب خلط تأثيرات الالتفاف العشوائي (twirling) بتأثير ZNE. لكننا نريد أيضًا مقارنة ZNE "اليدوي" بإعدادات ZNE المدمجة في Qiskit، والتي تتضمن الالتفاف العشوائي. لذلك نضبط هنا resilience_level = 1. أما ضبط resilience_level = 2 فيستدعي إعدادات ZNE في Qiskit، وسنستخدمها بعد قليل.
# This took 21 sec on ibm_fez. Your actual runtime might vary.
options = EstimatorOptions(resilience_level=1)

estimator = Estimator(
    mode=backend_real,
    options=options,
)

job = estimator.run(pubs)

res = job.result()
الآن نطبع مستويات الضوضاء وقيم التوقّع.
# We save this for later comparisons
value_no_zne = res[0].data.evs

# Print all values used for extrapolation
print("Noise level 1: ", res[0].data.evs)
print("Noise level 3: ", res[1].data.evs)
print("Noise level 5: ", res[2].data.evs)
Noise level 1:  0.8327970939283861
Noise level 3:  0.5612869745718734
Noise level 5:  0.3130254281266217
هذا هو الجزء الذي نتساهل فيه أكثر ما يمكن: نجري ملاءمة خطية لهذه البيانات دون أي اهتمام بتباين كل قيمة حصلنا عليها، ودون محاولة التنبؤ نظريًا بما إذا كان يجب أن تكون الملاءمة خطية. مرة أخرى، ZNE المدمج يؤدي عملًا أفضل بكثير مما نفعله يدويًا.
# Data
noise_factors = np.array([1, 3, 5])
values = np.array([res[0].data.evs, res[1].data.evs, res[2].data.evs])

# Linear fit: E(lambda) = m * lambda + b
coeffs = np.polyfit(noise_factors, values, deg=1)
slope, intercept = coeffs

print(f"Best-fit slope: {slope}")
print(f"Zero-noise extrapolated value: {intercept}")
Best-fit slope: -0.12994291645044112
Zero-noise extrapolated value: 0.9588652482269501
نمضي ونرسم هذا قبل التفسير.
import matplotlib.pyplot as plt

x_fit = np.linspace(0, 5.5, 100)
y_fit = slope * x_fit + intercept
y_ideal = 1.0

plt.figure()
plt.plot(noise_factors, values, "o", label="Measured data")
plt.plot(x_fit, y_fit, "-", label="Linear fit")
plt.axhline(y_ideal, linestyle="--", label="Ideal")
plt.axvline(0, linestyle="--", color="gray")
plt.scatter(0, intercept, color="red", zorder=3, label="Zero-noise estimate")

plt.xlabel("Noise amplification factor")
plt.ylabel(r"$\langle Z^{\otimes N} \rangle$")
plt.legend()
plt.show()
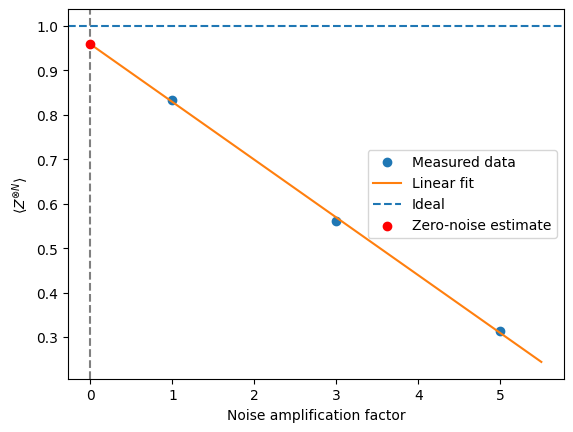
وقت إعداد هذا الدرس، حصلنا من الاستقراء إلى حالة الضوضاء الصفرية على قيمة متوقعة 0.959. قد تختلف قيمك. وهذا أفضل بكثير من القيمة المتوقعة للدارة الخام وهي 0.83، أي أقرب بنحو 13% إلى القيمة المثالية. لكن يمكنك أيضًا أن ترى أننا نستخدم نقطة بيانات انخفضت فيها القيمة المتوقعة إلى 0.31. من الواضح أن جودة نقطة البيانات هذه أقل. فلو أُعطيت هذه النقطة وزنًا أقل في تقريبنا الخطي، وكان الخط مُلاءمًا أكثر لأول نقطتين، لرأينا أن التقدير المستقرأ إلى الصفر كان سيكون أعلى (أقرب إلى القيمة المثالية). هذا النوع من الاعتبارات يُعالَج تلقائيًا في ZNE المدمج في Estimator.
ZNE المدمج في Estimator
لنرَ الآن ما يحدث عندما نستخدم وظيفة ZNE المدمجة في Estimator. نبدأ بتعريف دارة GHZ بسيطة، دون أي طي للبوابات.
num_qubits = 10  # must be even

qc = QuantumCircuit(num_qubits)
qc.h(0)

for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

qc.barrier()
CircuitInstruction(operation=Instruction(name='barrier', num_qubits=10, num_clbits=0, params=[]), qubits=(<Qubit register=(10, "q"), index=0>, <Qubit register=(10, "q"), index=1>, <Qubit register=(10, "q"), index=2>, <Qubit register=(10, "q"), index=3>, <Qubit register=(10, "q"), index=4>, <Qubit register=(10, "q"), index=5>, <Qubit register=(10, "q"), index=6>, <Qubit register=(10, "q"), index=7>, <Qubit register=(10, "q"), index=8>, <Qubit register=(10, "q"), index=9>), clbits=())
نعرّف المرصود نفسه كما سبق.
pauli_string = "Z" * num_qubits
observable = SparsePauliOp(pauli_string)
نعرّف مرة أخرى مدير تمريرات، باستخدام optimization_level = 1. سنعود إلى هذا الاختيار أدناه.
pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)
ترجِم الدارة وطبّق التخطيط على المرصودات.
# Transpile the circuit
qc_transpiled = pm.run(qc)

# Extract the final layout
layout = qc_transpiled.layout

# Apply the layout to the observable
obs_transpiled = observable.apply_layout(layout)
نشغّل Estimator باستخدام ZNE والتدوير، ونقارن النتائج مع تنفيذنا اليدوي لـ ZNE. وعلى وجه الخصوص نقارنها بالنتيجة بدون ZNE (value_no_zne).
# This used 18 sec on ibm_fez. Your actual QPU time might vary.

options_zne = {
    "resilience_level": 2,
    "resilience": {
        "zne": {
            "noise_factors": [1, 3, 5],
        }
    },
    "twirling": {
        "enable_gates": True,
        "enable_measure": True,
        "num_randomizations": "auto",
    },
}

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
يمكننا استرجاع القيم عند كل عامل ضوضاء باستخدام الصيغة job_zne.result()[0].data.evs_noise_factors. وكما سبق، يمكننا بسذاجة استخدام هذه النتائج للحصول على ملاءمة خطية والاستقراء إلى حالة الضوضاء الصفرية، لكن estimator مع resilience_level = 2 أدّى عملًا أفضل بالفعل، آخذًا في الحسبان التباين واعتبارات أخرى. نعرض أدناه ما كان سينتج عن استقراء خطي، وما أنتجه ZNE المدمج فعليًا.
# Data
noise_factors = np.array([1, 3, 5])
values_qiskit_zne = np.array(job_zne.result()[0].data.evs_noise_factors)

# Linear fit: E(lambda) = m * lambda + b
coeffs = np.polyfit(noise_factors, values_qiskit_zne, deg=1)
slope, intercept = coeffs

print(f"Best-fit slope: {slope}")
print(f"Zero-noise extrapolated value: {intercept}")
Best-fit slope: -0.11745451044574956
Zero-noise extrapolated value: 0.9045922788100509
print("Exp val ideal: 1.0")
print("Exp val with no ZNE: ", value_no_zne)
print("Exp val with ZNE: ", value_zne)
print("Fractional improvement: ", (value_zne - value_no_zne) * 100 / 1.0, "%")
Exp val ideal: 1.0
Exp val with no ZNE:  0.8327970939283861
Exp val with ZNE:  0.9877508802932561
Fractional improvement:  15.495378636487 %
import matplotlib.pyplot as plt

x_fit = np.linspace(0, 5.5, 100)
y_fit = slope * x_fit + intercept
y_ideal = 1.0

plt.figure()
plt.plot(noise_factors, values, "o", label="Measured data")
plt.plot(x_fit, y_fit, "-", label="Linear fit")
plt.axhline(y_ideal, linestyle="--", label="Ideal")
plt.axvline(0, linestyle="--", color="gray")
plt.scatter(0, intercept, color="red", zorder=3, label="Linear")
plt.scatter(0, value_zne, color="black", zorder=3, label="Proper ZNE")

plt.xlabel("Noise amplification factor")
plt.ylabel(r"$\langle Z^{\otimes N} \rangle$")
plt.legend()
plt.show()
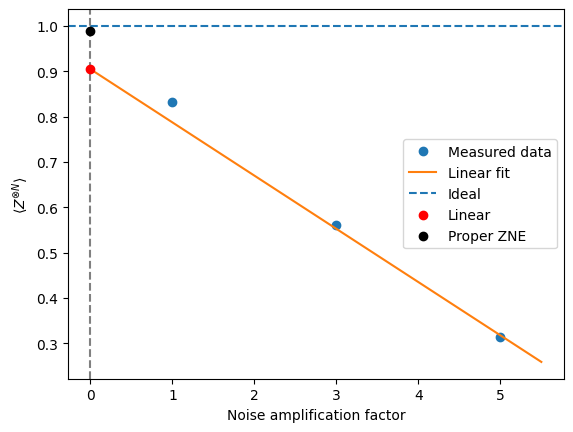
نرى أن ZNE المدمج حسّن تقديرنا بأكثر من 15%، وعمل أفضل بكثير من محاولتنا اليدوية.
قبل المتابعة، لاحظ أننا ضبطنا optimization_level = 1 في مدير التمريرات طوال استكشاف ZNE هذا. مستويات التحسين الأعلى تقلل الخطأ، وأحيانًا قد يجعل تقليل الخطأ الأخطاء تتدرج بشكل أقل قابلية للتنبؤ. وكما هو الحال غالبًا، هناك توازن: قلّل الأخطاء، إلا عندما تزيدها عمدًا بعامل معروف.
دمج الطرق
يعتمد ZNE على ما يلي:
-
معامل تدريج ضوضاء محدد جيدًا
-
تدرّج سلس ويمكن التنبؤ به بما يكفي لقيم التوقّع مع
-
قناة الضوضاء الفعلية نفسها، بشدّات مختلفة
-
عدم إدخال انحياز لا يتدرج مع
يندمج ZNE بسلاسة مع التقنيات التي تزيل الانحيازات غير المتدرجة (مثل M3) أو تجعل الضوضاء أكثر انتظامًا (مثل الالتفاف العشوائي)، لكنه يتعارض مع التقنيات التي تحاول إلغاء الضوضاء بالكامل (PEC) أو إعادة تشكيلها ديناميكيًا (DD).
على وجه الخصوص، يعالج M3 فقط أخطاء القياس/القراءة، التي يمكن عمليًا التعامل معها بمعزل عن أخطاء البوابات (التي هي محور عمليات تدريج الخطأ في ZNE). M3 مستقل إلى حد كبير عن طي البوابات؛ ويمكن دمجه مع ZNE بسلاسة. TREX مشابه جدًا، ويمكن دمجه مع ZNE.
الالتفاف العشوائي لباولي (Pauli twirling) يركّز على البوابات، على عكس M3 وTREX. لكن تذكّر أن الالتفاف العشوائي لباولي لا يخفف الخطأ/الضوضاء مباشرة؛ بل يغيّرها لتصبح أكثر قابلية للتنبؤ. وقد يكون الالتفاف العشوائي لباولي مفيدًا فعلًا لعملية ZNE لأنه يجعل أخطاء البوابات تتدرج بشكل أقرب إلى الخطي، وبذلك يصبح الاستقراء أدق.
الفصل الديناميكي (DD) أكثر دقة. يغيّر DD سلوك الضوضاء ديناميكيًا عن طريق إلغاء أخطاء معينة جزئيًا بإضافة متواليات من البوابات. فإذا أمكن بناء الدارات بحيث يتصرف DD بالطريقة نفسها حتى عند طي البوابات أو الكتل، فمن حيث المبدأ يمكن الجمع بين ZNE وDD، لكن عمليًا يتداخل DD أحيانًا مع التدريج. إذا أردت الجمع بينهما، فمن الأمور التي ينبغي النظر فيها ما يلي:
- هل يُطبَّق DD بشكل متسق عند جميع مستويات الضوضاء؟
- هل يحافظ الطي على بنية DD؟
- هل لا يزال تدرّج الضوضاء الناتج رتيبًا؟
آخر طريقة لتخفيف الأخطاء سنناقشها كنهج مستقل غير متوافقة مع ZNE: إلغاء الخطأ الاحتمالي.
إلغاء الخطأ الاحتمالي (PEC)
على عكس ZNE أو تخفيف أخطاء القياس، يحاول PEC إلغاء الضوضاء على مستوى البوابات عن طريق إعادة بناء القناة المثالية في التوقّع. إلغاء الخطأ الاحتمالي (PEC) هو أقوى تقنيات تخفيف الأخطاء وأكثرها كلفة في هذا الدرس. يقوم PEC على عكس صريح لقناة الضوضاء، يُنفَّذ إحصائيًا لا فيزيائيًا. يعمل PEC على النحو التالي:
-
توصيف نموذج الضوضاء بدلالة أساس من "عمليات الخطأ".
-
التعبير عن معكوس قناة الضوضاء كتوزيع شبه احتمالي (quasi-probability) على عمليات فيزيائية.
-
أخذ عينات من هذا التوزيع أثناء تنفيذ الدارة لبناء تقدير غير منحاز للحساب المثالي إحصائيًا.
من الناحية المفاهيمية، PEC يشبه تصحيح الأخطاء الافتراضي — فهو "يتراجع" عن الضوضاء بدمج عمليات ضوضائية وفق أنماط عشوائية موزونة بعناية. أما إجرائيًا، فإن PEC لا يرتبط ارتباطًا وثيقًا بتصحيح الأخطاء أو شيفرات كشفها. يأتي تقدير PEC غير المنحاز لقيمة التوقّع المثالية الخالية من الضوضاء على حساب كلفة أخذ عينات كبيرة جدًا واعتماد شديد على دقة توصيف الضوضاء.
على حواسيب IBM الكمّية، يُنظر إلى PEC على أفضل وجه كأداة دقيقة لا كطبقة تخفيف عامة الغرض: فهو الأنسب للدارات الصغيرة أو الأجزاء الصغيرة من دارات أكبر، ومهام قياس الأداء، والدراسات عالية الدقة التي تكون فيها الكلفة الكمّية العالية مقبولة.
توصيف قناة الضوضاء
في PEC، تُنمذَج كل بوابة مثالية في دارة كمّية على أنها قناة وحدوية مثالية تليها عملية ضوضاء. ليكن مصفوفة الكثافة للحالة الكمّية. تُمثَّل البوابة المثالية بمصفوفة وحدوية ، تولّد قناة كمّية:
على العتاد الحقيقي، يتلف هذا التطور المثالي بسبب الضوضاء. نُنمذج التنفيذ الفيزيائي للبوابة على أنه قناة ضوضائية فعلية:
حيث قناة ضوضاء تلتقط الأخطاء العشوائية المرتبطة بالبوابة. في هذا النقاش كله، و و تطبيقات خطية تعمل على مؤثرات الكثافة. القناة المثالية وحدوية وعكوسة، بينما قناة الضوضاء (وبالتالي ) هي تطبيق موجب تمامًا ومحافظ على الأثر (CPTP).
يفترض PEC أن قناة الضوضاء معروفة أو معروفة تقريبًا. على عتاد IBM Quantum، تُستمد هذه المعلومات عادةً من بيانات معايرة الجهاز، ومعدلات الأخطاء المستنتجة من تجارب قياس الأداء، ونماذج ضوضاء مبسطة مثل تقريبات باولي أو إزالة الاستقطاب لمجموعات صغيرة من البوابات. وبينما لا يتطلب PEC نموذج ضوضاء دقيقًا تمامًا، يتدهور أداؤه بسرعة كلما ابتعدت قناة الضوضاء المفترضة عن سلوك العتاد الحقيقي.
التحليل شبه الاحتمالي لقناة الضوضاء العكسية
الفكرة المحورية في PEC هي إلغاء أثر الضوضاء في التوقّع ببناء تقريب عشوائي لمعكوس قناة الضوضاء. رسميًا، الهدف هو تطبيق تطبيق خطي يتراجع تقريبًا عن ، بحيث:
في التوقّع على تنفيذات كثيرة للدارة.
يُعرَّف المعكوس هنا بأنه المعكوس الجبري لـ معاملًا كمؤثر فائق خطي يعمل على المؤثرات. يوجد هذا المعكوس فقط إذا كانت كاملة الرتبة؛ ولا يمكن تخفيف عمليات الضوضاء غير القابلة للعكس بدقة باستخدام PEC.
عندما يكون العكس ممكنًا، يعبّر PEC عن قناة الضوضاء العكسية على أنها تركيب خطي من عمليات قابلة للتنفيذ فيزيائيًا:
هنا، كل عملية ضوضائية يمكن تنفيذها على العتاد (عادةً بوابات أصلية أو متواليات قصيرة من البوابات)، وتشكّل المعاملات الحقيقية توزيعًا شبه احتمالي. وعلى عكس الاحتمالات العادية، قد تكون المعاملات سالبة أو تتجاوز 1.
تُحدّد النظيمة شبه الاحتمالية:
كلفة عكس الضوضاء. ولأي قناة ضوضاء غير بدهية، . على عتاد IBM Quantum، يُجرى هذا التحليل عادةً:
- لكل بوابة أو لكل مجموعة صغيرة من البوابات،
- بافتراض نماذج ضوضاء مقيدة (غالبًا تقريبات قطرية في أساس باولي)،
- باستخدام عمليات أصلية خاصة بالـ backend وقيود الجدولة.
إعادة بناء الدارة المثالية بطريقة مونتي كارلو
لتقدير قيمة التوقّع لمرصود ، يستخدم PEC أخذ عينات مونتي كارلو استنادًا إلى التحليل أعلاه. لكل ظهور لبوابة ضوضائية في الدارة، يُطبَّق الإجراء التالي:
-
اختر عشوائيًا عملية باحتمال:
-
عيّن وزنًا كلاسيكيًا:
-
نفّذ الدارة الضوضائية العشوائية الناتجة على الـ backend الكمّي.
-
اضرب النتيجة المقاسة في حاصل ضرب كل الأوزان المتراكمة.
-
احسب متوسط النتائج الموزونة على تنفيذات كثيرة للدارة.
المقدِّر الناتج يحقق
بشرط أن يصف نموذج الضوضاء العتاد بدقة. لذلك لا يُدخل PEC أي انحياز منهجي في التوقّع، لكنه يستبدل الانحياز بـ تباين إحصائي كبير. ينتج كل تشغيل تقديرًا ضوضائيًا لكنه موزون؛ ولا تظهر قيمة التوقّع المثالية إلا بعد حساب متوسط عدد كبير من هذه التشغيلات.
تفسير مفاهيمي
يوصَف PEC أحيانًا بأنه تصحيح أخطاء افتراضي. ورغم أن هذه الصياغة ليست خاطئة تمامًا، فلا ينبغي الخلط بينه وبين تصحيح الأخطاء الكمّي الحقيقي. لا يتضمن PEC ترميزًا منطقيًا، ولا استخلاص متلازمات (syndromes)، ولا تغذية راجعة في الزمن الحقيقي. ولا تُمنع الأخطاء أو تُصحَّح أثناء تنفيذ الدارة.
بدلًا من ذلك، يلغي PEC الضوضاء إحصائيًا، بدمج تحققات كثيرة للدارة الضوضائية مع أوزان كلاسيكية ذات إشارة بحيث تتلاشى الأخطاء فقط بعد المعالجة اللاحقة الكلاسيكية. المعلومات غير محمية أثناء التنفيذ؛ وتُعاد بناء النتائج المثالية بعد الحدث.
تدرّج الموارد والكلفة
تنشأ الكلفة الرئيسية لـ PEC من تضخيم التباين. يتدرج تباين مقدِّر PEC على النحو التالي:
مما يعني:
هذا التدرّج أساسي ولا يمكن تحسينه بالمعالجة اللاحقة الكلاسيكية.
في الدارات التي تحتوي على بوابات ضوضائية كثيرة، تسهم كل بوابة بعامل ، مما يجعل النظيمة شبه الاحتمالية الكلية تنمو تقريبًا بالضرب:
حيث هو عمق الدارة. على عتاد IBM Quantum، يؤدي هذا عادةً إلى نمو أسي في كلفة أخذ العينات مع عمق الدارة، مع حساسية قوية بوجه خاص لأخطاء البوابات ثنائية الكيوبت. يضع هذا التدرّج حدودًا عملية على إمكانية تطبيق PEC.
PEC عملي حاليًا فقط عندما يتحقق شرط أو أكثر من الشروط التالية:
-
الدارات صغيرة جدًا أو ضحلة (غالبًا بوابة)،
-
نماذج الضوضاء بسيطة ومُتحقَّق منها جيدًا (مثل ضوضاء باولي)،
-
الكلفة الإحصائية العالية مقبولة،
-
الهدف هو الدقة لا الإنتاجية.
لهذا السبب، يُطبَّق PEC غالبًا على:
-
دارات فرعية معزولة ضمن سير عمل أكبر،
-
خطوات التطور القصيرة الزمن،
-
إجراءات تحضير الحالة أو القياس،
-
تجارب قياس الأداء والتحقق.
تعكس حزمة برمجيات IBM (IBM Quantum Compute وأدوات تخفيف الأخطاء) ذلك بمعاملة PEC كخيار متخصص، لا كطبقة تخفيف افتراضية.
تشمل حالات استخدام PEC النموذجية:
-
قياس أداء العتاد الكمي بدقة،
-
التحقق من الخوارزميات الكمية الصغيرة،
-
كيمياء كمية عالية الدقة على أنظمة مختزلة،
-
التحقق المتبادل من ZNE أو غيرها من طرق التخفيف.
علاقة PEC بطرق التخفيف الأخرى
كثير من تقنيات التخفيف الأخرى تضحّي بالدقة مقابل قابلية التوسع؛ أما PEC فتفعل العكس تمامًا، إذ تركّز على الدقة قبل كل شيء.
بما أن PEC قد تُستخدم على دائرة فرعية فقط، فمن المهم هنا بشكل خاص أن نسأل: ما طرق التخفيف الأخرى التي يمكن دمجها معها؟ ولكي نفكّر بوضوح في التوافق مع PEC، من المفيد تصنيف التقنيات حسب ما تفعله بالضوضاء. لنأخذ هذه الفئات العامة:
-
إلغاء الضوضاء - محاولة عكس قنوات الخطأ
-
تحجيم الضوضاء - زيادة الضوضاء عمدًا من أجل الاستقراء
-
إعادة تشكيل الضوضاء - تغيير بنية الضوضاء أو طيفها
-
إزالة الانحياز - تصحيح الأخطاء التي لا تتناسب مع ضوضاء البوابات
تقع PEC بالكامل في الفئة (1). وأي طريقة تغيّر قناة الضوضاء أو تعيد تحجيمها يجب فحصها بعناية.
جدول ملخّص (نظرة عامة)
| التقنية | متوافقة مع PEC | ملاحظات |
|---|---|---|
| ZNE | لا | التراجع عن الخطأ مقابل تحجيمه، وأحيانًا تكييفه |
| Pauli twirling | نعم (بحذر) | تؤثر في سلوك الخطأ، لكنها قد تسهّل تعلّمه |
| TREX | نعم | لا تداخل في سير العمل. متوافقة تمامًا. |
| Dynamical decoupling | غالبًا لا | تغيّر قناة الخطأ |
تتعامل PEC وZNE مع مصادر الخطأ نفسها (أخطاء البوابات) عبر افتراضات أو مسارات عمل غير متوافقة، أو كليهما. فمثلًا، في ZNE نفترض أنه يمكن نشر الخطأ بدلالة معامل :
وأنه يمكن تحجيم الخطأ فعليًا لمحاكاة هذا النشر. أما PEC فستلغي الخطأ ذاته الذي نعتمد عليه في التحجيم، فيفقد المعامل معناه. وهناك طريقة أخرى للتفكير في الأمر:
-
تطبيق ZNE قبل PEC يغيّر قناة الضوضاء التي تحاول عكسها.
-
تطبيق PEC قبل ZNE يزيل الضوضاء ذاتها التي تعتمد عليها ZNE في الاستقراء.
ينبغي اعتبار PEC وZNE نموذجين بديلين لتخفيف الأخطاء، لا طبقتين يمكن تركيبهما معًا. مقارنتهما جنبًا إلى جنب مفيدة، أما دمجهما فلا.
PEC وPauli twirling متوافقتان عمومًا وغالبًا مفيدتان معًا. قد يساعد الـ twirling طريقة PEC لأنه يحوّل الأخطاء المتماسكة إلى أخطاء Pauli عشوائية. وهذا يبسّط قناة الضوضاء ويسهّل تمثيلها وعكسها. وهذا قيّم جدًا لـ PEC للأسباب التالية:
-
تفكيكات شبه الاحتمال أبسط بكثير لقنوات Pauli
-
معيار شبه الاحتمال يكون غالبًا أصغر بكثير
-
يقل تباين أخذ العيّنات
تفترض كثير من عروض PEC التوضيحية ضوضاء Pauli-twirled أو تبنيها ضمنًا. من المهم التوضيح أن Pauli twirling لا يخفف الأخطاء بحد ذاته؛ بل يعيد تشكيل الضوضاء إلى صيغة يمكن لإلغاء الأخطاء الاحتمالي التعامل معها بكفاءة أكبر.
يمكن، بل ينبغي، دمج PEC مع TREX. هاتان المقاربتان متوافقتان تمامًا وتؤديان أدوارًا متعامدة. تعمل TREX عند القياس فقط، وتزيل انحياز القراءة عبر twirls عشوائية لقناة القياس، ولا تؤثر في ضوضاء البوابات أو ديناميكيات الدائرة. أما PEC فتعمل على ضوضاء البوابات. ولأن خطأ القياس جمعي وليس تركيبيًا، فهو مستقل عن تسلسلات البوابات. ومن الآمن، وغالبًا من المستحب، تطبيق TREX إلى جانب PEC.
ترتيب هذه الطرق هو ما قد تتوقعه:
- نفّذ دائرة PEC العشوائية
- طبّق TREX لتخفيف خطأ القراءة
- طبّق أوزان PEC وأخذ المتوسط
PEC وDD غير متوافقتين عمومًا، إلا إذا أُجري توصيف الضوضاء المستخدم في PEC والـ DD مفعّلة. تفترض PEC أن ثابتة وقابلة للتكرار ويمكن توصيفها بدقة. أما DD فتعيد تشكيل قناة الضوضاء زمنيًا بتعديل التفاعلات بين النظام والبيئة وإدخال تأثيرات غير بسيطة في توقيت النبضات. ونتيجة لذلك، فإن الضوضاء الفعلية مع DD ليست القناة نفسها بدونها. ويزداد الأمر تعقيدًا لأن قناة الضوضاء قد تعتمد بشدة على جدولة الدائرة. والنتيجة النهائية أن عكس الضوضاء يصبح غير معرَّف أو غير صالح.
من الممكن نظريًا توصيف الضوضاء والـ DD مفعّلة وبناء نموذج PEC وفقًا لذلك، لكن هذا متقدم جدًا وليس سير عمل موصى به حاليًا.
تطبيق PEC يدويًا
PEC معقدة ولا يُنصح بتنفيذها يدويًا. ومع ذلك، نريد المرور على رياضيات تطبيق أساسي على كيوبت واحد لنفهم ما الخطوات التي تتضمنها العملية. نختار حالة مختلطة لكنها غير بديهية لنرى التأثيرات العددية بوضوح.
لنأخذ كيوبت يفترض أن يكون في الحالة النقية
مصفوفة الكثافة المثالية هي:
اخترنا مصفوفة الكثافة هذه لأنها غير قطرية وتخص كيوبت واحدًا فقط، ما يجعل فحصها "يدويًا" ممكنًا.
نطبّق الآن نموذج ضوضاء بسيطًا جدًا لكنه واقعي: قناة إزالة الاستقطاب (depolarizing) لكيوبت واحد، بقوة صغيرة .
لتبسيط الحسابات، لنأخذ . هذه القناة موجبة تمامًا وتحافظ على الأثر (CPTP)، كما يجب أن تكون. وهي قناة ضوضاء واقعية للعتاد الحقيقي، أو على الأقل واقعية في وصف جزء من الضوضاء. كما أن قناة الضوضاء هذه قابلة للعكس تحليليًا بوصفها تطبيقًا خطيًا. أي أن هناك مصفوفة عكسية، لكن هذا لا يعني أن المصفوفة تقابل قناة فيزيائية CPTP، وبالتأكيد لا تقابل عملية أحادية (unitary) يمكن تنفيذها على العتاد.
نطبّق الآن قناة إزالة الاستقطاب على مصفوفة الكثافة لكيوبتنا الواحد فنحصل على:
عند : و.
So:
بتطبيق ذلك على حالتنا:
نحسب صراحةً:
ما زالت هذه مصفوفة كثافة فيزيائية، وما زال أثرها يساوي واحدًا — لكنها أصبحت أكثر اختلاطًا.
نحسب الآن القناة العكسية المثالية، مع الاستعداد التام لاحتمال ألا تكون فيزيائية. سنتحقق مما إذا كانت كذلك. رياضيًا، التطبيق الخطي العكسي هو:
لو كان هذا الفعل العكسي قناة فيزيائية صالحة بحد ذاته، لأغرانا أن نحاول تنفيذه بدقة. وبالطبع سنظل بحاجة إلى معرفة كيفية تنفيذه باستخدام عمليات أحادية وخطوات كلاسيكية، لكن تنفيذه سيكون هو الهدف. غير أنه يتضح أنه ليس CPTP، وعمومًا لا يوجد ضمان بأن تكون مثل هذه التطبيقات العكسية CPTP. وهذا جوهري لنقاشنا الحالي، لأنه سبب وجود PEC.
قد تستطيع أن ترى أنه ليس CPTP بمجرد النظر إليه. والفحص المضمون هو تطبيقه على مصفوفة كثافة ومعرفة ما إذا كان يعيد نتائج فيزيائية. نترك هذا تمرينًا لتتحقق من فهمك.
تحقق من فهمك
تحقق مما إذا كان التطبيق العكسي أعلاه هو CPTP بتطبيقه على مصفوفة كثافة جديدة:
فسّر النتائج على أنها فيزيائية أو غير فيزيائية.
الإجابة
بوصفها مصفوفة كثافة فيزيائية، فهذا يقابل احتمالًا كلاسيكيًا أكبر من 1 بأن يكون النظام في الحالة واحتمالًا سالبًا بأن يكون في الحالة . من الواضح أن هذا التطبيق قد ينتج مصفوفات كثافة بلا معنى. وعلاوة على ذلك، يمكننا بالفحص أن نرى أن القيم الذاتية لمصفوفة الكثافة الناتجة هي 1.0625 و-0.0625، أي أن ليست كل القيم الذاتية موجبة. وبالتالي فالتطبيق ليس "موجبًا تمامًا" (completely positive)، أي الحرف "CP" في CPTP.
تحقق من فهمك
تحقق بحساب صريح من أن العملية العكسية أعلاه تلغي قناة الضوضاء وتعيد الحالة الخالية من الضوضاء.
الإجابة
طبّقها على الحالة المشوَّشة:
هذه هي الحالة الأصلية تمامًا (حتى التقريب).
نكرر للتوضيح التام: لا يمكننا عكس قناة الضوضاء بدقة؛ فالعكس ليس CPTP، وليس قناة فيزيائية صالحة. لكن يمكننا عكس القناة فعليًا بوصفها تركيبة خطية من قنوات فيزيائية.
بالنسبة لقناة إزالة الاستقطاب:
حيث: وهكذا.
يمكن كتابة العكس على الصورة:
with:
-
= قنوات Clifford قابلة للتنفيذ فيزيائيًا
-
= أشباه الاحتمالات
-
Some
هذه هي الفكرة الجوهرية وراء PEC:
-
خذ عيّنات من القنوات وفقًا لـ ∣
-
أرفق الإشارات بنتائج القياس
-
تتقارب القيم المتوقعة إلى القيمة الخالية من الضوضاء
نطبّق PEC "يدويًا" على تقدير باستخدام مصفوفة الكثافة ونرى هل يمكننا استعادة نتائج . بالنسبة لـ نتوقع:
لاحظ أيضًا أننا نحصل لمصفوفة الكثافة المشوَّشة على:
إنها في المرتبة الصحيحة من حيث الحجم لكنها بعيدة جدًا عن الحالة المثالية.
سنستعرض الآن كيف يمكننا، بعملية PEC، إعادة بناء القيمة المتوقعة غير المنحازة من مصفوفة الكثافة المشوَّشة. في سير العمل الحقيقي، يكون هذا احتماليًا ومؤتمتًا. وفي سير العمل "اليدوي" هذا سنختار قيمًا احتمالية واقعية، ولكنها ربما مناسبة لعرضنا. ولا ينبغي فهم ذلك على أنه ادعاء بأن PEC مثالية. إنه فقط لنريك سيناريو معقولًا قد يحدث داخل حزم PEC.
تذكّر أن قناة الضوضاء لدينا من الشكل:
ويمكن كتابة العكس (بدقة) على الصورة:
based on symmetry of the transformation and the completeness of the Pauli operators. Inverting the noise channel somehow in the estimation process should yield an estimator that is unbiased and normalized. To do this, we must at least determine the coefficents and and then think about how to implement the inverse transformation. When done by a noise learner, the inversion of this noise channel would be done at the channel level, independent of a specific case like our density matrix. The coefficients and would come from this inversion.
من الأبسط في هذه المقدمة أن نركّز على تأثير القناة في مصفوفة الكثافة لدينا. فهذا يتيح لنا العمل مع كائنات مألوفة مثل مصفوفات الكثافة والقيم المتوقعة. ولهذه الغاية، فكّر فيما يجب أن يصح بشأن تأثيرات هذه العملية العكسية على عملية التقدير لدينا: يجب أن يكون المقدِّر الناتج عن PEC معيَّرًا وغير منحاز. وهذا يقابل شرطين:
-
التسوية (Normalization): لضمان ألا تغيّر هذه العملية مقياس الكمية المرصودة، نشترط أن . ولفهم سبب ذلك، يمكننا إما النظر في تأثير العكس على مصفوفة كثافة، أو النظر في تأثيره على القيمة المتوقعة لشيء بسيط مثل نفسه.
-
الضبط (Calibration): في سير العمل الحقيقي، نستخدم دوائر الضبط لتعلّم سلوك الضوضاء على مستوى البوابات. ثم نستخدم المعرفة بسلوك الضوضاء على مستوى البوابات، وخطية القيم المتوقعة، لتطبيق نموذج الضوضاء المتعلَّم على الدائرة الأكبر. في حالتنا، بدأنا بمعرفة مصطنعة أن القيمة المتوقعة المثالية . لكن سيكون من السهل جدًا ابتكار حالة نعرف نظريًا أن هذه هي قيمتها المثالية، ثم استخدام قياسات فعلية للضبط. ونقطة أساسية هي أنه في PEC لا يتعلّم المرء عادةً نموذج ضوضاء كاملًا للدائرة بأكملها. بل يتعلّم نماذج ضوضاء محلية لبوابات منفردة أو طبقات دائرة ويستخدمها لبناء تفكيك شبه الاحتمال.
نستخدم هذه الشروط لتحديد و. ننظر في الصيغة التجريبية (ansatz)
and apply it to an arbitrary single-qubit density matrix .
تذكّر أن قنوات Pauli تعمل بالمرافقة (conjugation):
تطبيق على يعطي:
بأخذ الأثر نحصل على:
كل مؤثر Pauli أحادي (unitary)، بحيث تحافظ المرافقة على الأثر:
Therefore,
لكي يكون مقدِّر PEC معيَّرًا، يجب أن يحافظ التطبيق العكسي الفعلي على أثر جميع مصفوفات الكثافة. أي أننا نشترط:
وهذا يقتضي قيد المعايرة:
لكن في حالتنا، يعطي هذا الشرط:
نستخدم الآن معلومات الضبط لربط القيمة المتوقعة المرصودة بالقيمة المثالية المعروفة.
Or equivalently,
بحل شرطينا من أجل و نحصل على:
مجموع هذه المعاملات يساوي 1، لكن أحدها سالب.
يمكننا استعادة القيمة المتوقعة المثالية بتعديل الدائرة عشوائيًا، ثم القياس، وضرب النتيجة في وزن ذي إشارة، ثم أخذ المتوسط. وبالتحديد، لا تُعاد بناء أي مصفوفات كثافة ولا تُنفَّذ أي قناة عكسية فيزيائيًا.
الخطوة الأساسية: هذه هي PEC
لقوة الضوضاء لدينا ، يمكن كتابة القناة العكسية على الصورة:
حقائق مهمة:
-
مجموع المعاملات يساوي 1
-
أحد المعاملات سالب
-
كل حد قابل للتنفيذ فيزيائيًا
-
تنتقل السلبية إلى المعالجة اللاحقة الكلاسيكية
نكوّن توزيع أخذ العيّنات من القيم المطلقة للأوزان:
(لكل من X وY وZ)
الوزن الكلي:
للحصول على احتمالات أخذ العيّنات، اقسم على W.
| العملية | الاحتمال | الإشارة |
|---|---|---|
| لا تفعل شيئًا () | 1.1875 / 1.375 ≈ 0.864 | + |
| طبّق X | 0.0625 / 1.375 ≈ 0.045 | - |
| طبّق Y | 0.0625 / 1.375 ≈ 0.045 | - |
| طبّق Z | 0.0625 / 1.375 ≈ 0.045 | - |
تأتي الإشارة من المعامل الأصلي، لا من الاحتمال.
تتكون كل لقطة (shot) من هذه الخطوات:
-
حضّر الحالة
-
دع العتاد ينفّذ الدائرة المشوَّشة
-
اختر عملية عشوائيًا من الجدول أعلاه باستخدام الاحتمالات المرتبطة بها
-
Apply it
-
قِس لتحصل على
-
اضرب النتيجة في
-
سجّل ذلك الرقم
سنعرض الآن أمثلة لعدة لقطات.
اللقطة 1 (حالة المطابقة)
لنفترض أن العملية المختارة عشوائيًا هي المطابقة (أو بالتكافؤ: لا نفعل شيئًا). استنادًا إلى الحجج والجدول أعلاه، سيحدث هذا في 86.4% من الحالات. ولأن معامل في عكس قناة الضوضاء موجب، نختار الإشارة . قد يعطي قياسنا لـ Z بسهولة إما . لنفترض أنه أعطى .
ستكون مساهمة هذه اللقطة بعد تصحيح PEC:
اللقطة 2 (المطابقة مرة أخرى)
لنفترض أننا حصلنا مجددًا على كعملية عشوائية (فتبقى إشارة الحد في البداية)، لكن قياسنا لـ Z أعطى هذه المرة . تكون المساهمة هذه المرة:
اللقطة 3 (اختيار X)
هذه المرة العملية العشوائية هي X. هذا الحد في العكس سالب، لذا نحتفظ بإشارة . نطبّق X ثم نقيس Z. ومرة أخرى يمكن أن نحصل على أي من القيمتين الذاتيتين؛ لنقل إننا حصلنا على . تكون مساهمة هذا الحد:
اللقطة 4 (اختيار Z)
العملية العشوائية هي Z. وهذا يعطينا إشارة من الجدول. لنفترض أننا قسنا Z وحصلنا على . تكون المساهمة:
اللقطة 5 (اختيار Y)
العملية العشوائية هي Y. وهذا يعطينا إشارة من الجدول. لنفترض أننا قسنا Z وحصلنا على . تكون المساهمة:
أخذ متوسط النتائج
تخيّل أننا جمعنا عددًا كبيرًا من هذه النتائج الموزونة بـ PEC:
بحسب البناء، نطبّق المطابقة في 86.4% من الحالات. ونطبّق كل بوابة من البوابات الأخرى في 4.5% من الحالات. في سير العمل الحقيقي، لا نعرف الحالات الأساسية بدقة، ولا قناة الضوضاء بأكملها. لكننا نعرف عامل الوزن من أعلاه، والاحتمال النسبي الذي نطبّق به كل عملية. وفي سير العمل الحقيقي، نعتمد على مصفوفة الكثافة المجهولة لتعطينا نتائج القياس. سنتحقق هنا من أن هذا الإجراء سيعطي النتائج الصحيحة.
نريد حساب متوسط جميع القياسات الموزونة وذات الإشارة، بما في ذلك تطبيقات مؤثرات Pauli قبل القياس. لنسمِّ العدد الكلي لجميع اللقطات . ولنسمِّ مجموعة جميع اللقطات التي طُبّق فيها Pauli باسم ونستخدم لفهرسة هذه اللقطات. ولنسمِّ نتيجة قياس اللقطة ذات الرقم عند تطبيق Pauli ذي الرقم باسم . يمكننا كتابة هذا المتوسط على الصورة:
يُطبَّق مؤثر Pauli احتماليًا باحتمال . وفي حد عدد كبير من اللقطات،
يمكننا استخدام هذا لكتابة:
حيث هي القيمة المتوقعة لـ Z على مجموعة اللقطات التي طُبّق فيها فقط. وهذا مفيد لأننا نعرف من مصفوفة الكثافة ما يجب أن تكونه كل قيمة متوقعة من هذه. ومرة أخرى، في سير العمل الحقيقي ستنتج هذه من القياس، لا من مصفوفة كثافة معروفة.
تحقق من فهمك
تحقق من القيم المتوقعة أعلاه بالحساب أو بالاستدلال المنطقي.
الإجابة
يتم التعامل مع Y وZ بالطريقة نفسها تمامًا كما سبق.
يمكننا الآن إعادة كتابة القيمة المتوقعة الإجمالية على النحو التالي:
إذا عرفنا المعاملين و لضوضاء البوابة (أو معاملات أكثر لقنوات الضوضاء الأكثر تعقيدًا)، فهذا يكفي لتحديد (1) عامل الوزن الإجمالي، و(2) الاحتمالات التي يجب أن نطبّق بها مؤثرات باولي. ما تُظهره هذه النتيجة أعلاه هو أننا إذا فعلنا ذلك، فإننا نخفف الضوضاء ونستعيد قيمًا متوقعة غير متحيزة. تقاربَ متوسط كل هذه اللقطات إلى ، رغم أن:
-
اللقطات الفردية تعطي مساهمات أكبر من ±1
-
بعض اللقطات لها وزن إحصائي سالب
-
كل عملية كمية كانت فيزيائية
نظرة عامة على سير عمل PEC
في PEC، الخطوات كلها على الحاسوب الكمي هي:
-
تعلّم الضوضاء
-
تحضير الحالة للدائرة المستهدفة
-
تطبيق بوابات باولي بشكل احتمالي كما هو موضح أعلاه
-
Measurement
تتحقق خريطة الضوضاء العكسية الفعّالة إحصائيًا في المعالجة اللاحقة الكلاسيكية. وهذا يتيح عكسًا أعم لقنوات الضوضاء التي كانت ستتطلب لولا ذلك خطوات غير فيزيائية مثل الاحتمالات السالبة.
الثمن الذي ندفعه مقابل ذلك هو التباين. كانت كل لقطة سابقًا ذات "مقدار" يساوي مقادير نتائج القياس الممكنة . وبعد التحجيم بعامل الوزن ، يصبح مقدارها (أي 1.375 في مثالنا أعلاه).
هذا هو أصل الحمل الإضافي لأخذ العينات في PEC.
PEC المدمج
سنستخدم الآن PEC كما هو مدمج في primitives الخاصة بـ IBM Quantum. من المهم هنا التمييز بين PEC الكامل على مستوى البوابات ونموذج تعلّم ضوضاء محلي من أجل PEC أكثر قابلية للتوسع، وهو ما تستخدمه primitives الخاصة بـ IBM Quantum. إن الحمل الإضافي لاستخدام PEC الكامل سيقصر تطبيقه على الدوائر الصغيرة. لا بأس بذلك، لكن من المفيد أكثر امتلاك أداة تتوسع إلى حجم تصبح عنده الحوسبة الكمية ذات قيمة لمشكلات العالم الحقيقي. لهذا السبب، تستخدم primitives الخاصة بـ IBM Quantum طريقة PEC على مستوى الطبقات باستخدام نموذج ضوضاء Pauli-Lindblad متعلَّم، مع ضمانات صارمة لقابلية التوسع. في هذا التنفيذ لـ PEC، تُتعلَّم الضوضاء لكل طبقة دائرة متكررة، لا لكل نسخة بوابة، ويكون نموذج الضوضاء مُلتفًّا بباولي (Pauli-twirled) ومحليًا ومارکوفيًا. تُمتصّ بوابات Clifford في نموذج الضوضاء، بينما تهيمن البوابات غير Clifford على تكلفة التخفيف. ويُحدَّد سقف للحمل الإضافي لأخذ العينات لتجنب الانفجارات الأسية.
سنطبّق PEC المدمج في primitives الخاصة بـ IBM Quantum على مقياسين: صغير (ستة كيوبتات) ومتوسط الحجم (30 كيوبت) لنرى كيف تُبقى التكلفة قابلة للإدارة في هذه النسخة من PEC. ضمن كل تجربة بحجم معيّن، سنقارن أيضًا بشكل صريح نتائج PEC بنتائج عدم التخفيف، وبـ ZNE، وبالقيمة المثالية.
نبدأ باستيراد بعض الحزم اللازمة.
import numpy as np

from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp, Statevector

# from qiskit_aer import AerSimulator
from qiskit.transpiler import generate_preset_pass_manager

from qiskit_ibm_runtime import (
    # QiskitRuntimeService,
    Estimator,
    EstimatorOptions,
)
نختار مرصودًا (observable) لتقديره. المرصود أدناه هو هاميلتونيان لسلسلة من اللفات الشبيهة بنموذج إيزينغ مع اقتران الجار الأقرب فقط في المركّبة من تفاعلها، وحد أحادي الكيوبت في ، كما لو كان ناتجًا عن مجال خارجي في .
لا يوجد سبب خاص لاختيار هذا الهاميلتونيان. نحتاج ببساطة إلى مزيج من مرصود ودائرة غير تافهين ليتمكن تخفيف الأخطاء من أداء عمله. نقوم بتحجيم الهاميلتونيان صراحةً (باستخدام المعاملات)، بقسمة عدد الكيوبتات حتى تبقى الطاقة من الرتبة نفسها عند زيادة عدد الكيوبتات. نبدأ بستة فقط.
# This cell builds the observable

num_qubits = 6

terms = []
coeffs = []

# XX interactions
for i in range(num_qubits - 1):
    pauli = ["I"] * num_qubits
    pauli[i] = "X"
    pauli[i + 1] = "X"
    terms.append("".join(pauli))
    coeffs.append(1.0 / (num_qubits - 1))

# Z fields
for i in range(num_qubits):
    pauli = ["I"] * num_qubits
    pauli[i] = "Z"
    terms.append("".join(pauli))
    coeffs.append(0.5 / num_qubits)

observable = SparsePauliOp(terms, coeffs)
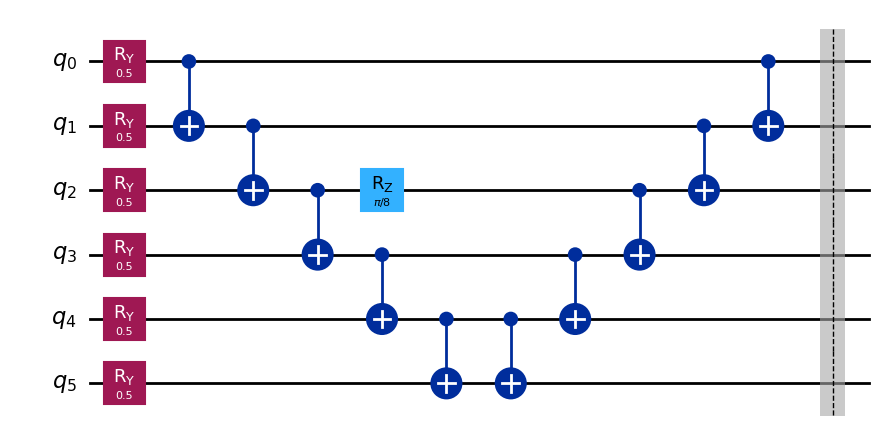
كما في اختيار الهاميلتونيان، لم تُختر دائرة تحضير الحالة أدناه لأسباب فيزيائية. بل اختيرت لتكون ذات عمق ثنائي الكيوبت كافٍ وعدد كافٍ من بوابات غير Clifford بحيث يكون PEC مفيدًا. ولا يوجد سبب للاعتقاد بأن هذه الدائرة تقريب جيد للحالة الأرضية لهذه السلسلة من اللفات، على سبيل المثال.
qc = QuantumCircuit(num_qubits)

# Clifford preparation
for i in range(num_qubits):
    #    qc.h(i)
    qc.ry(0.5, i)

# Clifford entanglement
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

# --- Non-Clifford "probe" ---
# Small-angle rotation (RZ(pi/8) ~= T gate)
qc.rz(3.141592653589793 / 8, 2)

# More Clifford mixing
for i in reversed(range(num_qubits - 1)):
    qc.cx(i, i + 1)

qc.barrier()

qc.draw("mpl")
نقوم بترجمة (transpile) دائرتنا ونطبّق التخطيط الناتج على المرصودات.
# service = QiskitRuntimeService()

# backend = service.least_busy(
##    operational=True,
#   simulator=False,
#   min_num_qubits=num_qubits,
# )

pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)

qc_transpiled = pm.run(qc)

layout = qc_transpiled.layout
obs_transpiled = observable.apply_layout(layout)
نحصل على القيمة المتوقعة المثالية باستخدام محاكي Statevector.
# Compute the ideal final state
state = Statevector.from_instruction(qc)

# Compute expectation value
ideal_value = np.real(state.expectation_value(observable))

print("Ideal (noiseless) expectation value:")
print(ideal_value)
Ideal (noiseless) expectation value:
0.6651408876730361
نتوقع أن تكون القيم المثالية الأخرى مشابهة في الحجم. نشغّل الآن هذا على حاسوب IBM كمي حقيقي دون أي تخفيف للأخطاء.
# This took 3 sec on ibm_fez. Your actual runtime might vary.

options_none = EstimatorOptions(resilience_level=0)

estimator_none = Estimator(
    mode=backend_real,
    options=options_none,
)

job_none = estimator_none.run([(qc_transpiled, obs_transpiled)])

value_none = job_none.result()[0].data.evs
print("No mitigation:", value_none)
No mitigation: 0.569677734375
نطبّق الآن ZNE على المسألة نفسها.
# This took 17 sec on ibm_fez. Your actual runtime might vary.

options_zne = EstimatorOptions(resilience_level=2)

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
print("ZNE:", value_zne)
ZNE: 0.6573718927156127
أخيرًا، نطبّق PEC.
# This took 17 sec on ibm_fez. Your actual runtime might vary.

from qiskit_ibm_runtime.options import EstimatorOptions

options = EstimatorOptions()

# One does not use ZNE with PEC
options.resilience.zne_mitigation = False
options.resilience.pec_mitigation = True
options.resilience.pec.max_overhead = 100

estimator_pec = Estimator(
    mode=backend_real,
    options=options,
)

job_pec = estimator_pec.run([(qc_transpiled, obs_transpiled)])

result = job_pec.result()
value_pec = result[0].data.evs

print("PEC:", value_pec)
PEC: 0.6666196849843695
نرسم نتائجنا أدناه ونقارن.
import matplotlib.pyplot as plt

methods = ["No mitigation", "ZNE", "PEC"]
values = [value_none, value_zne, value_pec]

ideal = ideal_value  # from Aer statevector

plt.figure(figsize=(6, 4))

plt.plot(methods, values, "o", label="Measured", markersize=8)
plt.axhline(ideal, color="black", linestyle="--", label="Ideal (Aer)")

plt.ylabel("Expectation value")
plt.title("Error mitigation comparison")
plt.legend()
plt.grid(axis="y", alpha=0.3)

plt.tight_layout()
plt.show()
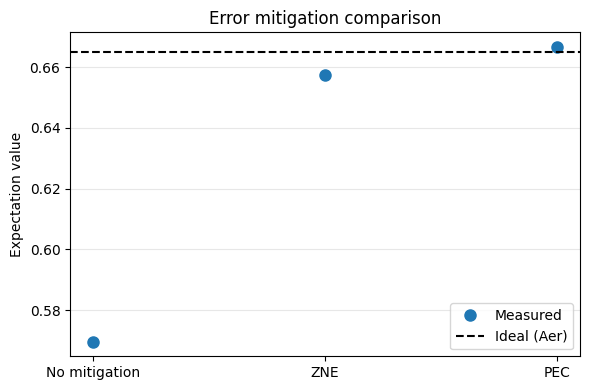
نجح هذا جيدًا جدًا. تقديرنا باستخدام PEC يبعد 0.2% فقط عن القيمة المثالية.
لكن تذكّر كيف ينمو الحمل الإضافي الكمي أسيًا. فرضنا حدًا أقصى للحمل الإضافي هو max_overhead = 100. من الزمن ومن جودة النتائج، يبدو أننا ربما لم نبلغ ذلك الحد الأقصى. لكن إذا وسّعنا حسابنا وأبقينا ذلك الحد، فسنبلغه وستتأثر نتائجنا.
يمكننا أن نرى ما يحدث عندما نوسّع دائرتنا إلى 30 كيوبت. من المثير للاهتمام أن محاكي Statevector على كثير من الحواسيب المحمولة يبدأ بانتهاء المهلة عند حوالي 24-28 كيوبت. يمكننا إيجاد طرق حسابية للالتفاف حول ذلك. لكن بدلًا من ذلك، لنتقبّل حقيقة أن الحواسيب الكمية ستتمكن من حل بعض المسائل بحجم لا تستطيع الحواسيب الكلاسيكية مجاراته. هذا هو المقصود. إذن ماذا يمكننا أن نفعل للتحقق من نتائج حوسبتنا الكمية في تلك الحالات؟ هناك عدة إجابات محتملة:
- بعض المسائل صعبة الحل لكن سهلة التحقق (مثل تحليل الأعداد إلى عواملها الأولية كما في خوارزمية شور).
- بعض المسائل لها أنظمة معاملات أو أشكال تقل فيها التعقيد ويمكن حلها كلاسيكيًا، أو حتى تحليليًا، لمقارنة بضع نقاط. في هذه الحالة، اخترنا هاميلتونيانًا جوهريًا (قسمنا على عدد الكيوبتات). يجب أن تكون القيمة المتوقعة المثالية مستقرة إلى حد كبير. لنرَ كيف تتغير القيمة المتوقعة المثالية مع عدد الكيوبتات ونرى هل يمكننا وضع تنبؤات كلاسيكية للقيمة عند 30 كيوبت.
import numpy as np
import matplotlib.pyplot as plt

from qiskit import QuantumCircuit
from qiskit.quantum_info import Statevector, SparsePauliOp

num_qubits_max = 24

qubits = [4, 8, 12, 16, 20, 24]
exp_vals = []
for num_qubits in qubits:
    qc = QuantumCircuit(num_qubits)

    for i in range(num_qubits):
        qc.ry(0.7, i)
    for i in range(num_qubits - 1):
        qc.cx(i, i + 1)
    for i in range(num_qubits):
        qc.rz(np.pi / 5, i)
    for i in reversed(range(num_qubits - 1)):
        qc.cx(i, i + 1)
    qc.barrier()

    terms = []
    coeffs = []

    # XX interactions
    for i in range(num_qubits - 1):
        pauli = ["I"] * num_qubits
        pauli[i] = "X"
        pauli[i + 1] = "X"
        terms.append("".join(pauli))
        coeffs.append(1.0 / (num_qubits - 1))

    # Z fields
    for i in range(num_qubits):
        pauli = ["I"] * num_qubits
        pauli[i] = "Z"
        terms.append("".join(pauli))
        coeffs.append(0.5 / num_qubits)

    observable = SparsePauliOp(terms, coeffs)

    # Compute the ideal final state
    state = Statevector.from_instruction(qc)

    # Compute expectation value
    ideal_value = np.real(state.expectation_value(observable))
    exp_vals.append(ideal_value)

print(exp_vals)

plt.figure()
plt.plot(qubits, exp_vals, "o", label="Statevector")
plt.xlabel("Number of qubits")
plt.ylabel(r"$\langle O^{\otimes N} \rangle$")
plt.legend()
plt.show()
[np.float64(0.7181764372838925), np.float64(0.7181764372838922), np.float64(0.7181764372838931), np.float64(0.7181764372838906), np.float64(0.7181764372838907), np.float64(0.7181764372838709)]
بالفعل، نرى أننا اخترنا هاميلتونيانًا وحالة لا يتغيران مع عدد الكيوبتات. هذا استخدام ضعيف جدًا للحوسبة الكمية في تطبيق بحثي، لكنه ممتاز لقياس أداء تقنيات تخفيف الأخطاء. يمكننا بثقة استخدام هذه القيمة المتوقعة الثابتة كنتيجة مثالية، حتى ونحن نزيد عدد الكيوبتات لاختبار تخفيف الأخطاء.
num_qubits = 30

qc = QuantumCircuit(num_qubits)

# Clifford preparation
for i in range(num_qubits):
    #    qc.h(i)
    qc.ry(0.7, i)

# Clifford entanglement
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

# --- Non-Clifford "probe" ---
# Small-angle rotation (RZ(pi/8) ~= T gate)

for i in range(num_qubits):
    qc.rz(np.pi / 5, i)

# More Clifford mixing
for i in reversed(range(num_qubits - 1)):
    qc.cx(i, i + 1)

qc.barrier()

qc.draw("mpl")

# This cell builds the observable

terms = []
coeffs = []

# XX interactions
for i in range(num_qubits - 1):
    pauli = ["I"] * num_qubits
    pauli[i] = "X"
    pauli[i + 1] = "X"
    terms.append("".join(pauli))
    coeffs.append(1.0 / (num_qubits - 1))

# Z fields
for i in range(num_qubits):
    pauli = ["I"] * num_qubits
    pauli[i] = "Z"
    terms.append("".join(pauli))
    coeffs.append(0.5 / num_qubits)

observable = SparsePauliOp(terms, coeffs)

# service = QiskitRuntimeService()

# backend = service.least_busy(
##    operational=True,
#   simulator=False,
#   min_num_qubits=num_qubits,
# )

pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)

qc_transpiled = pm.run(qc)

layout = qc_transpiled.layout
obs_transpiled = observable.apply_layout(layout)

# Compute the ideal final state
# This might time out above about 26 qubits. The Hamiltonian has been "normalized".
# The same expectation value calculated on the smaller example above is still valid.
# state = Statevector.from_instruction(qc)

# Compute expectation value
# ideal_value = np.real(state.expectation_value(observable))

print("Ideal (noiseless) expectation value:")
print(ideal_value)
Ideal (noiseless) expectation value:
0.7181764372838709
# This took 5 sec on ibm_fez. Your actual runtime might vary.

options_none = EstimatorOptions(resilience_level=0)

estimator_none = Estimator(
    mode=backend_real,
    options=options_none,
)

job_none = estimator_none.run([(qc_transpiled, obs_transpiled)])

value_none = job_none.result()[0].data.evs
print("No mitigation:", value_none)
No mitigation: 0.5869884271731322
نشغّل الآن هذه الدائرة الأكبر باستخدام ZNE.
# This took 17 sec on ibm_fez. Your actual runtime might vary.

options_zne = EstimatorOptions(resilience_level=2)

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
print("ZNE:", value_zne)
ZNE: 0.7096089981595511
أخيرًا، نشغّل مثال الـ 30 كيوبت باستخدام PEC.
# This took 4 min 57 sec on ibm_fez. Your actual runtime might vary.

options = EstimatorOptions()

# One does not use ZNE with PEC
options.resilience.zne_mitigation = False
options.resilience.pec_mitigation = True
options.resilience.pec.max_overhead = 100

estimator_pec = Estimator(
    mode=backend_real,
    options=options,
)

job_pec = estimator_pec.run([(qc_transpiled, obs_transpiled)])

value_pec = job_pec.result()[0].data.evs
print("PEC:", value_pec)
PEC: 0.3481257778627795
job_id_none = job_none.job_id()
job_id_zne = job_zne.job_id()
job_id_pec = job_pec.job_id()
print("job number with no mitigation:  ", job_id_none)
print("job number with ZNE  ", job_id_zne)
print("job number with PEC  ", job_id_pec)
job number with no mitigation:   d7uc79back5s73be1cv0
job number with ZNE   d7uc7c3ack5s73be1d40
job number with PEC   d7uc9k4inasc738smhu0
import matplotlib.pyplot as plt

methods = ["No mitigation", "ZNE", "PEC"]
values = [value_none, value_zne, value_pec]

ideal = ideal_value  # from Aer statevector

plt.figure(figsize=(6, 4))

plt.plot(methods, values, "o", label="Measured", markersize=8)
plt.axhline(ideal, color="black", linestyle="--", label="Ideal (Aer)")

plt.ylabel("Expectation value")
plt.title("Error mitigation comparison")
plt.legend()
plt.grid(axis="y", alpha=0.3)

plt.tight_layout()
plt.show()
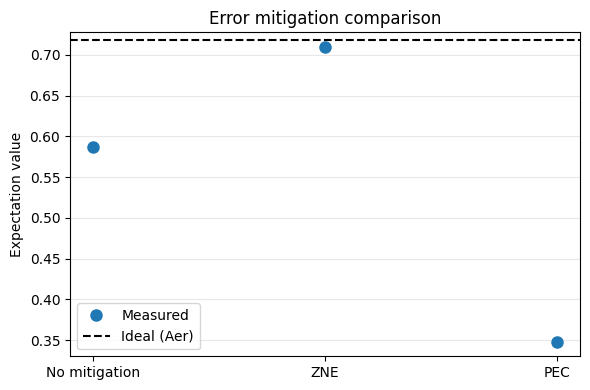
لم يستغرق PEC وقتًا أطول بكثير من الخيارات الأخرى فحسب، بل بلغنا بوضوح عتبة الحمل الإضافي الأقصى. دفعت نتائج PEC ثمن الحمل الإضافي، لكن سقف الحمل الإضافي منع الإلغاء الدقيق بما يكفي لنموذج الضوضاء المتعلَّم. وهذا أمر بالغ الأهمية. عند ستة كيوبتات، تمكنا من الاستفادة من PEC والحصول على نتائج أفضل مع زيادة متواضعة فقط في الحمل الكمي (حوالي عامل 5). أما عند 30 كيوبت، فدفعنا ثمنًا أعلى بكثير (حوالي 60 ضعفًا) وكانت النتائج أسوأ حتى من التقدير غير المخفَّف. لا يعني هذا أن PEC لا يمكن أن ينجح أبدًا مع 30 كيوبت؛ فقد يعتمد ذلك على الدائرة. الرسالة ببساطة هي أن النمو الأسي في الحمل الكمي يجعل تشغيله صعبًا للدوائر الكبيرة.
أهم الاستنتاجات:
-
غالبًا ما يفيد تخفيف أخطاء القياس وعادةً ما يحمل حملًا إضافيًا منخفضًا: فهو يزيل انحيازًا لا يتناسب مع عمق الدائرة ويتركّب بسلاسة مع كل شيء تقريبًا.
-
بعض التقنيات لا يمكن دمجها. وحتى عندما يمكن ذلك، تأكد من دمجها بطريقة متسقة بحيث لا تُبطل إحداها الأخرى. من الأمثلة الجيدة التأكد من تفعيل twirling أثناء المعايرة لـ M3 إذا كان سيتم دمج هاتين الطريقتين.
-
ينبغي اعتبار PEC وZNE بديلين لبعضهما. فهما يحلان المسألة نفسها بمقايضات متعاكسة:
-
PEC: يعطي قيمًا متوقعة غير متحيزة على حساب تباين أسي.
-
عادةً ما يعطي ZNE انحيازًا متبقيًا يعتمد على نموذج الاستقراء، لكن بتكلفة معتدلة.
-
-
يمكن أن يساعد DD في فترات الخمول الطويلة، لكنه يعيد تشكيل نموذج الضوضاء وقد يُبطل افتراضات الاستقراء أو العكس.
-
لا يقلل Pauli twirling الضوضاء. بل يعيد تشكيلها وغالبًا ما يمكّن التقنيات الأخرى من العمل بشكل أفضل (ZNE وPEC).