نماذج وامتدادات
يغطي هذا الفصل عدة خوارزميات كمية تبايُنية، من بينها:
من خلال استخدام هذه الخوارزميات، ستتعلم عدة أفكار تصميمية يمكن دمجها في خوارزميات تبايُنية مخصصة، مثل: الأوزان، والعقوبات، والمعاينة الزائدة، والمعاينة الناقصة. نشجعك على التجربة مع هذه المفاهيم ومشاركة نتائجك مع المجتمع.
يسري إطار أنماط Qiskit على جميع هذه الخوارزميات — غير أننا سنوضّح الخطوات صراحةً في المثال الأول فقط.
محلّل القيم الذاتية الكمي التبايُني (VQE)
VQE هو أحد أكثر خوارزميات الكم التبايُنية استخدامًا، إذ يضع قالبًا تبني عليه خوارزميات أخرى.
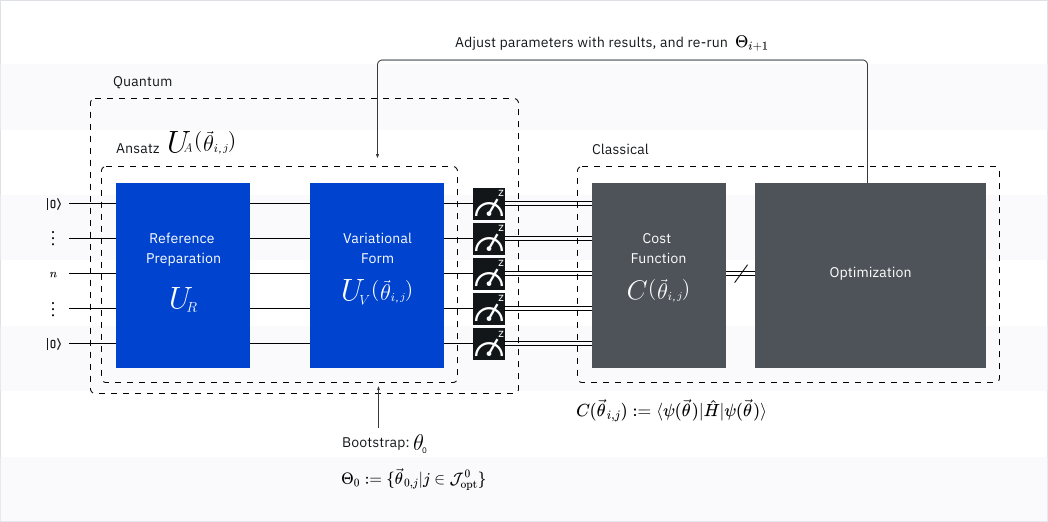
الخطوة 1: تحويل المدخلات الكلاسيكية إلى مسألة كمية
التصميم النظري
تصميم VQE بسيط:
-
تحضير المؤثرات المرجعية
- نبدأ من الحالة وننتقل إلى الحالة المرجعية
-
تطبيق الشكل التبايُني لإنشاء الأنزاتز
- ننتقل من الحالة إلى
-
التمهيد عند إذا كان لدينا مسألة مشابهة (تُوجَد عادةً عبر المحاكاة الكلاسيكية أو أخذ العينات)
- سيتمهّد كل مُحسِّن بطريقة مختلفة، مما ينتج عنه مجموعة أولية من متجهات المعاملات (مثلًا، من نقطة أولية ).
-
حساب دالة التكلفة لجميع الحالات المُعدَّة على حاسوب كمي.
-
استخدام مُحسِّن كلاسيكي لاختيار المجموعة التالية من المعاملات .
-
تكرار العملية حتى الوصول إلى التقارب.
هذه حلقة تحسين كلاسيكية بسيطة نحسب فيها دالة التكلفة. قد يتطلب بعض المحسِّنات تقييمات متعددة لحساب التدرج، أو تحديد التكرار التالي، أو تقييم التقارب.
إليك المثال للمؤثر القابل للرصد التالي:
التنفيذ
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"numpy": "numpy", "qiskit": "qiskit", "qiskit_ibm_runtime": "qiskit-ibm-runtime", "scipy": "scipy"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit.circuit.library import TwoLocal
import numpy as np

theta_list = (2 * np.pi * np.random.rand(1, 8)).tolist()
observable = SparsePauliOp.from_list([("II", 2), ("XX", -2), ("YY", 3), ("ZZ", -3)])

reference_circuit = QuantumCircuit(2)
reference_circuit.x(0)

variational_form = TwoLocal(
    2,
    rotation_blocks=["rz", "ry"],
    entanglement_blocks="cx",
    entanglement="linear",
    reps=1,
)

ansatz = reference_circuit.compose(variational_form)

ansatz.decompose().draw("mpl")

def cost_func_vqe(parameters, ansatz, hamiltonian, estimator):
    """Return estimate of energy from estimator

    Parameters:
        params (ndarray): Array of ansatz parameters
        ansatz (QuantumCircuit): Parameterized ansatz circuit
        hamiltonian (SparsePauliOp): Operator representation of Hamiltonian
        estimator (Estimator): Estimator primitive instance

    Returns:
        float: Energy estimate
    """

    estimator_job = estimator.run([(ansatz, hamiltonian, [parameters])])
    estimator_result = estimator_job.result()[0]

    cost = estimator_result.data.evs[0]
    return cost
from qiskit.primitives import StatevectorEstimator

estimator = StatevectorEstimator()
يمكننا استخدام دالة التكلفة هذه لحساب المعاملات المثلى
# SciPy minimizer routine
from scipy.optimize import minimize

x0 = np.ones(8)

result = minimize(
    cost_func_vqe, x0, args=(ansatz, observable, estimator), method="COBYLA"
)

result
message: Optimization terminated successfully.
 success: True
  status: 1
     fun: -5.999999982445723
       x: [ 1.741e+00  9.606e-01  1.571e+00  2.115e-05  1.899e+00
            1.243e+00  6.063e-01  6.063e-01]
    nfev: 136
   maxcv: 0.0
الخطوة 2: تحسين المسألة للتنفيذ الكمي
سنختار الخلفية الأقل انشغالًا، ونستورد المكوّنات الضرورية من qiskit_ibm_runtime.
from qiskit_ibm_runtime import SamplerV2 as Sampler
from qiskit_ibm_runtime import EstimatorV2 as Estimator
from qiskit_ibm_runtime import Session, EstimatorOptions
from qiskit_ibm_runtime import QiskitRuntimeService

service = QiskitRuntimeService()
backend = service.least_busy(operational=True, simulator=False)
print(backend)
<IBMBackend('ibm_brisbane')>
سنُحوِّل الدائرة باستخدام مدير التمريرات المُعدَّ مسبقًا بمستوى التحسين 3، ونُطبّق التخطيط المقابل على المؤثر القابل للرصد.
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

pm = generate_preset_pass_manager(backend=backend, optimization_level=3)
isa_ansatz = pm.run(ansatz)
isa_observable = observable.apply_layout(layout=isa_ansatz.layout)
الخطوة 3: التنفيذ باستخدام بدائيات IBM Quantum
نحن الآن جاهزون لتشغيل حساباتنا على عتاد IBM Quantum®. نظرًا لأن تقليل دالة التكلفة يتضمن تكرارات كثيرة، سنبدأ جلسة Runtime. بهذه الطريقة، ننتظر في قائمة الانتظار مرة واحدة فقط. بمجرد بدء تشغيل المهمة، ستعمل كل تكرارة بتحديثات للمعاملات فورًا.
x0 = np.ones(8)

estimator_options = EstimatorOptions(resilience_level=1, default_shots=10_000)

with Session(backend=backend) as session:
    estimator = Estimator(mode=session, options=estimator_options)

    result = minimize(
        cost_func_vqe,
        x0,
        args=(isa_ansatz, isa_observable, estimator),
        method="COBYLA",
        options={"maxiter": 200, "disp": True},
    )
session.close()
print(result)
الخطوة 4: المعالجة اللاحقة وإعادة النتيجة بالصيغة الكلاسيكية
يمكننا أن نرى أن روتين التقليل انتهى بنجاح، مما يعني وصولنا إلى التسامح الافتراضي للمحسِّن الكلاسيكي COBYLA. إذا أردنا نتيجة أدق، يمكننا تحديد تسامح أصغر. قد يكون ذلك ضروريًا فعلًا، إذ جاءت النتيجة مختلفة بنسبة بضعة بالمئة مقارنةً بنتيجة المحاكاة أعلاه.
القيمة x المُتحصَّل عليها هي أفضل تخمين حالي للمعاملات التي تُصغِّر دالة التكلفة. عند التكرار للحصول على دقة أعلى، يجب استخدام تلك القيم بدلًا من x0 المُستخدمة في البداية (متجه من الواحدات).
وأخيرًا، نلاحظ أن الدالة قُيِّمت 96 مرة خلال عملية التحسين. قد يختلف ذلك عن عدد خطوات التحسين، إذ يتطلب بعض المحسِّنات تقييمات متعددة في خطوة واحدة، كما هو الحال عند تقدير التدرج.
VQE بالبحث في الفضاء الجزئي (SSVQE)
SSVQE هو متغيّر من VQE يتيح الحصول على أول قيم ذاتية للمؤثر القابل للرصد ذات قيم ذاتية ، حيث . دون فقدان العمومية، نفترض أن . يُدخل SSVQE فكرة جديدة بإضافة أوزان للمساعدة في إعطاء الأولوية لتحسين الحد ذي الوزن الأكبر.
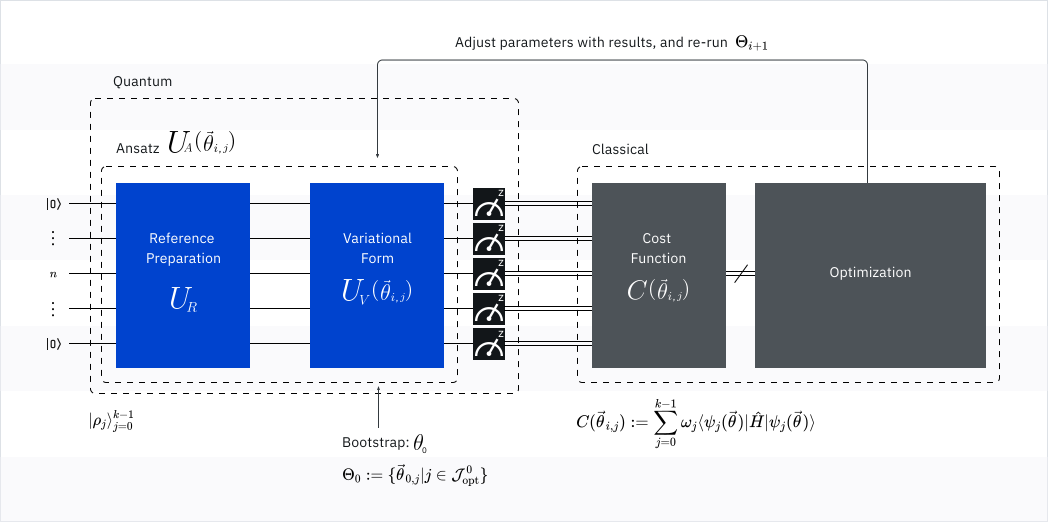
لتنفيذ هذه الخوارزمية، نحتاج إلى حالة مرجعية متعامدة بالتبادل ، بمعنى لـ . يمكن بناء هذه الحالات باستخدام مؤثرات باولي. دالة التكلفة لهذه الخوارزمية هي:
حيث عدد موجب اعتباطي بحيث إذا كان فإن ، و هو الشكل التبايُني المُعرَّف من قِبَل المستخدم.
تعتمد خوارزمية SSVQE على حقيقة أن الحالات الذاتية المقابلة لقيم ذاتية مختلفة تكون متعامدة بالتبادل. تحديدًا، يمكن التعبير عن الضرب الداخلي لـ و كما يلي:
تصح المساواة الأولى لأن مؤثر كمي وبالتالي أحادي. تصح المساواة الأخيرة بسبب تعامد الحالات المرجعية . حفاظ التحويلات الأحادية على التعامد مرتبط ارتباطًا وثيقًا بمبدأ حفظ المعلومات كما يُعبَّر عنه في علم معلومات الكم. من هذا المنظور، تُمثّل التحويلات غير الأحادية عمليات يُفقد فيها المعلومات أو تُضخَّ.
تساعد الأوزان على ضمان أن جميع الحالات هي حالات ذاتية. إذا كانت الأوزان مختلفة بما يكفي، فسيُعطى الأولوية للحد ذي الوزن الأكبر (أي ) أثناء التحسين على غيره. ونتيجةً لذلك، ستصبح الحالة هي الحالة الذاتية المقابلة لـ . ولأن تعامدية بالتبادل، ستكون الحالات المتبقية متعامدة معها، وبالتالي محتواة في الفضاء الجزئي المقابل للقيم الذاتية .
بتطبيق نفس المنطق على بقية الحدود، فإن الأولوية التالية ستكون للحد ذي الوزن ، وبالتالي ستكون هي الحالة الذاتية المقابلة لـ ، وستكون الحدود الأخرى محتواة في الفضاء الذاتي لـ .
باستخدام الاستنتاج الاستقرائي، نستنتج أن ستكون حالة ذاتية تقريبية لـ لكل .
التصميم النظري
يمكن تلخيص SSVQE كما يلي:
-
تحضير عدة حالات مرجعية بتطبيق وحدوي U_R على k حالة مختلفة من حالات الأساس الحسابي
- تتطلب هذه الخوارزمية استخدام حالة مرجعية متعامدة بالتبادل ، بحيث لـ .
-
تطبيق الشكل التبايُني على كل حالة مرجعية، مما ينتج الأنزاتز .
-
التمهيد عند إذا كانت مسألة مشابهة متاحة (تُوجَد عادةً عبر المحاكاة الكلاسيكية أو أخذ العينات).
-
حساب دالة التكلفة لجميع الحالات المُعدَّة على حاسوب كمي.
-
يمكن تقسيم ذلك إلى حساب قيمة التوقع للمؤثر القابل للرصد وضرب النتيجة في .
-
بعد ذلك، تُعيد دالة التكلفة مجموع جميع قيم التوقع الموزونة.
-
-
استخدام مُحسِّن كلاسيكي لتحديد المجموعة التالية من المعاملات .
-
تكرار الخطوات السابقة حتى تحقق التقارب.
ستُعيد بناء دالة تكلفة SSVQE في التقييم، لكننا نقدم المقطع التالي لتحفيز حلّك:
import numpy as np

def cost_func_ssvqe(
    params, initialized_anastz_list, weights, ansatz, hamiltonian, estimator
):
    # """Return estimate of energy from estimator

    # Parameters:
    #     params (ndarray): Array of ansatz parameters
    #     initialized_anastz_list (list QuantumCircuit): Array of initialised ansatz with reference
    #     weights (list): List of weights
    #     ansatz (QuantumCircuit): Parameterized ansatz circuit
    #     hamiltonian (SparsePauliOp): Operator representation of Hamiltonian
    #     estimator (Estimator): Estimator primitive instance

    # Returns:
    #     float: Weighted energy estimate
    # """

    energies = []

    # Define SSVQE

    weighted_energy_sum = np.dot(energies, weights)
    return weighted_energy_sum
الانحراف الكمي التبايُني (VQD)
VQD هو أسلوب تكراري يمتد على VQE للحصول على أول قيم ذاتية للمؤثر القابل للرصد ذات قيم ذاتية ، حيث ، بدلًا من الحصول على الأولى فقط. في بقية هذا القسم، سنفترض دون فقدان العمومية أن . يُدخل VQD مفهوم تكلفة العقوبة لتوجيه عملية التحسين.
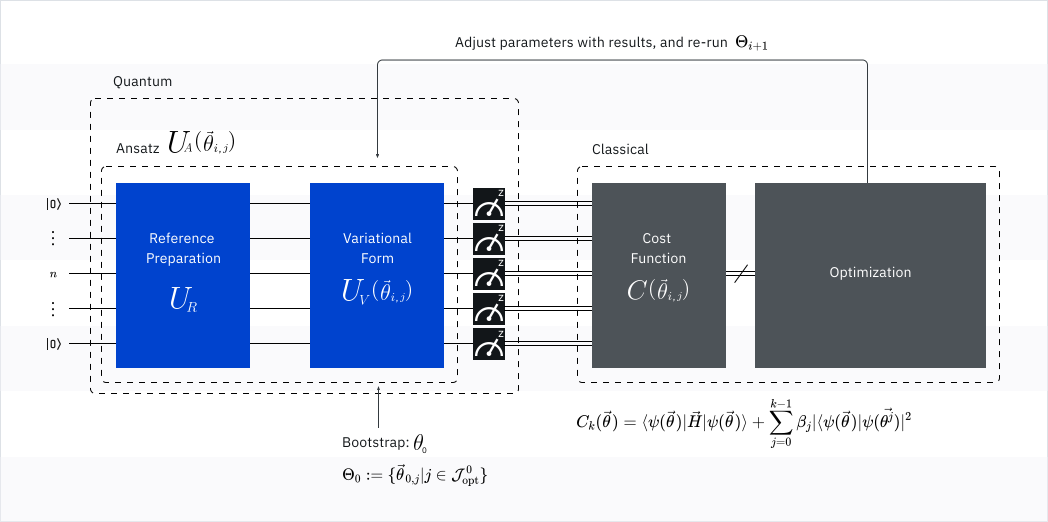 VQD introduces a penalty term, denoted as , to balance the contribution of each overlap term to the cost. This penalty term serves to penalize the optimization process if orthogonality is not achieved. We impose this constraint because the eigenstates of an observable, or a Hermitian operator, corresponding to different eigenvalues are always mutually orthogonal, or can be made to be so in the case of degeneracy or repeated eigenvalues. Thus, by enforcing orthogonality with the eigenstate corresponding to , we are effectively optimizing over the subspace that corresponds to the rest of the eigenvalues . Here, is the lowest eigenvalue from the rest of the eigenvalues and, therefore, the optimal solution of the new problem can be obtained using the variational theorem.
الفكرة العامة وراء VQD هي استخدام VQE كالمعتاد للحصول على أصغر قيمة ذاتية مع الحالة الذاتية (التقريبية) المقابلة عند متجه معاملات أمثل . بعد ذلك، للحصول على القيمة الذاتية التالية ، بدلًا من تصغير دالة التكلفة ، نُحسِّن:
القيمة الموجبة ينبغي أن تكون من الناحية المثالية أكبر من .
هذا يقدم دالة تكلفة جديدة يمكن اعتبارها مشكلة مقيدة، حيث نصغّر مع القيد بأن الحالة يجب أن تكون متعامدة مع التي تم الحصول عليها سابقاً، مع عمل كحد عقوبة إذا لم يتحقق القيد.
بدلاً من ذلك، يمكن تفسير هذه المشكلة الجديدة على أنها تشغيل VQE على المرصود الجديد:
بافتراض أن حل المشكلة الجديدة هو ، فإن القيمة المتوقعة لـ (وليس ) يجب أن تكون . للحصول على القيمة الذاتية الثالثة ، دالة التكلفة الواجب تحسينها هي:
حيث ثابت موجب كبير بما يكفي لفرض تعامد حالة الحل مع كل من و . هذا يعاقب الحالات في فضاء البحث التي لا تلبي هذا الشرط، مما يقيّد فضاء البحث بفعالية. وبالتالي، فإن الحل الأمثل للمشكلة الجديدة يجب أن يكون الحالة الذاتية المقابلة لـ .
كما في الحالة السابقة، يمكن تفسير هذه المشكلة الجديدة أيضاً كـ VQE مع المرصود:
إذا كان حل هذه المشكلة الجديدة هو ، فإن القيمة المتوقعة لـ (وليس ) يجب أن تكون . وبالمثل، للحصول على القيمة الذاتية وهي ، تصغّر دالة التكلفة:
تذكّر أننا عرّفنا بحيث . تكافئ هذه المسألة تصغير لكن مع القيد بأن الحالة يجب أن تكون متعامدة مع ، مما يُقيّد فضاء البحث إلى الفضاء الجزئي المقابل للقيم الذاتية .
هذه المشكلة تكافئ VQE مع المرصود:
كما ترى من هذه العملية، للحصول على القيمة الذاتية ، تحتاج إلى الحالات الذاتية (التقريبية) لقيم السابقة، لذا ستحتاج إلى تشغيل VQE إجمالاً مرات. لذلك، دالة تكلفة VQD هي كما يلي:
التصميم النظري
يمكن تلخيص تصميم VQD كما يلي:
-
تحضير مؤثر مرجعي
-
تطبيق الشكل التبايُني على الحالة المرجعية، مما ينتج الأنزاتزات
-
التمهيد عند إذا كان لدينا مسألة مشابهة (تُوجَد عادةً عبر المحاكاة الكلاسيكية أو أخذ العينات).
-
حساب دالة التكلفة ، والتي تتضمن حساب حالات مثارة ومصفوفة من 's تحدد عقوبة التداخل لكل حد تداخل.
-
حساب قيمة التوقع للمؤثر القابل للرصد لكل
-
حساب العقوبة .
-
يجب على دالة التكلفة إعادة مجموع هذين الحدين
-
-
استخدم مُحسِّناً كلاسيكياً لاختيار مجموعة المعاملات التالية .
-
تكرار هذه العملية حتى تحقق التقارب.
التنفيذ
في هذا التنفيذ، سننشئ دالة لعقوبة التداخل. ستُستخدم هذه العقوبة في دالة التكلفة عند كل تكرارة. ستُكرَّر هذه العملية لكل حالة مثارة.
from qiskit.circuit.library import TwoLocal

ansatz = TwoLocal(2, rotation_blocks=["ry", "rz"], entanglement_blocks="cz", reps=1)

ansatz.decompose().draw("mpl")

أولًا، سننشئ دالة تحسب أمانة الحالة — نسبة التداخل بين حالتين سنستخدمها كعقوبة لـ VQD:
import numpy as np

def calculate_overlaps(ansatz, prev_circuits, parameters, sampler):
    def create_fidelity_circuit(circuit_1, circuit_2):
        """
        Constructs the list of fidelity circuits to be evaluated.
        These circuits represent the state overlap between pairs of input circuits,
        and their construction depends on the fidelity method implementations.
        """

        if len(circuit_1.clbits) > 0:
            circuit_1.remove_final_measurements()
        if len(circuit_2.clbits) > 0:
            circuit_2.remove_final_measurements()

        circuit = circuit_1.compose(circuit_2.inverse())
        circuit.measure_all()
        return circuit

    overlaps = []

    for prev_circuit in prev_circuits:
        fidelity_circuit = create_fidelity_circuit(ansatz, prev_circuit)
        sampler_job = sampler.run([(fidelity_circuit, parameters)])
        meas_data = sampler_job.result()[0].data.meas

        counts_0 = meas_data.get_int_counts().get(0, 0)
        shots = meas_data.num_shots
        overlap = counts_0 / shots
        overlaps.append(overlap)

    return np.array(overlaps)
حان الوقت لكتابة دالة تكلفة VQD. كما فعلنا عند حساب حالة الأساس فقط، سنحدد حالة أدنى طاقة باستخدام البدائي Estimator. غير أنه، كما هو موضح أعلاه، سنضيف الآن حد عقوبة لضمان تعامد الحالات ذات الطاقات الأعلى. أي أنه لكل حالة مثارة جديدة، تُضاف عقوبة لأي تداخل بين الحالة التبايُنية الحالية والحالات الذاتية ذات الطاقات الأدنى التي وُجدت بالفعل.
def cost_func_vqd(
    parameters, ansatz, prev_states, step, betas, estimator, sampler, hamiltonian
):
    estimator_job = estimator.run([(ansatz, hamiltonian, [parameters])])

    total_cost = 0

    if step > 1:
        overlaps = calculate_overlaps(ansatz, prev_states, parameters, sampler)
        total_cost = np.sum(
            [np.real(betas[state] * overlap) for state, overlap in enumerate(overlaps)]
        )

    estimator_result = estimator_job.result()[0]

    value = estimator_result.data.evs[0] + total_cost

    return value
لاحظ بشكل خاص أن دالة التكلفة أعلاه تُشير إلى دالة calculate_overlaps، التي تُنشئ فعليًا دائرة كمية جديدة. إذا أردنا التشغيل على عتاد حقيقي، يجب أيضًا تحويل تلك الدائرة الجديدة بشكل مثلى للتشغيل على الخلفية التي نختارها. لاحظ أن التحويل قد بُني في دالتي calculate_overlaps أو cost_func_vqd. جرِّب تعديل الكود بنفسك لإضافة هذا التحويل الإضافي (والشرطي) — لكن سيتم ذلك من أجلك أيضًا في الدرس التالي.
في هذا الدرس، سنشغِّل خوارزمية VQD باستخدام Statevector Sampler وStatevector Estimator:
from qiskit.primitives import StatevectorEstimator as Estimator

sampler = Sampler()
estimator = Estimator()
سنُدخل مؤثرًا قابلًا للرصد لتقديره. في الدرس التالي سنضيف سياقًا فيزيائيًا لهذا، مثل الحالة المثارة لجزيء. قد يكون من المفيد التفكير في هذا المؤثر القابل للرصد على أنه هاملتوني لنظام يمكن أن تكون له حالات مثارة، حتى لو لم يُختَر هذا المؤثر ليتوافق مع أي جزيء أو ذرة معينة.
from qiskit.quantum_info import SparsePauliOp

observable = SparsePauliOp.from_list([("II", 2), ("XX", -2), ("YY", 3), ("ZZ", -3)])
هنا، نحدد العدد الإجمالي للحالات التي نرغب في حسابها (حالة الأساس والحالات المثارة، k)، والعقوبات (betas) للتداخل بين متجهات الحالات التي يجب أن تكون متعامدة. سيتم استكشاف تداعيات اختيار betas مرتفعة جدًا أو منخفضة جدًا في الدرس التالي. في الوقت الحالي، سنستخدم ببساطة تلك المُقدَّمة أدناه. سنبدأ باستخدام جميع الأصفار كمعاملاتنا. في حساباتك الخاصة، قد ترغب في استخدام معاملات أولية أكثر ذكاءً بناءً على معرفتك بالنظام أو على حسابات سابقة.
k = 3
betas = [33, 33, 33]
x0 = np.zeros(8)
يمكننا الآن تشغيل الحساب:
from scipy.optimize import minimize

prev_states = []
prev_opt_parameters = []
eigenvalues = []

for step in range(1, k + 1):
    if step > 1:
        prev_states.append(ansatz.assign_parameters(prev_opt_parameters))

    result = minimize(
        cost_func_vqd,
        x0,
        args=(ansatz, prev_states, step, betas, estimator, sampler, observable),
        method="COBYLA",
        options={
            "maxiter": 200,
        },
    )
    print(result)

    prev_opt_parameters = result.x
    eigenvalues.append(result.fun)
message: Optimization terminated successfully.
 success: True
  status: 1
     fun: -5.999999979545955
       x: [-5.150e-01 -5.452e-02 -1.571e+00 -2.853e-05  2.671e-01
           -2.672e-01 -8.509e-01 -8.510e-01]
    nfev: 131
   maxcv: 0.0
 message: Optimization terminated successfully.
 success: True
  status: 1
     fun: 4.024550284767612
       x: [-3.745e-01  1.041e+00  8.637e-01  1.202e+00 -8.847e-02
            1.181e-02  7.611e-01 -3.006e-01]
    nfev: 110
   maxcv: 0.0
 message: Optimization terminated successfully.
 success: True
  status: 1
     fun: 5.608925562838559
       x: [-2.670e-01  1.280e+00  1.070e+00 -8.031e-01 -1.524e-01
           -6.956e-02  7.018e-01  1.514e+00]
    nfev: 90
   maxcv: 0.0
القيم التي حصلنا عليها من دالة التكلفة هي تقريبًا -6.00 و4.02 و5.61. المهم في هذه النتائج أن قيم الدالة آخذة في الازدياد. لو حصلنا على حالة أولى مثارة ذات طاقة أدنى من حساب الأولي غير المقيَّد لحالة الأساس، كان ذلك سيشير إلى خطأ ما في كودنا.
قيم x هي المعاملات التي أعطت متجه حالة يقابل كل تكلفة (طاقة) من هذه التكاليف.
وأخيرًا، نلاحظ أن جميع التقليلات الثلاثة تقاربت ضمن التسامح الافتراضي للمحسِّن الكلاسيكي (هنا COBYLA). احتاجت إلى 131 و110 و90 تقييمًا للدالة على التوالي.
الانحدار بأخذ العينات الكمية (QSR)
أحد المشاكل الرئيسية في VQE هو النداءات المتعددة لحاسوب كمي المطلوبة للحصول على المعاملات لكل خطوة، مثلًا ، ، وهكذا. هذا مُشكل بشكل خاص عندما يكون الوصول إلى أجهزة الكم مُصطَفًا في قائمة انتظار. بينما يمكن استخدام Session لتجميع نداءات تكرارية متعددة، فإن نهجًا بديلًا هو استخدام أخذ العينات. باستخدام موارد كلاسيكية أكثر، يمكننا إتمام عملية التحسين الكاملة في نداء واحد. هنا يأتي دور الانحدار بأخذ العينات الكمية. نظرًا لأن الوصول إلى أجهزة الكم لا يزال سلعة ذات عرض منخفض وطلب مرتفع، نجد هذه المقايضة ممكنة ومناسبة للعديد من الدراسات الحالية. يستغل هذا النهج جميع الإمكانيات الكلاسيكية المتاحة مع الإبقاء على كثير من الآليات الداخلية والخصائص الجوهرية للحسابات الكمية التي لا تظهر في المحاكاة.
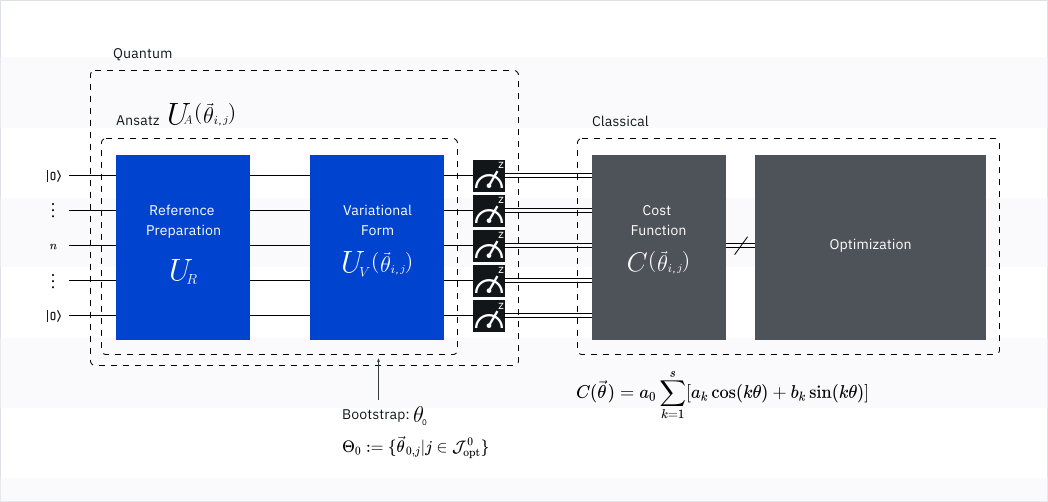
الفكرة وراء QSR هي أن دالة التكلفة يمكن التعبير عنها كمتسلسلة فورييه بالطريقة التالية:
اعتمادًا على دورية وعرض نطاق الدالة الأصلية، قد تكون المجموعة منتهية أو لا نهائية. لأغراض هذا النقاش، سنفترض أنها لا نهائية. الخطوة التالية هي أخذ عينات من دالة التكلفة مرات متعددة للحصول على معاملات فورييه . تحديدًا، بما أن لدينا مجهولًا، سنحتاج إلى أخذ عينات من دالة التكلفة مرة.
إذا أخذنا عينات من دالة التكلفة لـ قيمة معاملة ، يمكننا الحصول على النظام التالي:
الذي سنُعيد كتابته كـ
عمليًا، هذا النظام غير متسق عمومًا لأن قيم دالة التكلفة ليست دقيقة. لذلك، من الجيد عادةً تطبيعها بضربها بـ من اليسار، مما ينتج:
هذا النظام الجديد دائمًا متسق، وحله هو حل المربعات الصغرى للمسألة الأصلية. إذا كان لدينا معاملة بدلًا من واحدة فقط، وكان لكل معاملة قيمة خاصة بها لـ ، فإن العدد الإجمالي من العينات المطلوبة هو:
حيث . علاوةً على ذلك، فإن ضبط كمعاملة قابلة للضبط (بدلًا من استنتاجها) يفتح إمكانيات جديدة، مثل:
-
المعاينة الزائدة لتحسين الدقة.
-
المعاينة الناقصة لتعزيز الأداء من خلال تقليل تكلفة وقت التشغيل أو التخلص من الحدود الدنيا المحلية.
التصميم النظري
يمكن تلخيص تصميم QSR كما يلي:
-
تحضير مؤثرات مرجعية .
- سننتقل من الحالة إلى الحالة المرجعية
-
تطبيق الشكل التبايُني لإنشاء الأنزاتز .
- تحديد عرض النطاق المرتبط بكل معاملة في الأنزاتز. الحد الأعلى كافٍ.
-
التهيئة المسبقة (bootstrap) عند انطلاقًا من حلّ مسألة مشابهة إن توفّرت (وعادةً ما يُحصَل عليه بالمحاكاة أو أخذ العينات الكلاسيكية).
-
عيّن دالة التكلفة على الأقل مرات.
-
-
تحديد ما إذا كانت المعاينة الزائدة/الناقصة مناسبة لموازنة السرعة مقابل الدقة عن طريق ضبط .
-
-
حساب معاملات فورييه من العينات (أي حل نظام المعادلات الخطي المُطبَّع).
-
حل الحد الأدنى العالمي لدالة الانحدار الناتجة على آلة كلاسيكية.
ملخص
من خلال هذا الدرس، تعلمت عن نماذج تبايُنية متعددة متاحة:
-
التصميم العام
-
إدخال الأوزان والعقوبات لضبط دالة التكلفة
-
استكشاف المعاينة الناقصة مقابل الزائدة للمقايضة بين السرعة والدقة
يمكن تكييف هذه الأفكار لتشكيل خوارزمية تبايُنية مخصصة تتناسب مع مسألتك. نشجعك على مشاركة نتائجك مع المجتمع. سيستكشف الدرس التالي كيفية استخدام خوارزمية تبايُنية لحل تطبيق ما.