صنّف مخاطر الائتمان باستخدام استخراج الميزات الكمية Rimay من Kipu Quantum
دوال Qiskit Functions ميزة تجريبية متاحة فقط لمستخدمي IBM Quantum® Premium Plan وFlex Plan وOn-Prem (عبر IBM Quantum Platform API) Plan. وهي في حالة إصدار معاينة وقابلة للتغيير.
تقدير الاستخدام: دقيقتان على معالج Nighthawk r2. (ملاحظة: هذا تقدير فقط. قد يختلف وقت التشغيل لديك.)
نتائج التعلم
-
جهّز بيانات جدولية بأعمدة فئوية ورقمية لدالة Rimay من Qiskit Functions.
-
اضبط تعيين ميزات كمية على بيانات التدريب وعيّن بيانات الاختبار في التشغيل نفسه.
-
درّب نماذج كلاسيكية على الميزات المحوّلة كميًا، منفردةً ومدمجةً مع الميزات الأصلية.
-
قارن النتائج بخط أساس كلاسيكي بحت.
المتطلبات المسبقة
قبل أن تبدأ هذا الدرس، يُفضّل أن تكون على دراية بالمواضيع التالية:
-
التصنيف الخاضع للإشراف مع scikit-learn
الخلفية
كثير من مسائل تعلّم الآلة في الصناعة تتعامل مع مجموعات بيانات جدولية صغيرة أو متوسطة الحجم، حيث لا يمكن إضافة بيانات أكثر وتتوقف دقة النموذج عن التحسّن. تقييم مخاطر الائتمان مثال نموذجي على ذلك. فالمُقرِض يستخدم بضع عشرات من السمات ليقرر ما إذا كان المتقدّم سيسدّد القرض على الأرجح.
تضيف Rimay، وهي Qiskit Function من Kipu Quantum، خطوة معالجة مسبقة كمّية إلى خط معالجة كهذا. وهي تنفّذ خوارزمية استخلاص الميزات الكمّية المضادة للاديباتية المرقمنة [1]. تُربط كل ميزة مدخلة بكيوبت واحد. وتحدد قيم الميزات والمعلومات المتبادلة بينها الحقول المحلية والاقترانات في هاميلتوني من نوع الزجاج الدوراني. بعد ذلك تُطوِّر الديناميكيات المضادة للاديباتية النظام الكمّي نحو حالاته منخفضة الطاقة، وتصبح القيم المتوقعة أحادية وثنائية الجسيم المقاسة في النهاية هي الميزات الجديدة المحوّلة كمّيًا. تلتقط هذه الميزات الارتباطات غير الخطية بين المدخلات، ويمكنك تمريرها إلى أي نموذج كلاسيكي.
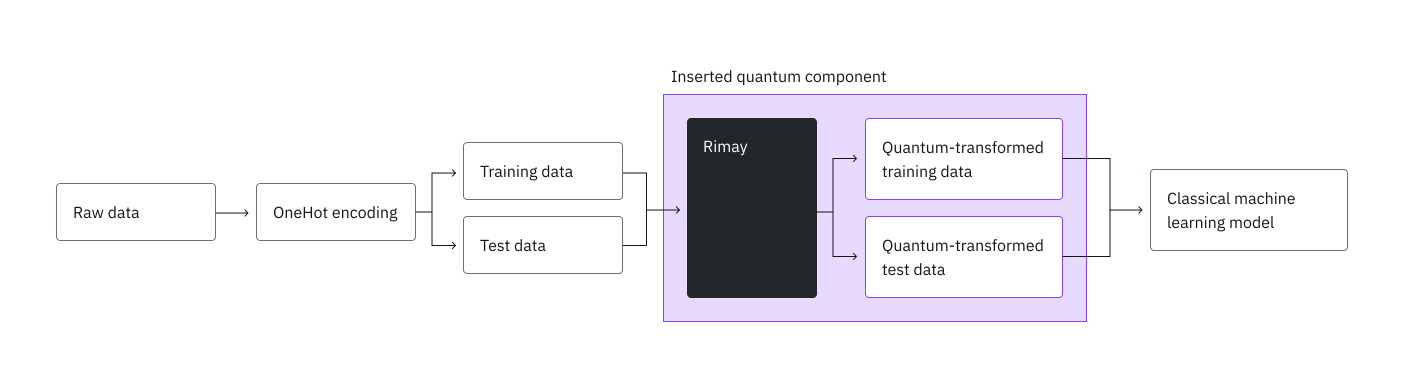
يستخدم هذا الدرس مجموعة بيانات الائتمان الألمانية من OpenML [2]، وتضم 1000 متقدّم و20 سمة، لتدريب مصنّف الغابة العشوائية. ستبدأ بإنشاء خط أساس كلاسيكي، ثم ترسل البيانات إلى Rimay، وأخيرًا تدرّب النوع نفسه من النماذج على الميزات المحوّلة كمّيًا، سواء وحدها أو مدمجة مع الميزات الأصلية.
المتطلبات
قبل أن تبدأ هذا الدرس، تأكد من تثبيت الحزم التالية:
-
عميل IBM Quantum Compute (
pip install qiskit-ibm-runtime) -
Qiskit Functions (
pip install qiskit-ibm-catalog) -
scikit-learn (
pip install scikit-learn) -
pandas (
pip install pandas) -
Matplotlib (
pip install matplotlib)
تحتاج أيضًا إلى صلاحية الوصول إلى دالة Rimay من كتالوج Qiskit Functions.
الإعداد
استورد الحزم وعرّف دالتين مساعدتين: واحدة تدرّب غابة عشوائية، والأخرى تحسب المقاييس المستخدمة في الدرس كله.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "pandas": "pandas", "qiskit_ibm_catalog": "qiskit-ibm-catalog", "sklearn": "scikit-learn"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
from qiskit_ibm_catalog import QiskitFunctionsCatalog
from sklearn.datasets import fetch_openml
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import (
    accuracy_score,
    f1_score,
    precision_score,
    recall_score,
    roc_auc_score,
)
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import OneHotEncoder

def train_random_forest(x, y, n_estimators, max_depth):
    """Train a random forest classifier with fixed hyperparameters."""
    model = RandomForestClassifier(
        n_estimators=n_estimators,
        max_depth=max_depth,
        min_samples_split=5,
        min_samples_leaf=1,
        max_features="sqrt",
        random_state=42,
        n_jobs=-1,
    )
    return model.fit(x, y)

def evaluate(model, x, y):
    """Return the classification metrics of a trained model on a test set."""
    y_pred = model.predict(x)
    y_proba = model.predict_proba(x)[:, 1]
    return {
        "Accuracy": accuracy_score(y, y_pred),
        "AUC": roc_auc_score(y, y_proba),
        "F1 score": f1_score(y, y_pred),
        "Precision": precision_score(y, y_pred),
        "Recall": recall_score(y, y_pred),
    }
إعداد بيانات اعتماد IBM Quantum
سجّل الدخول باستخدام مفتاح API لمنصة IBM Quantum Platform، ثم حمّل دالة Rimay، واختر المعالج الكمّي الأقل انشغالًا من بين المتاحة لنسختك.
catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")
rimay = catalog.load("kipu-quantum/rimay")

backend = catalog.least_busy(operational=True, simulator=False)
print(backend.name, backend.num_qubits)
ibm_fez 156
الخطوة 1: ربط المدخلات الكلاسيكية بمسألة كمّية
تربط Rimay كل ميزة عددية مدخلة بكيوبت واحد، لذا فإن الخطوة الأولى هي تحويل الجدول الخام إلى ميزات عددية.
تحميل مجموعة البيانات
حمّل مجموعة بيانات الائتمان الألمانية مباشرة من OpenML. يحمل العمود class التسمية: good للمتقدّمين الذين سدّدوا قرضهم وbad للذين لم يسدّدوه.
df = fetch_openml(data_id=31, as_frame=True).frame
print(df.shape)
df.head()
(1000, 21)
checking_status  duration                  credit_history  \
0              <0         6  critical/other existing credit
1        0<=X<200        48                   existing paid
2     no checking        12  critical/other existing credit
3              <0        42                   existing paid
4              <0        24              delayed previously

               purpose  credit_amount    savings_status employment  \
0             radio/tv           1169  no known savings        >=7
1             radio/tv           5951              <100     1<=X<4
2            education           2096              <100     4<=X<7
3  furniture/equipment           7882              <100     4<=X<7
4              new car           4870              <100     1<=X<4

   installment_commitment     personal_status other_parties  ...  \
0                       4         male single          none  ...
1                       2  female div/dep/mar          none  ...
2                       2         male single          none  ...
3                       2         male single     guarantor  ...
4                       3         male single          none  ...

   property_magnitude age  other_payment_plans   housing existing_credits  \
0         real estate  67                 none       own                2
1         real estate  22                 none       own                1
2         real estate  49                 none       own                1
3      life insurance  45                 none  for free                1
4   no known property  53                 none  for free                2

                  job num_dependents  own_telephone foreign_worker class
0             skilled              1            yes            yes  good
1             skilled              1           none            yes   bad
2  unskilled resident              2           none            yes  good
3             skilled              2           none            yes  good
4             skilled              2           none            yes   bad

[5 rows x 21 columns]
ترميز الميزات
حوّل التسمية إلى قيمة ثنائية، ورمّز الأعمدة الفئوية الـ13 بترميز one-hot. تحذف الشيفرة الفئة الأولى من كل عمود لتجنّب الميزات الزائدة عن الحاجة، فينتج عن ذلك 48 ميزة عددية.
y = (df["class"] == "good").astype(int)

features = df.drop(columns="class")
categorical_cols = [
    col for col in features.columns if features[col].dtype.name == "category"
]
encoder = OneHotEncoder(
    sparse_output=False, handle_unknown="ignore", drop="first"
)
encoded = pd.DataFrame(
    encoder.fit_transform(features[categorical_cols]),
    columns=encoder.get_feature_names_out(categorical_cols),
    index=features.index,
)
x = pd.concat([features.drop(columns=categorical_cols), encoded], axis=1)
print(f"{x.shape[1]} features")
48 features
التقسيم إلى مجموعتي تدريب واختبار
احتفظ بـ20% من المتقدّمين كمجموعة اختبار. يحافظ التقسيم الطبقي على تساوي نسبة الائتمان الجيد والسيئ في المجموعتين.
x_train, x_test, y_train, y_test = train_test_split(
    x, y, test_size=0.2, random_state=42, stratify=y
)
print(f"Training set: {x_train.shape}, test set: {x_test.shape}")
Training set: (800, 48), test set: (200, 48)
إنشاء خط أساس كلاسيكي
درّب غابة عشوائية على الميزات الكلاسيكية. في الخطوة 4 ستقارن الميزات المحوّلة كمّيًا بمقاييسها.
baseline = train_random_forest(
    x_train, y_train, n_estimators=500, max_depth=12
)
results = {"Classical": evaluate(baseline, x_test, y_test)}
pd.DataFrame(results).T
Accuracy       AUC  F1 score  Precision    Recall
Classical     0.765  0.781071  0.845902   0.781818  0.921429
رفع البيانات إلى Rimay
تقرأ Rimay مدخلاتها من ملفات CSV ترفعها إلى الدالة. تُوضع الميزات والتسميات في ملفات منفصلة. سترفع أيضًا مجموعة الاختبار، حتى تطبّق Rimay عليها نفس الربط الذي تعلّمته من مجموعة التدريب.
x_train.to_csv("x_train.csv", index=False)
y_train.to_csv("y_train.csv", index=False)
x_test.to_csv("x_test.csv", index=False)

for file_name in ("x_train.csv", "y_train.csv", "x_test.csv"):
    catalog.file_upload(file_name, rimay)
الخطوة 2: تحسين المسألة للتنفيذ على العتاد الكمّي
تبني Rimay الدوائر وتحوّلها للمعالج الذي تختاره، لذا لا توجد دائرة تحتاج إلى تحسين يدوي. حدّد عدد اللقطات لكل دائرة ضمن القيود التالية:
-
تحتاج كل ميزة إلى كيوبت واحد، لذا يجب أن يملك المعالج عددًا من الكيوبتات لا يقل عن عدد ميزات مجموعة البيانات.
-
تشغّل Rimay دائرة واحدة لكل صف، من صفوف التدريب والاختبار معًا. يمكن للمهمة الواحدة أن تطلب 10 ملايين تنفيذ كحدٍّ أقصى، لذا يجب أن يبقى عدد الصفوف مضروبًا في
shotsضمن هذا الحد.
تحقق من الحدّين كليهما قبل إرسال المهمة.
يجب أيضًا أن تنتهي المهمة خلال 24 ساعة، بما في ذلك الوقت الذي تنتظره دوائرها في الطابور، وإلا فستتوقف دون نتيجة.
shots = 5000

n_rows = len(x_train) + len(x_test)
n_features = x_train.shape[1]
print(f"Qubits needed: {n_features} of {backend.num_qubits} available")
print(f"Executions: {n_rows * shots:,} of 10,000,000 allowed")
Qubits needed: 48 of 156 available
Executions: 5,000,000 of 10,000,000 allowed
حساب حجم الدالة
تعمل كل مهمة بحجم دالة هو S أو M أو L، وهو يحدد موارد الحوسبة التي تعمل عليها. بالنسبة إلى Rimay، يعتمد الحجم على عدد الصفوف التي تربطها المهمة، من صفوف التدريب والاختبار معًا. إذا طلبت حجمًا أصغر من اللازم، تفشل المهمة بالخطأ 4600. لمعرفة الأحجام وحدودها، راجع أحجام الدوال في دليل Rimay.
تعرّف الخلية التالية حاسبة الحجم. وهي تعمل على جهازك، وتقرأ فقط البيانات التي تمررها إليها، ولا ترسل أي شيء.
from os import PathLike
from typing import Any, Literal, Sequence, Sized

Size = Literal["S", "M", "L"]

# Upper bounds (inclusive) in samples.
_SMALL = 2_999
_MEDIUM = 9_999

FIT_TRANSFORM, TRANSFORM, DELETE = "fit-transform", "transform", "delete"

# Which positions of input_file hold samples, per mode. The labels in
# y_train submit no circuits of their own, so they are not counted.
SAMPLE_POSITIONS = {FIT_TRANSFORM: (0, 2), TRANSFORM: (0,)}

def calculate_function_size(problem: Sequence[Sized], **kwargs: Any) -> Size:
    """Return the size ("S", "M" or "L") required to run the function."""
    metrics = _measure(problem, **kwargs)
    if _is_small(metrics):
        return "S"
    if _is_medium(metrics):
        return "M"
    return "L"

def _measure(problem: Sequence[Sized], **kwargs: Any) -> dict:
    """The samples the job submits."""
    return {"samples": count_samples(problem, kwargs.get("mode"))}

def count_samples(problem: Sequence[Sized], mode: Any) -> int:
    """Rows across the data sets of ``problem`` that carry samples."""
    if mode == DELETE:
        return 0
    if mode not in SAMPLE_POSITIONS:
        raise ValueError(f"cannot size mode {mode!r}")
    if _is_name(problem) or (
        isinstance(problem, (list, tuple))
        and any(_is_name(data) for data in problem)
    ):
        raise TypeError(
            "pass the data, not the file name: read each input_file, e.g. with "
            "pandas.read_csv, and pass the data sets in input_file order"
        )
    if not isinstance(problem, (list, tuple)):
        raise TypeError(
            "pass a list of data sets in input_file order, e.g. [x_train, y_train], "
            f"not a single {type(problem).__name__}"
        )
    return sum(
        len(problem[i]) for i in SAMPLE_POSITIONS[mode] if i < len(problem)
    )

def _is_name(value: Any) -> bool:
    """A file name or path rather than data."""
    return isinstance(value, (str, bytes, PathLike))

def _is_small(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'S'."""
    return metrics["samples"] <= _SMALL

def _is_medium(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'M'."""
    return metrics["samples"] <= _MEDIUM
مرّر مجموعات البيانات بنفس ترتيب الملفات في input_file، مع نمط التشغيل:
size = calculate_function_size(
    [x_train, y_train, x_test], mode="fit-transform"
)
print(size)
S
الخطوة 3: التنفيذ باستخدام Qiskit primitives
شغّل Rimay بنمط fit-transform. فهي تتعلّم ربط ميزات كمّيًا من x_train.csv وy_train.csv، وتطبّقه على مجموعتي التدريب والاختبار. ترتيب الملفات في input_file مهم. اذكر ميزات التدريب، ثم تسميات التدريب، ثم ميزات الاختبار الاختيارية. مرّر الحجم الذي حسبته على أنه function_size.
job = rimay.run(
    mode="fit-transform",
    input_file=[
        "x_train.csv",
        "y_train.csv",
        "x_test.csv",
    ],  # This order matters
    backend_name=backend.name,
    shots=shots,
    function_size=size,
)
print(job.job_id)
de5094df-bb17-4924-9605-d6196a4aa999
مراقبة المهمة
تحقق من حالة المهمة أثناء تشغيلها. يتوقف job.result() وينتظر حتى تنتهي المهمة.
print(job.status())
INITIALIZING
result = job.result()
print(result["output_files"])
['de5094df-bb17-4924-9605-d6196a4aa999_xq_train.csv', 'de5094df-bb17-4924-9605-d6196a4aa999_xq_test.csv']
تحتوي النتيجة على mapping_id، وهو يعرّف الربط الذي تعلّمه هذا التشغيل. لا تحتاج إليه في هذا الدرس، لأن مجموعة الاختبار رُبطت في التشغيل نفسه. احتفظ بهذا المعرّف إذا أردت ربط صفوف جديدة لاحقًا باستخدام mode="transform". وهو الطريقة الوحيدة للوصول إلى الربط المتعلَّم، ودونه عليك تعلّم ربط جديد ودفع تكلفته. يُبنى الربط وفق تخطيط الكيوبتات لهذا المعالج، لذا يجب أن يمرّر تشغيل transform لاحق نفس backend_name.
mapping_id = result["mapping_id"]
الخطوة 4: المعالجة اللاحقة وإرجاع النتيجة بالصيغة الكلاسيكية المطلوبة
تنزيل الميزات المحوّلة كمّيًا
نزّل الملفات التي كتبتها المهمة، باستخدام الأسماء الموجودة في output_files. يبدأ كل اسم بمعرّف المهمة، فتبقى ملفات هذا التشغيل متاحة بعد التشغيلات اللاحقة. مرّر target_name ليُحفظ كل ملف باسمه الخاص.
train_file, test_file = result["output_files"]
for file_name in (train_file, test_file):
    catalog.file_download(file_name, rimay, target_name=file_name)

xq_train = pd.read_csv(train_file).to_numpy()
xq_test = pd.read_csv(test_file).to_numpy()
print(f"Quantum-transformed features: {xq_train.shape[1]}")
586kiB [00:00, 1.13MiB/s]
147kiB [00:00, 336kiB/s]
Quantum-transformed features: 99
التدريب على الميزات المحوّلة كمّيًا
درّب غابة عشوائية على الميزات المحوّلة كمّيًا وحدها.
quantum = train_random_forest(
    xq_train, y_train, n_estimators=900, max_depth=15
)
results["Quantum"] = evaluate(quantum, xq_test, y_test)
التدريب على الميزات الكلاسيكية والكمّية معًا
ضمّ الميزات الأصلية والميزات المحوّلة كمّيًا معًا، ودرّب النموذج نفسه على المجموعة المدمجة.
xh_train = np.hstack([x_train.to_numpy(), xq_train])
xh_test = np.hstack([x_test.to_numpy(), xq_test])

hybrid = train_random_forest(
    xh_train, y_train, n_estimators=900, max_depth=15
)
results["Hybrid"] = evaluate(hybrid, xh_test, y_test)
مقارنة النتائج
قارن النماذج الثلاثة على مجموعة الاختبار.
comparison = pd.DataFrame(results).T
print(comparison.round(3))

comparison[["Accuracy", "AUC", "F1 score"]].T.plot.bar(rot=0, figsize=(8, 4))
plt.ylim(0.5, 1.0)
plt.ylabel("Score on the test set")
plt.title("Random forest on classical, quantum, and hybrid features")
plt.show()
Accuracy    AUC  F1 score  Precision  Recall
Classical     0.765  0.781     0.846      0.782   0.921
Quantum       0.730  0.784     0.827      0.750   0.921
Hybrid        0.730  0.791     0.825      0.756   0.907

يقيس AUC مدى قدرة النموذج على ترتيب الائتمان الجيد فوق السيئ، بغض النظر عن عتبة القرار، مما يجعله أكثر المقاييس إفادة على مجموعة البيانات غير المتوازنة هذه (70% ائتمان جيد). في اختبارات Kipu Quantum المرجعية، حققت الميزات المحوّلة كمّيًا وحدها قيمة AUC مماثلة لخط الأساس الكلاسيكي، وحقق النموذج الهجين الذي يجمع الاثنين أعلى قيمة AUC ودرجة F1. وهكذا تضيف الميزات المحوّلة كمّيًا معلومات لا توفرها الميزات الكلاسيكية وحدها.
التنظيف (اختياري)
يبقى الربط المتعلَّم متاحًا حتى تحذفه. إذا لم تكن تريد ربط مزيد من البيانات به، فاحذفه. لا يتضمن الحذف أي عمل كمّي، ولا يستهلك وقت QPU، ولا يمكن التراجع عنه.
# rimay.run(mode="delete", mapping_id=mapping_id).result()
{'output_files': [],
 'mode': 'delete',
 'deleted': True,
 'mapping_id': 'eUCy4EnZM7G9jYo5b2Pu-TuCXK7zX_wPTT67g9J1dVE',
 'metadata': {'version': '0.6.0', 'resource_usage': {}}}
الخاتمة
ما أنجزته
في هذا الدرس، أنجزت ما يلي:
-
أعددت مجموعة بيانات واقعية لمخاطر الائتمان بسمات فئوية وعددية لاستخلاص الميزات الكمّية.
-
أنشأت خط أساس كلاسيكيًا بالغابة العشوائية.
-
استخدمت Rimay لتعلّم ربط ميزات كمّي على عتاد كمّي، وربطت مجموعتي التدريب والاختبار في تشغيل واحد.
-
درّبت النموذج نفسه على الميزات المحوّلة كمّيًا وعلى الميزات المدمجة، وقارنتها بخط الأساس.
أهم الاستنتاجات
-
تندمج Rimay في خط معالجة تعلّم آلة قائم كخطوة معالجة مسبقة إضافية واحدة. وتحتفظ بإعداد بياناتك ونموذجك الكلاسيكي.
-
عدد الكيوبتات يحدّ من عدد الميزات المدخلة، وعدد الصفوف مضروبًا في
shotsيحدّ من حجم المهمة الواحدة. -
استخدم الميزات المحوّلة كمّيًا مدمجة مع الميزات الأصلية كخيار افتراضي، لأن النموذج يستطيع الاستفادة منهما معًا.
الخطوات التالية
- اقرأ دليل Rimay لتتعرف على كل المدخلات، وتربط بيانات جديدة باستخدام
mode="transform"، وتطّلع على مزيد من الاختبارات المرجعية. - اقرأ كيف طُبّق استخلاص الميزات الكمّي على تصنيف صور الأقمار الصناعية [3].
المراجع
[1] Simen, A., et al. (2025). Digitized Counterdiabatic Quantum Feature Extraction. arXiv preprint arXiv:2510.13807.
[2] Hofmann, H. (1994). Statlog (German Credit Data). OpenML dataset 31.
[3] Zhang, Q., et al. (2026). Quantum-enhanced satellite image classification. arXiv preprint arXiv:2602.18350.