Rimay Quantum Feature Extraction - وظيفة Qiskit Function من Kipu Quantum
راجع مرجع API.
Qiskit Functions ميزة تجريبية متاحة فقط لمستخدمي IBM Quantum® Premium Plan وFlex Plan وOn-Prem (عبر IBM Quantum Platform API) Plan. وهي في مرحلة المعاينة وقابلة للتغيير.
نظرة عامة
يعزز Rimay خطوط تعلّم الآلة الكلاسيكية بميزات مولَّدة على عتاد كمي. تأخذ الوظيفة بيانات جدولية كلاسيكية وتعيد مجموعة من الميزات المحوَّلة كميًا. عندما يعالج نظام كمي البيانات، يولِّد ميزات غنية تلتقط العلاقات غير الخطية بين المدخلات. تقدر تستخدم الميزات المولَّدة وحدها، أو مع ميزاتك الأصلية، لتدريب أي نموذج كلاسيكي. وفي مجموعات البيانات الصغيرة والمتوسطة، قد تحسِّن الميزات المحوَّلة كميًا جودة التنبؤ مقارنةً بالخطوط الأساسية الكلاسيكية البحتة.
بُنيت هذه الوظيفة للمستخدمين التاليين:
-
فرق علوم البيانات التي عندها خط تعلّم آلة قائم على مجموعات بيانات جدولية صغيرة ومتوسطة، وقد توقف فيه تحسن جودة التنبؤ. تضيف Rimay كخطوة معالجة مسبقة إضافية واحدة، بدون ما تبني أي دوائر كمية بنفسك.
-
الباحثون الذين يستكشفون الطرق الكمّية لمهام تعلّم الآلة.
الوصف
تجمع خوارزمية استخراج الميزات الكمّية [1] بين مبدأين من مبادئ تعلّم الآلة الكمّي. الأول هو خرائط الميزات الكمّية، التي تضمّن البيانات في فضاء هيلبرت عالي الأبعاد وبالتالي تنتج تمثيلات أكثر تعبيرًا. والثاني هو الحوسبة الكمّية بالمستودع (quantum reservoir computing)، التي تستخدم ديناميكيات نظام كمّي متعدد الأجسام كتحويل غير خطي للمدخلات.
يرمّز Rimay قيم الميزات والمعلومات المتبادلة بين الميزات في الحقول المحلية ومعاملات الاقتران لهاميلتوني من نوع الزجاج السبيني. تدفع الديناميكيات الكمّية المضادة للاديباتية النظام نحو حالاته منخفضة الطاقة، وهي تحتوي على مزيج غير خطي من الارتباطات في بيانات الإدخال. يستخرج Rimay هذه الارتباطات عن طريق قياس القيم المتوقعة أحادية الجسم وثنائية الجسم. القيم المتوقعة هي الميزات المحوّلة كمّيًا التي تغذّي بها نموذج تعلّم الآلة الخاص بك.
سير العمل
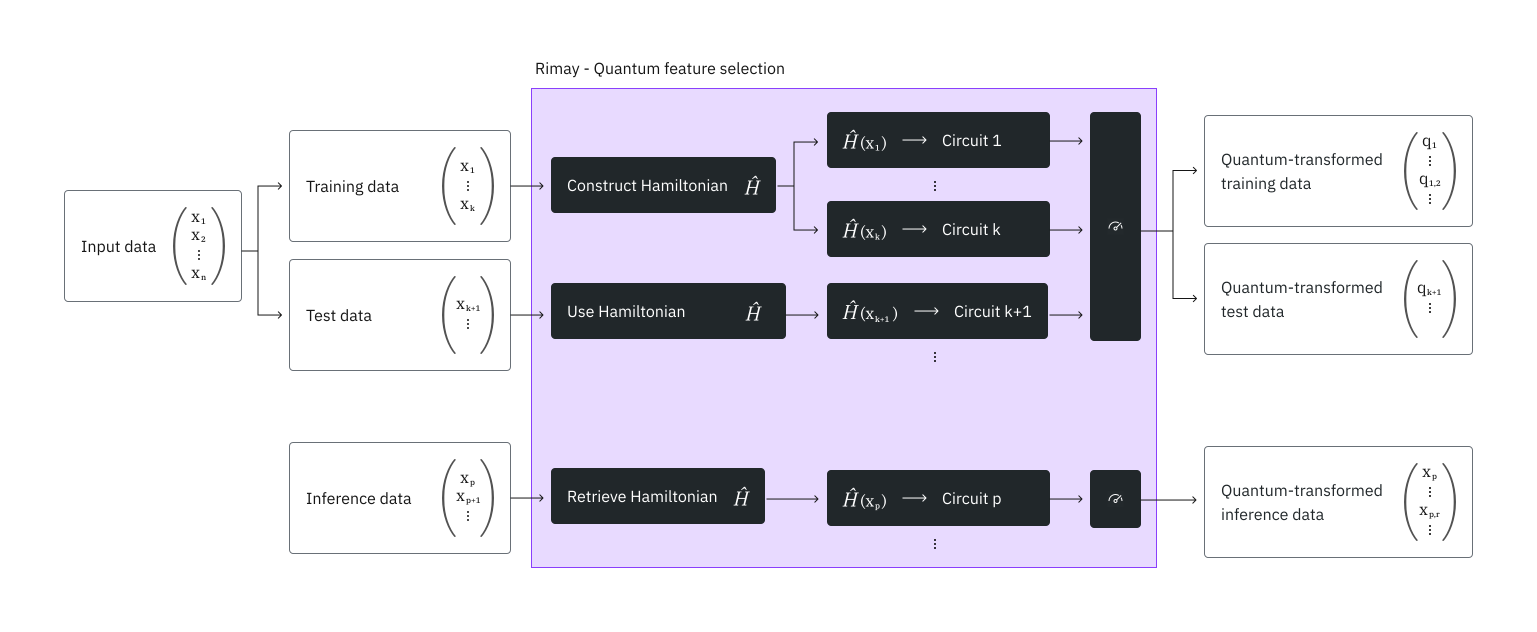
-
عالج بياناتك الجدولية مسبقًا كما تفعل في تعلّم الآلة الكلاسيكي. يحتاج Rimay إلى ميزات رقمية، فحوّل الميزات الفئوية إلى ميزات رقمية، مثلًا باستخدام
OneHotEncoderمن scikit-learn. -
قسّم البيانات إلى مجموعة تدريب ومجموعة اختبار، وارفع الاثنتين إلى الدالة، كما هو موضح في قسم المثال.
-
يستخدم Rimay بيانات التدريب لبناء الهاميلتوني الذي يمثّل البيانات. كل ميزة تقابل كيوبت واحدًا، وتحدد مجموعة التدريب الكاملة أي الميزات، وبالتالي أي الكيوبتات، تتفاعل. يخزّن Rimay هذه البنية ليحوّل بيانات الاختبار وبيانات الاستدلال اللاحقة بنفس الهاميلتوني.
-
لكل عيّنة، تحدد قيم الميزات الحقول المحلية للهاميلتوني، وتحدد المعلومات المتبادلة بين الميزات معاملات الاقتران للبنية من الخطوة 3. يحوّل Rimay التطور المضاد للاديباتي لهذا الهاميلتوني إلى دائرة رقمية، ويشغّل الدوائر على QPU.
-
يقيس Rimay السلاسل الثنائية الناتجة، ثم يحسب القيم المتوقعة أحادية الجسم والقيم المتوقعة ثنائية الجسم للكيوبتات المقترنة فيزيائيًا.
-
تنزّل القيم المتوقعة بصيغة يمكنك تغذية نموذجك بها مباشرة، أو دمجها مع ميزاتك الأصلية.
بسبب هذه البنية، يساوي عدد الكيوبتات التي يحتاجها التشغيل عدد الميزات، ويساوي عدد الدوائر التي يرسلها عدد العيّنات.
بعد أن تلائم تعيينًا، يمكنك تحويل بيانات جديدة من خلاله، مثلًا للاستدلال. عندها يسترجع Rimay الهاميلتوني الذي أنشأه أثناء الملاءمة ويبني منه دوائر العيّنات الجديدة.
دمج Rimay في خط أنابيب تعلّم الآلة الخاص بك
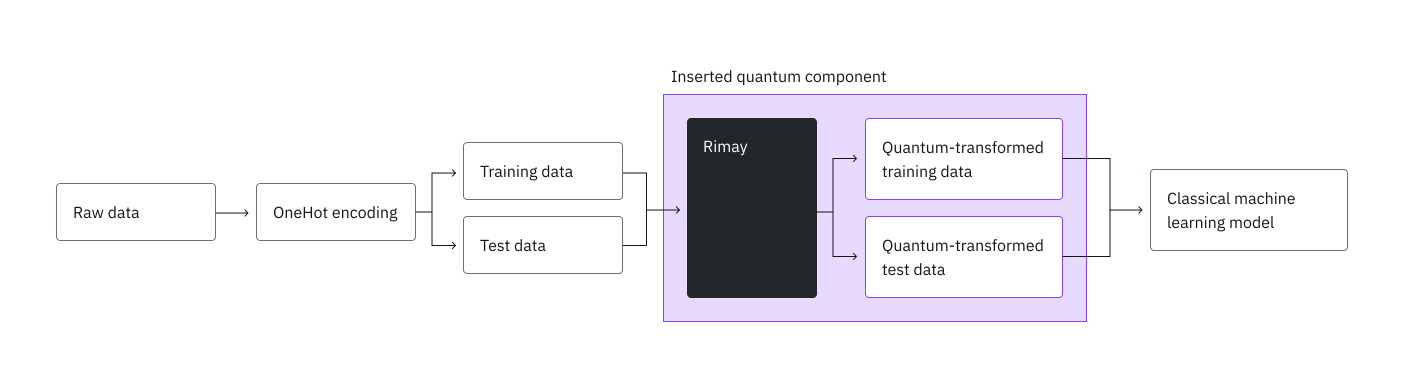
كما في خط الأنابيب الكلاسيكي، تبدأ بمعالجة البيانات الخام مسبقًا، مثلًا بترميز الميزات الفئوية بالترميز الأحادي (one-hot)، وتقسّمها إلى مجموعة تدريب ومجموعة اختبار. بدل تغذية نموذجك بالمجموعتين مباشرة، تغذّي بهما Rimay أولًا، ثم تدرّب نموذجك على الميزات المحوّلة كمّيًا.
المقاييس المرجعية
أجرت Kipu Quantum اختبارًا مرجعيًا لـ Rimay على مجموعة بيانات German credit من OpenML [2]، التي تصنّف 1000 متقدّم للائتمان إلى ذوي مخاطر ائتمانية جيدة أو سيئة. تحتوي على 13 سمة فئوية وسبع سمات رقمية. ينتج عن الترميز الأحادي للسمات الفئوية 48 ميزة رقمية. يستبقي الاختبار 20% من العيّنات كمجموعة اختبار.
كخط أساس، دُرّبت عدة نماذج كلاسيكية على الميزات الكلاسيكية. ومع Rimay، دُرّبت غابة عشوائية بطريقتين: على الميزات المحوّلة كمّيًا وحدها (Random forest Q)، وعلى الميزات المحوّلة كمّيًا مدمجة مع الكلاسيكية (Random forest H، أي الهجينة). يعرض الجدول الغابة العشوائية فقط، لأنها كانت الأفضل أداءً على الميزات المحوّلة كمّيًا.
| Model | Features | Accuracy | AUC | F1 score | Precision | Recall |
|---|---|---|---|---|---|---|
| CatBoost | Classical | 0.775 | 0.781 | 0.850 | 0.795 | 0.914 |
| Random forest | Classical | 0.765 | 0.781 | 0.846 | 0.782 | 0.921 |
| XGBoost | Classical | 0.760 | 0.758 | 0.835 | 0.803 | 0.871 |
| LightGBM | Classical | 0.770 | 0.751 | 0.840 | 0.818 | 0.864 |
| Random forest Q | Quantum | 0.750 | 0.793 | 0.840 | 0.762 | 0.936 |
| Random forest H | Hybrid | 0.770 | 0.798 | 0.854 | 0.770 | 0.957 |
تحسّن الميزات الهجينة كل مقاييس الغابة العشوائية باستثناء الدقة (precision)، وتصل الغابة العشوائية الهجينة إلى AUC وF1 واستدعاء (recall) أعلى من CatBoost على الميزات الكلاسيكية. أكبر تأثير على الاستدعاء، الذي يرتفع من 0.921 إلى 0.957. أما الميزات المحوّلة كمّيًا وحدها فلا تبلغ دقة النماذج الكلاسيكية.
تحتوي مجموعة الاختبار على 200 عيّنة فقط، لذلك فإن التنبؤ الصحيح بعيّنة واحدة إضافية يغيّر الدقة بمقدار 0.005. اقرأ الفروق على أنها اتجاه يحتاج إلى مزيد من التحقق، لا على أنها تأثير معنوي. وقد تعتمد دقة التنبؤ أيضًا على الضوضاء الناتجة عن العتاد في الميزات المستخرجة. لذلك استخدم عددًا كافيًا من اللقطات (shots) بحيث لا تحدّ ضوضاء اللقطات من النتيجة.
استخدم الاختبار المرجعي الموارد التالية:
| Example | Number of qubits | Number of samples | Number of shots | Total time (min) | QPU usage (min) | Processor |
|---|---|---|---|---|---|---|
| German credit | 48 | 1000 | 5000 | 23 | 22 | ibm_boston |
| German credit | 48 | 1000 | 5000 | 3 | 2 | ibm_phoenix |
عدد العيّنات، وهو عدد الدوائر، هو ما يحدد زمن QPU. استخدم نوع المعالج Nighthawk r2، لأنه يقلّل كثيرًا من زمن QPU المطلوب.
المدخلات
يحدد mode المعاملات التي يحتاجها التشغيل. للاطلاع على وصف كل معامل إدخال، راجع مرجع API.
ملفات الإدخال
-
ارفع كل ملف باستخدام
catalog.file_upload()قبل تشغيل الدالة. -
يستبدل الرفع أي ملف سابق يحمل الاسم نفسه، حتى لو كان لمهمة أرسلتها ولم تبدأ بعد. لتشغيل عدة مهام في الوقت نفسه، أعطِ ملفات كل مهمة أسماءها الخاصة، مثل
run1_x_train.csvوrun2_x_train.csv. -
كل ملف هو ملف CSV بصف رأسي. كل عمود في ملف الميزات هو ميزة واحدة، ويجب أن تكون كل قيمة رقمية.
-
يحتوي
y_trainعلى عمود رقمي واحد بالضبط، بتسمية واحدة لكل صف منx_train. حوّل التسميات الفئوية إلى أرقام، مثلًا good وbad إلى 1 و0. -
يجب أن يحتوي
x_testوx_inferenceعلى الأعمدة نفسها الموجودة فيx_train، بالترتيب نفسه.
mapping_id هو السبيل الوحيد للوصول إلى التعيين الذي أنتجته الملاءمة، ولا يمكن البحث عنه أو استرجاعه. وهو يخوّل استخدام ذلك التعيين، لذا تعامل معه كبيانات اعتماد ولا تشاركه. إذا فقدته، فعليك ملاءمة تعيين جديد، وهذا يكلّف تشغيلًا آخر على العتاد الكمّي. سجّل أيضًا backend_name الخاص بالملاءمة، لأن التعيين يعمل على ذلك المعالج فقط.
الحدود
-
كل ميزة تُعيَّن إلى كيوبت واحد، لذا يجب أن يحتوي المعالج على عدد من الكيوبتات لا يقل عن عدد ميزات بياناتك. إذا كانت لديك ميزات أكثر من ذلك، فقلّلها أولًا بتقنية اختيار الميزات.
-
كل عيّنة تصبح دائرة واحدة، ويحسب التشغيل عيّنات التدريب والاختبار معًا. يمكن أن يحتوي التشغيل على 15,000 عيّنة كحد أقصى.
-
يمكن لمهمة واحدة أن تطلب 10 ملايين تنفيذ كحد أقصى، لذا يجب ألا يتجاوز عدد العيّنات مضروبًا في
shots10 ملايين. -
يجب أن تنتهي المهمة خلال 24 ساعة، بما في ذلك الوقت الذي تنتظره دوائرها في طابور المعالج. تُوقَف المهمة التي تستغرق وقتًا أطول دون نتيجة. على معالج مزدحم، أبقِ مجموعات البيانات الكبيرة أقل بكثير من هذه الحدود.
المخرجات
يعيد job.result() قاموسًا. أما الميزات المحوّلة كمّيًا نفسها فتُكتب في ملفات CSV تنزّلها باستخدام catalog.file_download(). للاطلاع على وصف كل مفتاح في القاموس، راجع مرجع API. وللاطلاع على الزمن الذي استغرقته كل مرحلة تنفيذ، راجع بيانات التشغيل الوصفية.
يحتوي كل ملف إخراج على صف واحد لكل صف إدخال، بترتيب ملف الإدخال، وعمود واحد لكل ميزة محوّلة كمّيًا. الأعمدة التي تبدأ أسماؤها بـ corr_ هي القيم المتوقعة ثنائية الجسم. لا تحتوي الملفات على عمود تسميات. تبقى تسميات بيانات التدريب في ملف y_train الخاص بك.
البيانات الوصفية للتشغيل
يحتوي resource_usage على إدخال واحد لكل مرحلة تنفيذ مرّ بها التشغيل: "RUNNING: MAPPING" و"RUNNING: POST_PROCESSING"، وعلى QPU عادةً "RUNNING: WAITING_FOR_QPU". يحتوي كل إدخال على CPU_TIME، وهو الزمن الفعلي للمرحلة بالثواني، وQPU_TIME، وهو زمن QPU بالثواني. على QPU، يُسجَّل زمن QPU الذي فوترته IBM ضمن "RUNNING: MAPPING"، وهي المرحلة التي شُغّلت فيها الدوائر.
"RUNNING: WAITING_FOR_QPU" هو الوقت الذي انتظرته مهامك في طابور IBM. يأخذ التشغيل هذا الوقت من الطوابع الزمنية لمهام IBM، ولا يحتسبه ضمن "RUNNING: MAPPING". إذا لم تبلّغ IBM عن تلك الطوابع الزمنية لكل مهمة، يغيب هذا الإدخال، ويكون الانتظار جزءًا من "RUNNING: MAPPING".
تنهي IBM® حساب الاستخدام بعد انتهاء المهمة بفترة. ينتظر التشغيل حتى نحو دقيقة لذلك. الاستخدام الذي لا يزال قيد الحساب بعد هذه المدة لا يُدرج في QPU_TIME، ويظهر الاستخدام النهائي على IBM Quantum Platform. إذا تعذّر على التشغيل قراءة الاستخدام من IBM، تكون قيمة QPU_TIME هي None.
على سبيل المثال:
"metadata": {
    "version": "0.3.0",
    "resource_usage": {
        "RUNNING: MAPPING": {"CPU_TIME": 12.4, "QPU_TIME": 6.0},
        "RUNNING: WAITING_FOR_QPU": {"CPU_TIME": 28.8, "QPU_TIME": 0.0},
        "RUNNING: POST_PROCESSING": {"CPU_TIME": 0.3, "QPU_TIME": 0.0},
    },
}
البدء
صادق باستخدام مفتاح API الخاص بك في IBM Quantum Platform، واختر دالة Qiskit كما يلي:
يفترض الكود التالي أنك حفظت بيانات اعتمادك. وإذا لم تفعل، فاتبع التعليمات في تثبيت عميل Qiskit Functions Catalog لحفظ حسابك بمفتاح API الخاص بك.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"pandas": "pandas", "qiskit_ibm_catalog": "qiskit-ibm-catalog"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit_ibm_catalog import QiskitFunctionsCatalog

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# Verify that you have access to the function
catalog.list()
[QiskitFunction(kipu-quantum/rimay)]
# Access function
rimay = catalog.load("kipu-quantum/rimay")
أحجام الدالة
تعمل كل مهمة بحجم واحد: S أو M أو L. إذا كان الحجم المحدد أصغر مما يلزم، تُرفض المهمة. وإذا كان الحجم أكبر مما يلزم، تعمل المهمة على ملف حوسبة أكبر مما يتطلبه العمل.
يعتمد حجم مهمة Rimay على عدد العيّنات التي تعيّنها: صفوف x_train وx_test في fit-transform، وصفوف x_inference في transform. لا تُحتسب التسميات في y_train، ولا يعيّن تشغيل delete أي عيّنات.
| Size | Samples per job | Compute profile | vCPU | RAM |
|---|---|---|---|---|
S | Up to 2,999 | 8x32 | 8 | 32 GB |
M | 3,000 to 9,999 | 8x32 | 8 | 32 GB |
L | 10,000 to 15,000 | 16x128 | 16 | 128 GB |
عدد العيّنات هو المعيار الوحيد. لا يغيّر الحجم شيئًا سوى ملف الحوسبة: الحدود على الميزات والعيّنات واللقطات هي نفسها لكل الأحجام. يعمل S وM على ملف الحوسبة نفسه ويختلفان في عدد العيّنات التي يغطيها كل منهما.
الافتراضي هو M، ويُستخدم عندما لا تطلب المهمة حجمًا. لذلك يجب على المهمة التي تزيد على 9,999 عيّنة أن تطلب L.
يمكنك أيضًا قراءة التعيين من الدالة نفسها باستخدام rimay.sizes_map، وقراءة الحجم الذي تعمل به المهمة عندما لا تطلب حجمًا باستخدام rimay.default_size.
احسب الحجم قبل الإرسال
شغّل هذا على مدخلاتك. فهو يقرؤها ولا يفعل شيئًا غير ذلك: لا تُرسل أي مهمة ولا يُحجز أي شيء، لذا يمكنك استدعاؤه بقدر ما تشاء.
مرّر مجموعات البيانات نفسها، لا أسماء ملفاتها، بالترتيب نفسه الموجود في input_file، مع mode الخاص بالتشغيل. توضّح الخطوة 2 من المثال الاستدعاء.
from os import PathLike
from typing import Any, Literal, Sequence, Sized

Size = Literal["S", "M", "L"]

# Upper bounds (inclusive) in samples.
_SMALL = 2_999
_MEDIUM = 9_999

FIT_TRANSFORM, TRANSFORM, DELETE = "fit-transform", "transform", "delete"

# Which positions of input_file hold samples, per mode. The labels in
# y_train submit no circuits of their own, so they are not counted.
SAMPLE_POSITIONS = {FIT_TRANSFORM: (0, 2), TRANSFORM: (0,)}

def calculate_function_size(problem: Sequence[Sized], **kwargs: Any) -> Size:
    """Return the size ("S", "M" or "L") required to run the function."""
    metrics = _measure(problem, **kwargs)
    if _is_small(metrics):
        return "S"
    if _is_medium(metrics):
        return "M"
    return "L"

def _measure(problem: Sequence[Sized], **kwargs: Any) -> dict:
    """The samples the job submits."""
    return {"samples": count_samples(problem, kwargs.get("mode"))}

def count_samples(problem: Sequence[Sized], mode: Any) -> int:
    """Rows across the data sets of ``problem`` that carry samples."""
    if mode == DELETE:
        return 0
    if mode not in SAMPLE_POSITIONS:
        raise ValueError(f"cannot size mode {mode!r}")
    if _is_name(problem) or (
        isinstance(problem, (list, tuple))
        and any(_is_name(data) for data in problem)
    ):
        raise TypeError(
            "pass the data, not the file name: read each input_file, e.g. with "
            "pandas.read_csv, and pass the data sets in input_file order"
        )
    if not isinstance(problem, (list, tuple)):
        raise TypeError(
            "pass a list of data sets in input_file order, e.g. [x_train, y_train], "
            f"not a single {type(problem).__name__}"
        )
    return sum(
        len(problem[i]) for i in SAMPLE_POSITIONS[mode] if i < len(problem)
    )

def _is_name(value: Any) -> bool:
    """A file name or path rather than data."""
    return isinstance(value, (str, bytes, PathLike))

def _is_small(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'S'."""
    return metrics["samples"] <= _SMALL

def _is_medium(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'M'."""
    return metrics["samples"] <= _MEDIUM
إذا كان الحجم أصغر مما يلزم، تفشل المهمة بالخطأ 4600 وتذكر الرسالة الحجم الذي يجب استخدامه بدلًا منه. وإذا كان أكبر مما يلزم، تعمل المهمة بشكل طبيعي وتسجّل حدثًا استشاريًا 4601.
المثال
يوضّح هذا المثال كيفية رفع البيانات وتشغيل الدالة واسترجاع الميزات المحوّلة كمّيًا. لمثال شامل يتضمن المعالجة المسبقة وتدريب النموذج الكلاسيكي، راجع الدرس التعليمي.
1. رفع البيانات
يستخدم هذا المثال مجموعة بيانات اصطناعية صغيرة بأربع ميزات رقمية وتسمية ثنائية، بحيث يحتاج التشغيل إلى أربعة كيوبتات فقط وينتهي بسرعة. تكتبها الخلية التالية في أربعة ملفات CSV: ميزات التدريب، وتسميات التدريب، وميزات الاختبار، وميزات الخطوة 4 من هذا المثال. لاستخدام بياناتك الخاصة، اكتب مجموعتَي التدريب والاختبار المعالجتين مسبقًا في ملفات بالتخطيط نفسه بدلًا من ذلك.
from pathlib import Path

Path("x_train.csv").write_text("""f0,f1,f2,f3
0.7227,1.3355,1.9595,2.5562
0.2731,0.5779,0.8983,1.1624
0.1139,0.1817,0.2163,0.2426
0.0341,0.1311,0.0854,0.09
0.8996,1.6951,2.497,3.3407
0.9669,1.8906,2.7705,3.6569
0.6366,1.2821,1.8793,2.4602
0.7718,1.4979,2.2223,2.933
0.5465,1.1008,1.67,2.2195
0.9475,1.9423,2.8942,3.8199
0.8829,1.6842,2.4703,3.2865
0.0675,0.0365,0.0705,0.0162
""")
Path("y_train.csv").write_text("label\n1\n0\n0\n0\n1\n1\n0\n1\n0\n1\n1\n0\n")
Path("x_test.csv").write_text("""f0,f1,f2,f3
0.543,1.0786,1.5684,2.0607
0.9928,1.9037,2.9302,3.8422
0.2269,0.3637,0.4628,0.597
0.9896,1.9511,2.8913,3.8208
""")
Path("x_inference.csv").write_text("""f0,f1,f2,f3
0.2708,0.542,0.8506,1.0897
0.3585,0.6025,0.9517,1.2609
0.8871,1.6559,2.4577,3.2992
""")
95
ارفع ملفات التدريب والاختبار. سترفع x_inference.csv في الخطوة 4.
for file_name in ("x_train.csv", "y_train.csv", "x_test.csv"):
    catalog.file_upload(file_name, rimay)
2. تشغيل الدالة
احسب حجم التشغيل من البيانات التي رفعتها، باستخدام الحاسبة من أحجام الدالة.
import pandas as pd

x_train = pd.read_csv("x_train.csv")
y_train = pd.read_csv("y_train.csv")
x_test = pd.read_csv("x_test.csv")

size = calculate_function_size(
    [x_train, y_train, x_test], mode="fit-transform"
)
print(size)
S
اختر معالجًا يحتوي على عدد من الكيوبتات لا يقل عن عدد ميزات بياناتك، وشغّل الدالة في وضع fit-transform بذلك الحجم. تحتوي بيانات العيّنة على أربع ميزات، لذا يمكن لأي معالج IBM Quantum تشغيلها.
backend = catalog.least_busy(operational=True, simulator=False)

job = rimay.run(
    mode="fit-transform",
    input_file=["x_train.csv", "y_train.csv", "x_test.csv"],
    backend_name=backend.name,
    shots=5000,
    function_size=size,
)
print(job.job_id)
85dabc9f-a769-4f4a-8e92-f3be73f85ca2
تحقق من حالة عبء العمل أو أعد النتائج كما يلي:
# Monitor the job status
job.status()
'DONE'
result = job.result()

# Keep both: the mapping_id is the only handle on the mapping this run
# fitted, and the mapping runs only on the processor it was fitted on.
mapping_id = result["mapping_id"]
fit_backend_name = result["backend_name"]
3. استرجاع النتائج
نزّل الميزات المحوّلة كمّيًا. مرّر target_name ليُحفظ كل ملف باسمه الخاص.
for file_name in result["output_files"]:
    catalog.file_download(file_name, rimay, target_name=file_name)
693iB [00:00, 171kiB/s]
254iB [00:00, 111kiB/s]
4. تحويل بيانات جديدة
بعد تدريب نموذجك، حوّل البيانات الجديدة بالتعيين الذي تمت ملاءمته، مثلًا لإجراء الاستدلال. يحوّل هذا المثال x_inference.csv، الذي كتبته الخلية الأولى من هذا المثال. مرّر mapping_id الذي أعادته الملاءمة، حتى تُعيَّن الصفوف الجديدة بالتعيين نفسه بدلًا من تعيين جديد.
يُبنى التعيين لتخطيط كيوبتات معالج واحد، لذا مرّر backend_name نفسه الذي استخدمته الملاءمة، والذي أعادته الملاءمة في result["backend_name"]. لا تستخدم least_busy() لاختيار المعالج، لأنه قد يعيد معالجًا مختلفًا. يرفض Rimay أي معالج آخر قبل أن يرسل أي شيء. كما يأتي عدد اللقطات من الملاءمة.
catalog.file_upload("x_inference.csv", rimay)

x_inference = pd.read_csv("x_inference.csv")
size = calculate_function_size([x_inference], mode="transform")

job = rimay.run(
    mode="transform",
    input_file=["x_inference.csv"],
    # The processor the mapping was fitted on
    backend_name=fit_backend_name,
    shots=5000,
    mapping_id=mapping_id,
    function_size=size,
)
# Monitor the job status
job.status()
'DONE'
result = job.result()

for file_name in result["output_files"]:
    catalog.file_download(file_name, rimay, target_name=file_name)
202iB [00:00, 73.5kiB/s]
5. حذف تعيين
عندما لا تعود بحاجة إلى تعيين تمت ملاءمته، احذفه. لا يؤدي تشغيل delete أي عمل كمّي، لذا لا يحتاج إلى معالج ولا إلى لقطات ولا إلى حجم للدالة. لا يمكنك التراجع عن الحذف. بعد الحذف، لا يشير mapping_id إلى أي شيء، ويفشل تشغيل transform به.
job = rimay.run(mode="delete", mapping_id=mapping_id)
job.result()
{'output_files': [],
 'mode': 'delete',
 'deleted': True,
 'mapping_id': '30L40joyUPYfnvgwo2d7MXXSzqvHkggR-Kzn81wfIYw',
 'metadata': {'version': '0.6.0', 'resource_usage': {}}}
جلب رسائل الخطأ
إذا كانت حالة عبء العمل ERROR، فاستخدم job.error_message() لجلب رسالة الخطأ، كما يلي:
job = rimay.run(
    mode="fit-transform",
    input_file=["x_train.csv", "y_train.csv"],
    backend_name=backend.name,
    shots=0,
)
job.error_message()
يحمل كل خطأ يبلّغ عنه Rimay رمزًا من رموز أخطاء IBM Quantum، ورسالة، وحلًّا يذكر القيمة التي مرّرتها والقيمة المسموح بها. يسرد الجدول التالي أكثر الأخطاء شيوعًا:
| Code | Cause |
|---|---|
1221 | A parameter is missing or has the wrong type, mode is not valid, a file named in input_file was not uploaded, the files do not match each other, a feature is not numeric, or the mapping_id does not match a stored mapping. |
1221 | A "transform" run names a different backend_name than the fit that produced its mapping. |
1216 | Your instance has no processor with the backend_name that you passed. The solution lists the processors it does have. |
1200 | Your API key does not have access to the instance that the job runs under. |
3200 | backend_name does not start with ibm_. |
4500 | The data has more features than the processor has qubits. |
6000 | The number of samples times shots exceeds 10 million executions. |
6001 | shots is smaller than 1. |
6002 | The data has more samples than a run allows. |
حالات الاستخدام
في التصنيف الجدولي على مجموعات بيانات صغيرة ومتوسطة الحجم، طبّقت Kipu Quantum استخراج الميزات الكمّية على ما يلي:
بعيدًا عن البيانات الجدولية، يمكن للشبكات العصبية المجمّدة تحويل الصور إلى ميزات رقمية، ثم يحوّلها استخراج الميزات الكمّية إلى ميزات محوّلة كمّيًا:
الحصول على الدعم
للحصول على الدعم، تواصل مع support@kipu-quantum.com.
الخطوات التالية
-
زر مرجع API الخاص بدالة Qiskit هذه.
-
جرّب الدرس التعليمي تصنيف المخاطر الائتمانية باستخدام استخراج الميزات الكمّية Rimay من Kipu Quantum.
المراجع
[1] Simen, A., et al. (2025). Digitized Counterdiabatic Quantum Feature Extraction. arXiv preprint arXiv:2510.13807.
[2] Hofmann, H. (1994). Statlog (German Credit Data). OpenML dataset 31.
[3] Zhang, Q., et al. (2026). Quantum-enhanced satellite image classification. arXiv preprint arXiv:2602.18350.
معلومات إضافية
Rimay كلمة من لغة الكيتشوا تعني "يشرح".