تحديث خصائص الخلفية باستخدام قياس أداء في الوقت الحقيقي
تقدير الاستخدام: 3 دقائق على ibm_kingston (ملاحظة: هذا مجرد تقدير. قد يختلف وقت التشغيل لديك.)
مخرجات التعلم
-
لماذا يمكن أن تتأخر الخصائص المُبلَّغ عنها بواسطة QPU عن السلوك الحالي للجهاز، ومتى يستحق الأمر إعادة قياسها بنفسك
-
ما الذي تقيسه كل من تجارب التوصيف القياسية الخمس (القراءة، وقياس الأداء العشوائي لكيوبت واحد، وقياس الأداء العشوائي الطبقي لكيوبتين، و، و)
-
كيفية تشغيل حزمة التوصيف الكاملة في استدعاء واحد أو خطوة بخطوة، والحصول على كائن خلفية بخصائص محدّثة
-
كيفية مقارنة الخصائص المقيسة بالخصائص المُبلَّغ عنها، ولماذا تعكس بعض الاختلافات منهجية القياس وليس انحراف الجهاز
المتطلبات الأساسية
-
سير عمل أنماط Qiskit
-
أوضاع تنفيذ Qiskit Runtime، وخاصة batch mode
-
كيفية استكشاف معلومات QPU، مثل خصائص الخلفية وبيانات المعايرة
الخلفية
كل QPU من IBM Quantum® يُبلغ عن مجموعة من الخصائص التي تصف مدى جودة عمل كل كيوبت من كيوبتاته حالياً: أزمنة الاسترخاء ()، وأزمنة التماسك ()، وأخطاء القراءة، وأخطاء البوابات الأحادية والثنائية الكيوبت. هذه الأرقام مهمة عملياً. يستخدمها المحوّل البرمجي لتحديد الكيوبتات الفيزيائية التي يجب أن تعمل عليها دارتك، وتعتمد عليها تقنيات تخفيف الأخطاء، وقد تستخدمها للحكم على ما إذا كان الجهاز يعمل بشكل جيد بما يكفي لتجربة ما.
تأتي الخصائص المُبلَّغ عنها من إجراءات معايرة تُجرى عادة مرة واحدة يومياً تقريباً. ومع ذلك، يمكن للكيوبتات فائقة التوصيل أن تنحرف على مقاييس زمنية أقصر، ويمكن للعيوب العابرة (ما يسمى بالأنظمة ثنائية المستوى) أن تُضعف مؤقتاً كيوبتاً بدا ممتازاً وقت المعايرة. إضافة إلى ذلك، غالباً ما تُحوَّل المهمة برمجياً (transpile) قبل تنفيذها الفعلي بوقت طويل، لذا يمكن أن تعتمد القرارات المبنية على الخصائص المُبلَّغ عنها على معلومات قديمة. يُظهر الدرس قياس الأداء في الوقت الحقيقي لاختيار الكيوبتات مدى تذبذب هذه الخصائص من يوم لآخر، ويبني سير عمل توصيف كامل يدوياً من تجارب Qiskit الفردية.
يُظهر هذا الدرس النسخة المبسطة من ذلك السير، باستخدام أداة BackendCharacterization من Qiskit Device Benchmarking، التي تُجمّع بناء التجربة وتقديم المهام وملاءمة المنحنيات في بضع استدعاءات. تُنفق حوالي 70 ثانية من وقت QPU وتحصل في المقابل على كائن خلفية تعكس خصائصه حالة الجهاز الآن، جاهز للمقارنة مع القيم المُبلَّغ عنها أو تمريره إلى أدوات لاحقة.
تجارب التوصيف
تقيس الحزمة خمس خصائص، كل واحدة بتجربة قياسية:
-
خطأ القراءة (
readout): يُحضّر كل كيوبت في الحالة أو ويُقاس فوراً. احتمال قراءة الحالة الخاطئة يعطي خطأ تحضير الحالة والقياس (SPAM). -
خطأ البوابة الأحادية الكيوبت (
rb_1q): يُشغّل قياس الأداء العشوائي (RB) تسلسلات من بوابات كليفورد الأحادية العشوائية التي تتألف مثالياً في الهوية. الطريقة التي يتناقص بها احتمال البقاء مع طول التسلسل تعطي متوسط الخطأ لكل بوابة، بغض النظر عن أخطاء SPAM. -
خطأ البوابة الثنائية الكيوبت (
rb_2q): نفس فكرة RB مُطبّقة على طبقات كاملة من بوابات ثنائية الكيوبت غير المتداخلة المُنفَّذة في آن واحد، كما في تجربة دقة الطبقة. ولأن العديد من البوابات تعمل في آن واحد، تتضمن معدلات الخطأ الناتجة تأثيرات التداخل المتبادل وتكون أقرب إلى ما تختبره دارة عميقة فعلياً. -
(
t1): يُثار كل كيوبت ويُقاس بعد تأخيرات متزايدة. اضمحلال عدد سكان الحالة المثارة يعطي زمن الاسترخاء. -
(
t2): تضع تجربة صدى هان كل كيوبت في تراكب، وتطبق نبضة صدى في منتصف التأخير، وتقيس مدى سرعة فقدان تماسك الطور. افتراضياً يُستخدم صدى واحد؛ ويُعرض في نهاية هذا الدرس بديل متعدد الأصداء (على طراز CPMG).
ما الذي يفعله التحديث وما لا يفعله
ضع ثلاث نقاط في اعتبارك عند استخدام سير العمل هذا:
-
تعيش الخصائص المحدّثة فقط في كائن الخلفية المُعاد إليك. لا يتغير شيء على الجهاز نفسه أو في بيانات المعايرة التي تُبلغ عنها IBM Quantum لمستخدمين آخرين.
-
القيم المقيسة هي لقطة أُخذت بمنهجية معينة. بعضها، وخاصة أخطاء البوابة الثنائية الكيوبت الطبقية وقيم ذات الصدى الواحد الموازية، تُقاس بشكل مختلف عن بيانات المعايرة المُبلَّغ عنها، لذا فإن جزءاً من أي فجوة تلاحظها منهجي وليس انحرافاً. يشير هذا الدرس إلى حيثما يحدث ذلك.
-
يكلف التوصيف نفسه وقت QPU (حوالي 70 ثانية للحزمة الكاملة على معالج Heron r2)، وهو ثمن الحصول على معلومات محدّثة.
يتبع سير العمل الخطوات الأربع لنمط Qiskit:
-
الخطوة 1: تحويل المدخلات الكلاسيكية إلى مسألة كمومية. اختر الجهاز ومجموعة الخصائص المراد قياسها.
-
الخطوة 2: تحسين المسألة للتنفيذ على العتاد الكمي. تبني الأداة دارات التجربة مباشرة بالبوابات الأصلية للجهاز وتوازيها عبر الشريحة.
-
الخطوة 3: التنفيذ باستخدام بدائيات Qiskit. تعمل التجارب كمهام Sampler داخل دفعة.
-
الخطوة 4: معالجة النتائج وإعادتها بالتنسيق الكلاسيكي المطلوب. ملاءمة بيانات القياس في خرائط أخطاء لكل كيوبت، وتحديث الخلفية، ومقارنة الخصائص المقيسة بالخصائص المُبلَّغ عنها.
المتطلبات
قبل بدء هذا الدرس، تأكد من تثبيت ما يلي:
-
حزمة تطوير برمجيات Qiskit SDK v2.0 أو أحدث، مع دعم التصور
-
Qiskit Runtime v0.40 أو أحدث (
pip install qiskit-ibm-runtime) -
Qiskit Device Benchmarking، التي تُثبّت أيضاً Qiskit Experiments (
pip install git+https://github.com/qiskit-community/qiskit-device-benchmarking.git)
الإعداد
استورد المكتبات المطلوبة.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"numpy": "numpy", "qiskit_device_benchmarking": "git+https://github.com/qiskit-community/qiskit-device-benchmarking.git", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import logging
import sys

import numpy as np
from qiskit_ibm_runtime import Batch, QiskitRuntimeService

from qiskit_device_benchmarking.utilities.characterization_utils import (
    BackendCharacterization,
    plot_characterization_comparison,
)
تبني حزمة التوصيف عدة تجارب، وتقدم مهاماً متعددة، وتلائم النتائج، مما قد يستغرق دقيقتين تقريباً في المجموع. فعّل التسجيل بمستوى INFO حتى تطبع كل مرحلة تقدمها أثناء حدوثه.
logger = logging.getLogger("qiskit_device_benchmarking")
logger.setLevel(logging.INFO)
logger.addHandler(logging.StreamHandler(stream=sys.stdout))
مثال محاكي صغير النطاق
لا يتضمن هذا الدرس مثالاً بمحاكي. يقيس سير العمل العيوب الفيزيائية لجهاز معين: مدى سرعة استرخاء كيوبتاته وفقدانها للطور، ومدى تكرار فشل بواباته وقراءته. المحاكي المثالي لا يحتوي على أي من هذه العيوب، فلا يوجد شيء لتوصيفه. يمكنك إرفاق نموذج ضوضاء اصطناعي بخلفية وهمية، لكن التجارب حينها ستستعيد فقط الأرقام التي أدخلتها بنفسك. لهذا السبب، ننتقل مباشرة إلى العتاد، مقسّماً إلى الخطوات الأربع لنمط Qiskit.
مثال عتاد على نطاق واسع
الخطوة 1: تحويل المدخلات الكلاسيكية إلى مسألة كمومية
في سير العمل هذا، تكون "المشكلة" هي الجهاز نفسه: المدخلات الكلاسيكية هي QPU الذي تريد وصف خصائصه وقائمة الخصائص المراد قياسها، والتجارب الكمومية هي دارات التوصيف المولدة منها.
أولاً، اختر Backend. يستخدم هذا البرنامج التعليمي ibm_kingston، وهو معالج Heron r2 بسعة 156 Qubit؛ يمكنك استبداله بأي جهاز IBM Quantum لديك صلاحية الوصول إليه (أو اختيار واحد باستخدام service.least_busy()).
service = QiskitRuntimeService()
device = "ibm_kingston"
backend = service.backend(device)
بعد ذلك، اختر الخصائص المراد قياسها. يمكنك تمرير أي مجموعة فرعية من التجارب التالية:
-
readout: تجربة SPAM (تحضير الحالة والقياس) -
rb_1q: قياس الأداء العشوائي المعزول لـ Qubit واحد -
rb_2q: قياس الأداء العشوائي المتزامن لكيوبتين من تجربة دقة الطبقة (layer fidelity) -
t2: تجربة صدى هان (Hahn echo) لـ (صدى واحد افتراضيًا) -
t1: تجربة استرخاء
شغّل المجموعة الكاملة للحصول على صورة شاملة عن الجهاز؛ احذف عناصر من القائمة إذا كنت تهتم ببعض الخصائص فقط وتريد توفير وقت QPU.
experiments = ["readout", "rb_1q", "rb_2q", "t1", "t2"]
الخطوة 2: تحسين المشكلة للتنفيذ على العتاد الكمومي
في معظم البرامج التعليمية، هذه هي المرحلة التي تقوم فيها بترجمة (transpile) دارتك. هنا، تتولى BackendCharacterization هذه المهمة داخليًا. فهي تبني دارات التجربة مباشرة باستخدام Gates الأصلية للجهاز، وتشغّل تجارب Qubit المفرد على جميع الـ Qubits بالتوازي، وتجدول قياس أداء Qubit الثنائي عبر طبقات منفصلة من خريطة الاقتران (coupling map) بحيث يُغطى الجهاز بأكمله بعدد قليل من المهام. بفضل هذا التوازي، تستهلك المجموعة بأكملها حوالي 70 ثانية فقط من وقت QPU.
قم بتهيئة الفئة (class) التي تدير سير العمل:
# Initialize the class used to run the experiments
characterizer = BackendCharacterization(backend)
الخطوة 3: التنفيذ باستخدام Qiskit primitives
تبني الطريقة run_experiments الدارات وترسلها كمهام Sampler. شغّلها داخل سياق Batch بحيث تُجدول المهام معًا على QPU، وتعود الطريقة بمجرد إرسال جميع المهام. (يمكنك أيضًا تشغيلها خارج batch، أو داخل Session.)
قد ترى تحذيرًا حول تمرير Backend أثناء فتح مدير سياق الـ Session. هذا متوقع ويمكن تجاهله بأمان.
# Run the characterization experiments inside a Batch
with Batch(backend=backend):
    jobs = characterizer.run_experiments(experiments=experiments)
base_primitive.get_mode_service_backend:WARNING:2026-07-14 14:23:02,051: A backend was passed in as the mode but a session context manager is open so this job will run inside this session/batch instead of in job mode.
Building readout experiments
Building 1Q RB experiments
Building 2Q RB experiments
Building T1 experiments
Building T2 experiments
Layered two-qubit RB submitted: ['d9b7tfu6hjac73ffba2g', 'd9b7tjug26ic73dfju3g', 'd9b7u3u6hjac73ffban0', 'd9b7u7rv6alc73csmicg']
Readout job submitted: d9b7u8bv6alc73csmidg
T1 experiment submitted: ['d9b7u8ug26ic73dfjuqg']
T2 (Hahn) experiment submitted: ['d9b7u9fu62qs738othg0']
Single-qubit RB submitted: ['d9b7v8m6hjac73ffbc40', 'd9b7veeg26ic73dfk040']
تُعيد الطريقة المهام المرسلة كقاموس (dictionary) مفتاحه اسم التجربة، وهو أمر مفيد لتتبعها على لوحة تحكم IBM Quantum Platform أو لتصحيح الأخطاء.
# Print all the job IDs for debugging purposes
jobs
{'rb_2q': [<RuntimeJobV2('d9b7tfu6hjac73ffba2g', 'sampler')>,
  <RuntimeJobV2('d9b7tjug26ic73dfju3g', 'sampler')>,
  <RuntimeJobV2('d9b7u3u6hjac73ffban0', 'sampler')>,
  <RuntimeJobV2('d9b7u7rv6alc73csmicg', 'sampler')>],
 'readout': [<RuntimeJobV2('d9b7u8bv6alc73csmidg', 'sampler')>],
 't1': [<RuntimeJobV2('d9b7u8ug26ic73dfjuqg', 'sampler')>],
 't2': [<RuntimeJobV2('d9b7u9fu62qs738othg0', 'sampler')>],
 'rb_1q': [<RuntimeJobV2('d9b7v8m6hjac73ffbc40', 'sampler')>,
  <RuntimeJobV2('d9b7veeg26ic73dfk040', 'sampler')>]}
الخطوة 4: المعالجة اللاحقة وإعادة النتيجة بالصيغة الكلاسيكية المطلوبة
تحليل النتائج
تنتظر الطريقة analyze_results انتهاء المهام وتلائم بيانات القياس: الانحلالات الأسية لـ و ، وانحلالات احتمالية البقاء لتجارب RB، ومصفوفات التخصيص (assignment matrices) للقراءة (readout). وتُعيد قاموسًا من خرائط الأخطاء، إدخال واحد لكل خاصية مقاسة، يربط كل منها Qubit (أو زوج Qubit) بقيمته المقاسة.
error_maps = characterizer.analyze_results()
print(f"The following error maps are available: {list(error_maps.keys())}")
readout_q0 = error_maps["readout_error"][0]
print(f"For example, readout error for qubit 0 is {readout_q0}")
The following error maps are available: ['readout_error', 'oneq_error_x', 'oneq_error_sx', 'lf_error_map', 't1_map', 't2_map']
For example, readout error for qubit 0 is 0.007600000000000051
تغطي الخرائط خطأ القراءة، وأخطاء Gate الأحادي x و sx، وأخطاء Qubit الثنائي الطبقية (lf_error_map، من تجربة إخلاص الطبقة)، وأزمنة و بالثواني.
تحديث خصائص Backend
تكتب الطريقة update_backend القيم المقاسة في خصائص نسخة من Backend وتُعيدها. يحتفظ الكائن الأصلي backend ببيانات المعايرة المُبلَّغ عنها، حتى نتمكن من مقارنة الاثنين، كما هو موضح أدناه. تذكر أن هذا التحديث محلي تمامًا لجلسة Python الخاصة بك؛ فهو لا يغير أي شيء على الجهاز أو بالنسبة للمستخدمين الآخرين.
backend_updated = characterizer.update_backend()
Updating readout error
Updating single-qubit X error
Updating single-qubit SX error
Updating two-qubit error
Updating T1
Updating T2
مقارنة الخصائص المقاسة بالخصائص المُبلَّغ عنها
أخيرًا، ارسم الخصائص المقاسة في الوقت الفعلي مقابل القيم التي يُبلّغ عنها Backend. في كل لوحة، تُرتب الـ Qubits (أو أزواج Qubit) حسب القيمة المقاسة، لذا يكون المنحنى المقاس سلسًا بحكم البناء، ويُظهر تشتت القيم المُبلَّغ عنها حوله أين يختلف الاثنان. يُعرض مخطط واحد فقط لـ RB الأحادي لأن نفس الخطأ المقاس لكل Gate يُنسب إلى كل من Gate x و sx. تُختار حدود المحور من الجزء الأكبر من البيانات بحيث لا تؤدي بعض القيم الشاذة المتطرفة إلى ضغط المخططات؛ وتُحصى أي نقاط خارج النطاق في تعليق توضيحي على المخطط (أو مرر ylim لتجاوز الحدود).
plot_characterization_comparison(
    old_props=backend.properties().to_dict(),
    new_props=backend_updated.properties().to_dict(),
    plots=["readout", "rb_1q", "rb_2q", "t1", "t2"],
)
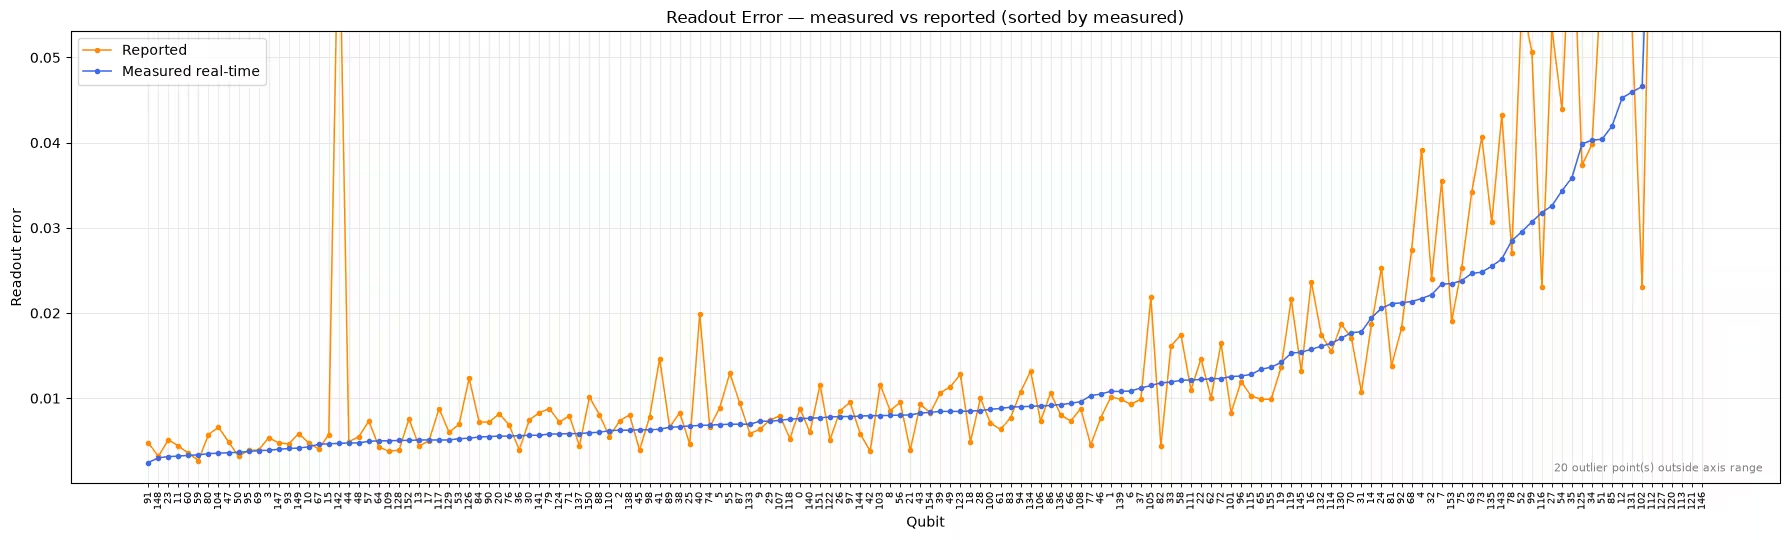
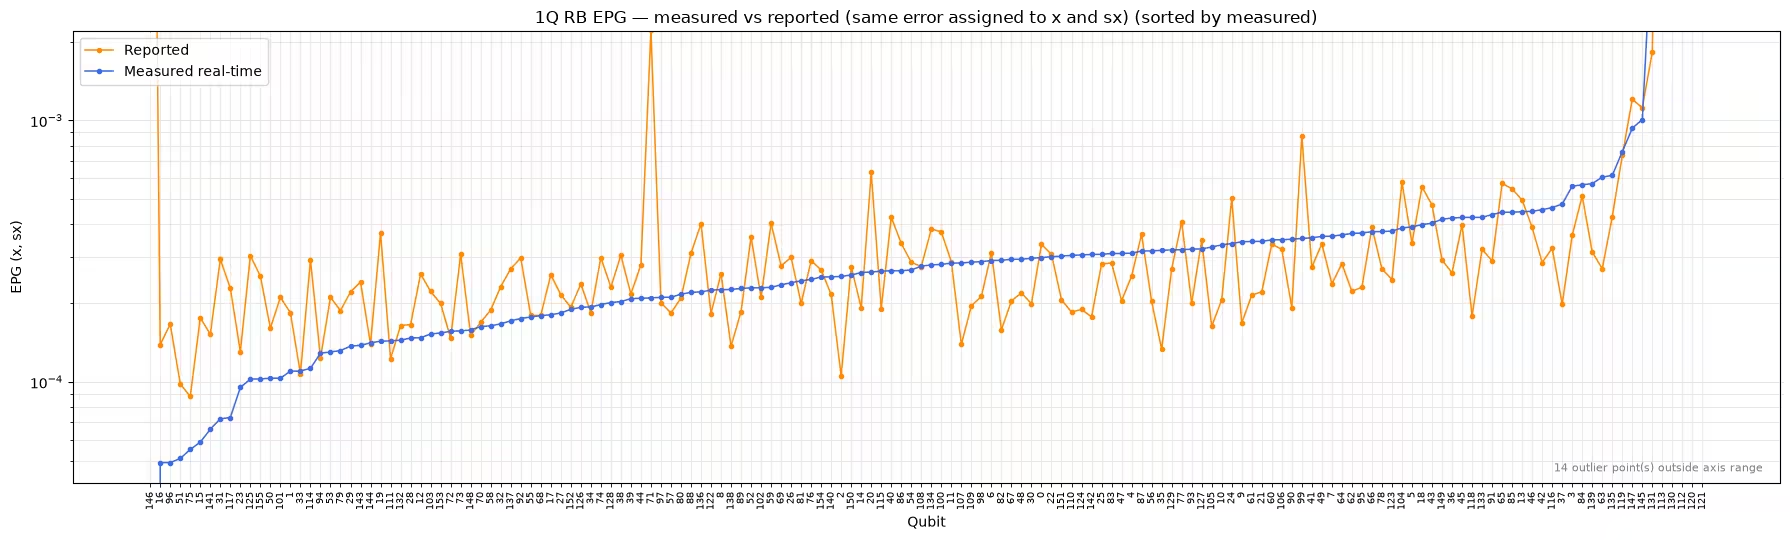
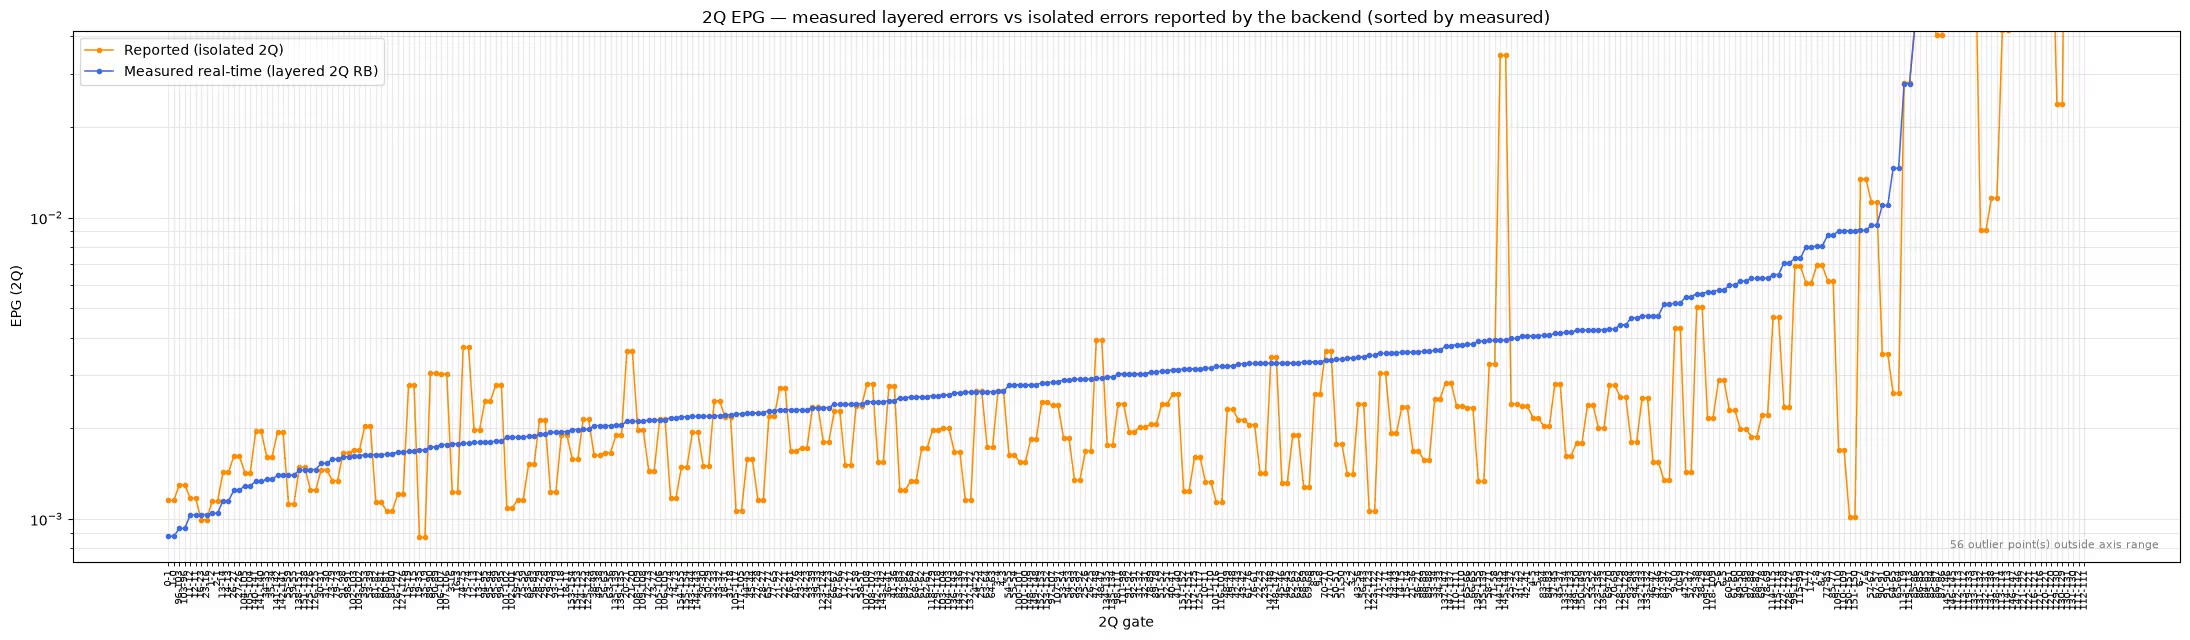
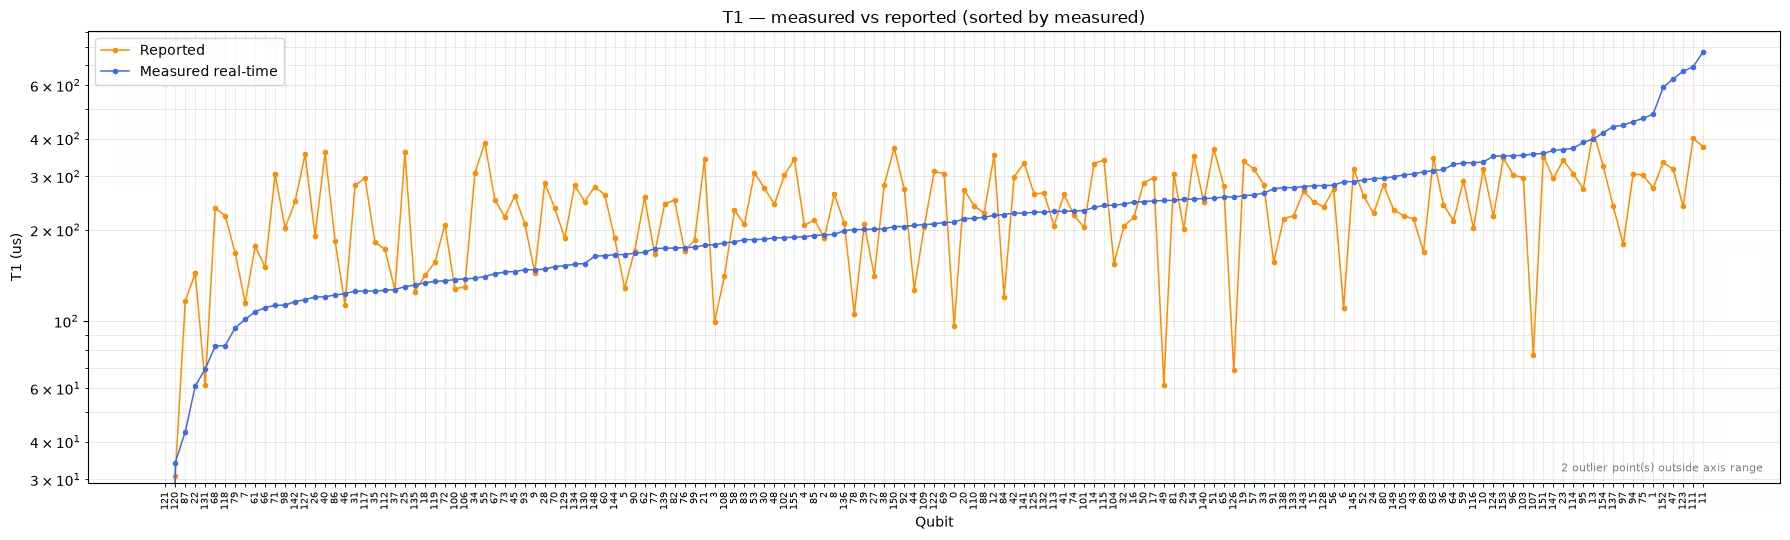
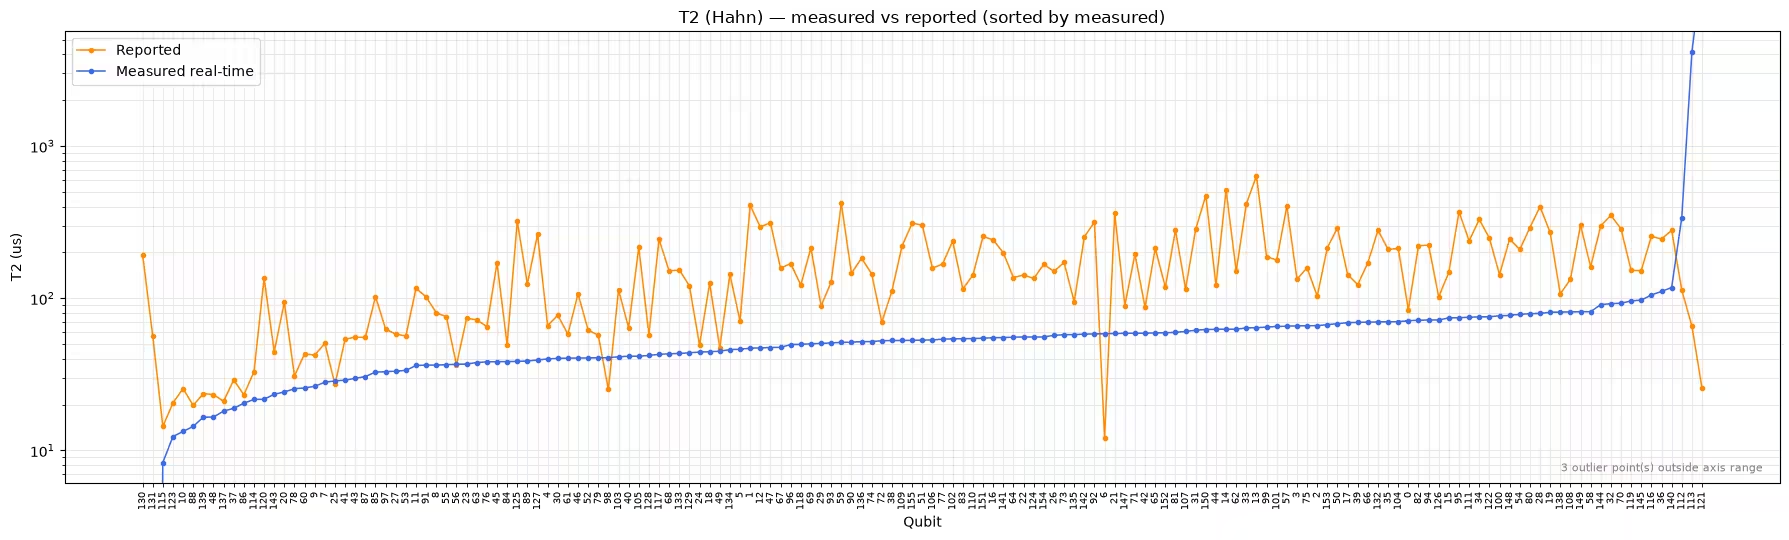
تتطلب هذه المخططات قراءة دقيقة، لأن ليست كل فجوة بين المنحنيين تعني أن الجهاز قد انحرف (drifted):
-
أخطاء القراءة و Qubit الأحادي: تتبع القيم المقاسة القيم المُبلَّغ عنها لمعظم الـ Qubits، بينما تكون القيمة المُبلَّغ عنها لعدد قليل من الـ Qubits بعيدة عن المنحنى المقاس. هذه الاختلافات الموضعية هي الانحراف (drift) الذي صُمم سير العمل هذا لرصده.
-
: تتشتت مجموعتا البيانات حول بعضهما البعض دون إزاحة منهجية، وهذا يتفق مع تقلب بشكل طبيعي مع مرور الوقت.
-
أخطاء Qubit الثنائي: تقع القيم المقاسة بشكل منهجي أعلى من القيم المُبلَّغ عنها. هذا متوقع لأن القيم المُبلَّغ عنها تُقاس على Gates معزولة، بينما تُشغّل تجربة إخلاص الطبقة العديد من الـ Gates في وقت واحد وبالتالي تتضمن التداخل (crosstalk). الأرقام الطبقية أكثر صلة بالدارات العميقة، لكنها غير قابلة للمقارنة المباشرة مع بيانات المعايرة المُبلَّغ عنها.
-
: تقع القيم المقاسة أدنى بكثير من القيم المُبلَّغ عنها لمعظم الـ Qubits. مرة أخرى، تلعب المنهجية دورًا كبيرًا، كما سنستعرض في القسم التالي.
فحص نتائج التجارب الفردية
يمكنك أيضًا فحص النتائج الخام لتجارب التوصيف الفردية من خلال الخاصية experiment_data، التي تُعيد كائنات ExperimentData الأساسية من Qiskit Experiments. على سبيل المثال، يعرض ما يلي منحنى انحلال المقاس لـ Qubit واحد، وهو أمر مفيد للتحقق من جودة الملاءمة (fit) قبل الوثوق بالرقم الذي أنتجته.
t1_data = characterizer.experiment_data["t1"]

# Each qubit has its own fit figure
n_figs = len(t1_data.figure_names)
print(f"{n_figs} figures available, e.g. {t1_data.figure_names[0]}")

# Show the T1 decay curve of the first qubit
t1_data.figure(0)
156 figures available, e.g. T1_Q0_c78ef792.svg

قياس T2 باستخدام قطار فك الاقتران الديناميكي (dynamical decoupling)
بشكل افتراضي، تطبق تجربة صدى هان واحد (Hahn echo) وتقيس جميع الـ Qubits بالتوازي، وهو ما قد يؤدي، كما أظهر مخطط المقارنة أعلاه، إلى قيم أقل بشكل ملحوظ مما يُبلّغ عنه Backend. أحد الفرضيات هو عدد الأصداء: قد تُعاير القيم المُبلَّغ عنها باستخدام فك الاقتران الديناميكي (dynamical decoupling)، الذي يقمع الضوضاء منخفضة التردد. لاختبار ذلك، شغّل توصيفًا خاصًا بـ فقط مع تعيين t2_num_echoes إلى قيمة أكبر، مما يطبق قطارًا من نبضات الصدى على طراز CPMG. تمثل التأخيرات إجمالي زمن التطور الحر في كلتا الحالتين، لذا فإن قيم الملائمة قابلة للمقارنة المباشرة مع نتائج الصدى الواحد.
# Run a T2-only characterization using a CPMG-style train of 8 echoes
characterizer_dd = BackendCharacterization(backend)
backend_updated_dd = characterizer_dd.run_and_update(
    experiments=["t2"], t2_num_echoes=8
)
Building T2 experiments
T2 (Hahn) experiment submitted: ['d9b96s6g26ic73dflcn0']
Updating T2
# Compare the multi-echo T2 against the backend-reported values
plot_characterization_comparison(
    old_props=backend.properties().to_dict(),
    new_props=backend_updated_dd.properties().to_dict(),
    plots=["t2"],
    title_prefix="8-echo CPMG",
)

# Compare medians across the reported values, the single-echo run,
# and the 8-echo run
reported_t2s = [
    prop["value"]
    for qubit in backend.properties().to_dict()["qubits"]
    for prop in qubit
    if prop["name"] == "T2"
]
t2_reported = np.median(reported_t2s)
t2_single = np.median(list(error_maps["t2_map"].values())) * 1e6
t2_dd = (
    np.median(list(characterizer_dd.analyze_results()["t2_map"].values()))
    * 1e6
)
print(
    f"Median T2 — reported: {t2_reported:.0f} us | "
    f"single echo: {t2_single:.0f} us | 8-echo CPMG: {t2_dd:.0f} us"
)
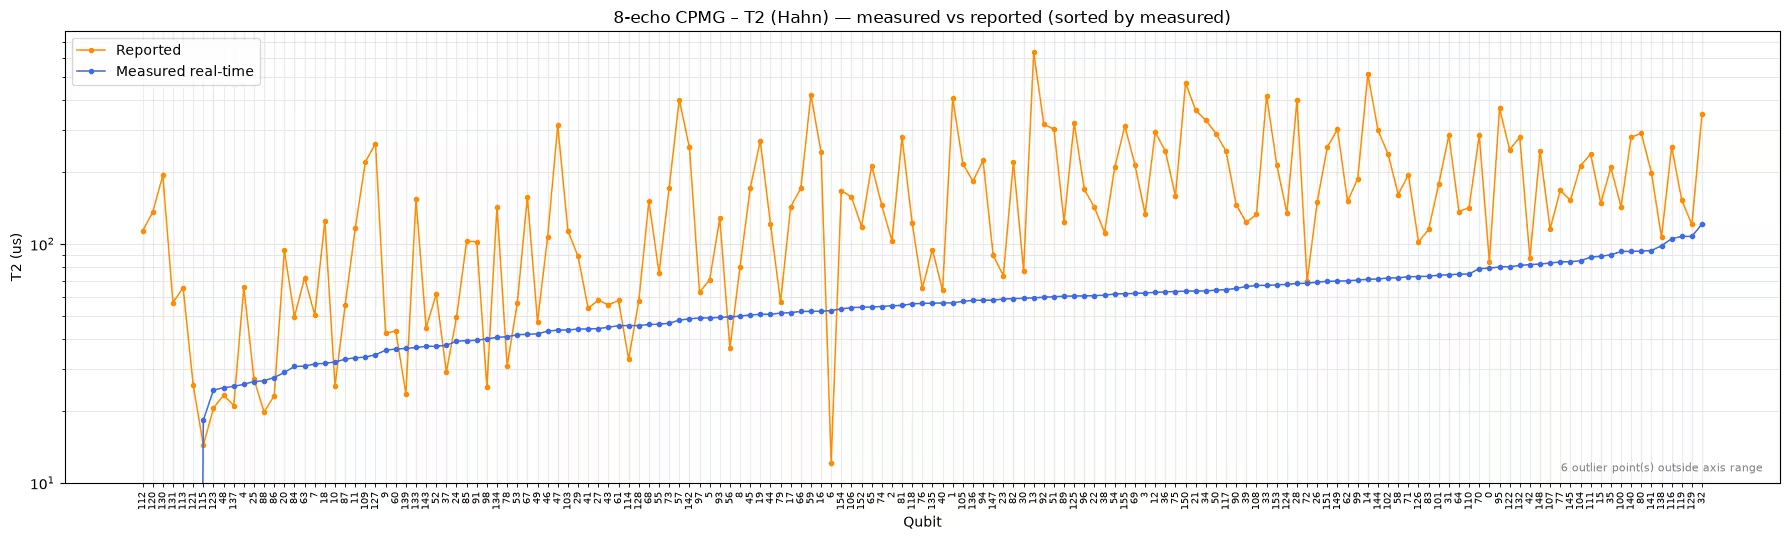
Median T2 — reported: 142 us | single echo: 53 us | 8-echo CPMG: 56 us
في هذا التشغيل، لم تغيّر الأصداء الإضافية النتيجة إلا بالكاد: الوسيط لـ 8 أصداء (56 µs) قريب من وسيط الصدى الواحد (53 µs)، ويبقى كلاهما أقل بكثير من الوسيط المُبلَّغ عنه (142 µs). عدد الأصداء وحده لا يفسر هذه الفجوة؛ فهناك اختلافات منهجية أخرى متورطة، مثل تفاصيل إجراء المعايرة، وقياس جميع الـ Qubits بالتوازي بدلًا من عزلها، وما إلى ذلك.
الدرس العملي هو التعامل بحذر مع مقارنات (وخطأ Qubit الثنائي الطبقي) عبر المنهجيات المختلفة. القيم المُحدَّثة هي لقطة متسقة ذاتيًا مأخوذة في ظروف قريبة من عبء عمل حقيقي، ما يجعلها مناسبة تمامًا لمقارنة الـ Qubits ببعضها البعض أو لتتبع جهاز بمرور الوقت. ومع ذلك، فإن الفجوة بالنسبة إلى بيانات المعايرة المُبلَّغ عنها ليست دليلًا تلقائيًا على الانحراف (drift).
الخطوات من 1 إلى 4 مضغوطة في استدعاء واحد
للاستخدام اليومي، نادرًا ما تحتاج إلى النتائج الوسيطة. تسلسل الطريقة run_and_update كل ما فعلته أعلاه (البناء، والإرسال، والملاءمة، والتحديث) في استدعاء واحد يُعيد Backend المُحدَّث. تقبل نفس قائمة experiments (وتمرر خيارات مثل t2_num_echoes)، ويمكن كذلك تغليفها في سياق Batch أو Session.
لا تُعيد الخلية التالية أي شيء حتى تكتمل جميع المهام والمعالجة اللاحقة.
# Initialize a fresh characterizer
characterizer = BackendCharacterization(backend)

# Run all of the experiments and update the backend in a single call
backend_updated = characterizer.run_and_update(experiments=experiments)
Building readout experiments
Building 1Q RB experiments
Building 2Q RB experiments
Building T1 experiments
Building T2 experiments
Layered two-qubit RB submitted: ['d9b7oqnu62qs738otat0', 'd9b7p76g26ic73dfjolg', 'd9b7pnm6hjac73ffb57g', 'd9b7q4fu62qs738otce0']
Readout job submitted: d9b7q4mg26ic73dfjprg
T1 experiment submitted: ['d9b7q57u62qs738otcfg']
T2 (Hahn) experiment submitted: ['d9b7q5m6hjac73ffb5pg']
Single-qubit RB submitted: ['d9b7r4e6hjac73ffb71g', 'd9b7reu6hjac73ffb7d0']
Updating readout error
Updating single-qubit X error
Updating single-qubit SX error
Updating two-qubit error
Updating T1
Updating T2
أصبح الكائن backend_updated المُحدَّث الآن جاهزًا للاستخدام في أي مكان تغذي فيه خصائص Backend سير عملك. جرّب هذه العملية بالاقتران مع البرنامج التعليمي قياس الأداء في الوقت الحقيقي لاختيار الكيوبتات لاختيار الـ Qubits ذات الأداء الأفضل عند ترجمة (transpile) دارة. ولأن الجهاز يستمر في الانحراف، حدّث الخصائص قريبًا من الوقت الذي تنفذ فيه عبء عملك فعليًا.
الخطوات التالية
إذا وجدت هذا العمل مثيرًا للاهتمام، فقد تهتم بالمواد التالية:
- استخدم الخصائص المُحدَّثة لاختيار Qubits أفضل في البرنامج التعليمي قياس الأداء في الوقت الحقيقي لاختيار الكيوبتات
- تعرّف على كيفية عرض بيانات المعايرة المُبلَّغ عنها في دليل معلومات QPU
- استكشف تجارب التوصيف الفردية في وثائق Qiskit Experiments
- تصفّح المزيد من قياسات الأداء على مستوى الجهاز في مستودع Qiskit Device Benchmarking