تقدير طاقة الحالة الأساسية لسلسلة هايزنبرغ باستخدام VQE
تقدير الاستخدام: 37 دقيقة على معالج Heron (ملاحظة: هذا تقدير فحسب. قد يختلف وقت التشغيل الفعلي.)
نتائج التعلم
-
كيفية نمذجة سلسلة سبين هايزنبرغ كهاميلتونيان كمومي باستخدام Qiskit
-
كيفية استخدام محسِّن SPSA لتقدير طاقة الحالة الأساسية لنظام كمومي
-
كيفية تنفيذ مسارات العمل التغايرية على عتاد IBM® الكمومي باستخدام أدوات IBM Quantum الأولية والجلسات
المتطلبات الأساسية
الخلفية
سلسلة سبين هايزنبرغ هي أحد أكثر النماذج التي تمت دراستها على نطاق واسع في فيزياء المادة المكثفة والمغناطيسية الكمومية. تصف شبكةً أحادية البُعد من السبينات الكمومية المتفاعلة، حيث تترابط السبينات المجاورة عبر تفاعلات التبادل. يُعطى الهاميلتونيان لنموذج هايزنبرغ متماثل التوجه مع مجال مغناطيسي خارجي بالمعادلة:
حيث و و هي عوامل باولي التي تعمل على الموقع ، والمجموع يجري على أزواج الجيران الأقرب، و هي ثوابت اقتران التبادل (متماثلة في هذا البرنامج التعليمي)، و يمثل مجالاً مغناطيسياً خارجياً يعتمد على الموقع. في هذا البرنامج التعليمي، تُسحب قيم المجال المغناطيسي عشوائياً من الفترة . لاحظ أنه في التنفيذ أدناه، تُحدَّد مجموعة أزواج "الجيران الأقرب" بواسطة اقتران المعالج الخلفي الأصلي بين أول كيوبت، والتي قد لا تُشكِّل سلسلة خطية صارمة بحسب طبولوجيا الجهاز.
إن فهم طاقة الحالة الأساسية لهذا الهاميلتونيان أمر بالغ الأهمية في الفيزياء. تُرمِّز الحالة الأساسية معلومات عن الانتقالات الطورية الكمومية وبنية التشابك والترتيب المغناطيسي. كلاسيكياً، يصبح حساب طاقة الحالة الأساسية الدقيقة أمراً غير قابل للمعالجة مع نمو عدد السبينات، إذ يتوسع بُعد فضاء هيلبرت أسياً بمقدار لـ سبين. وهذا ما يجعله مرشحاً طبيعياً للمحاكاة الكمومية.
محلِّل القيم الذاتية الكمومي التغايري (VQE) هو خوارزمية هجينة كمومية-كلاسيكية مصممة لتقدير طاقة الحالة الأساسية لهاميلتونيان. يعمل عن طريق تهيئة حالة كمومية مُعلمَّنة (تُعرف بدالة الاختبار ansatz) على حاسوب كمومي وقياس القيمة المتوقعة . ثم يضبط محسِّن كلاسيكي المعاملات بصورة تكرارية لتقليل هذه الطاقة، مستفيداً من المبدأ التغايري (variational principle) الذي يضمن أن الطاقة المقاسة هي دائماً حدٌّ أعلى لطاقة الحالة الأساسية الفعلية.
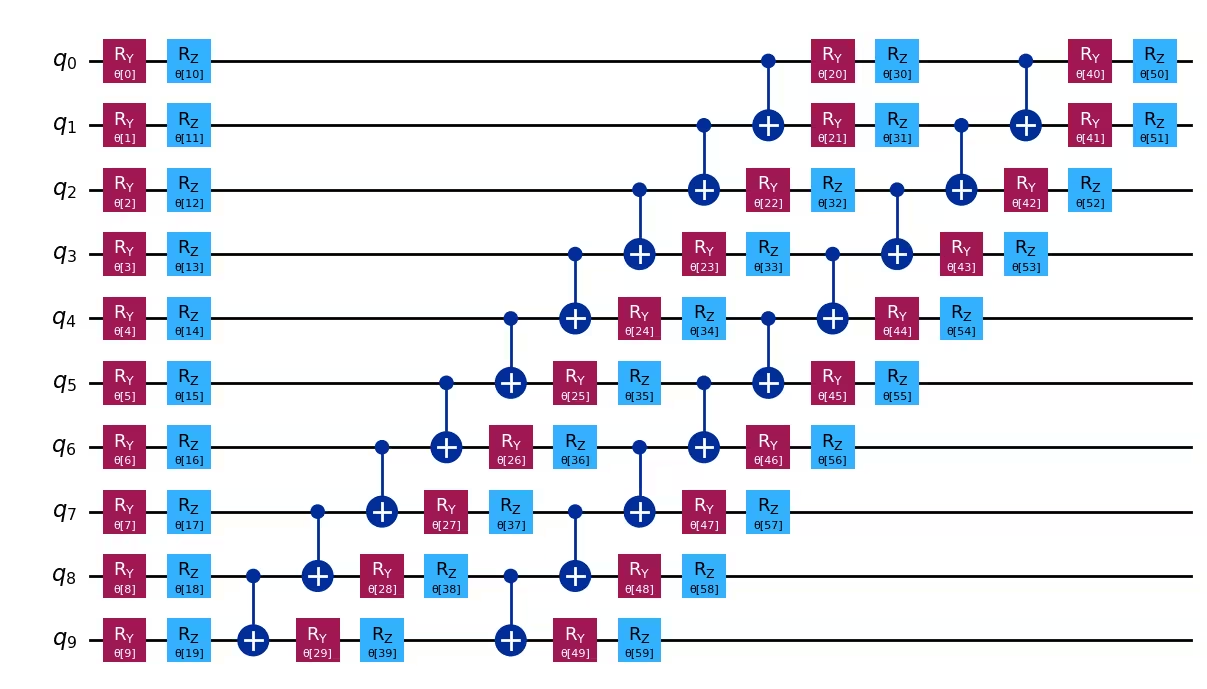
في هذا البرنامج التعليمي، نستخدم دالة الاختبار (ansatz) من نوع efficient_su2 من مكتبة الدوائر في Qiskit، والتي تبني طبقات من التدويرات أحادية الكيوبت وبوابات التشابك. يُنفَّذ التحسين باستخدام خوارزمية التقريب العشوائي للاضطراب المتزامن (SPSA)، المناسبة للعتاد الكمومي الضوضائي لأنها تقدِّر التدرجات باستخدام تقييمَي دالة فقط لكل تكرار بصرف النظر عن عدد المعاملات.
المتطلبات
قبل البدء في هذا البرنامج التعليمي، تأكد من تثبيت ما يلي:
-
Qiskit SDK الإصدار 2.0 أو أحدث، مع دعم التصور المرئي
-
Qiskit Runtime الإصدار 0.44 أو أحدث (
pip install qiskit-ibm-runtime)
الإعداد
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "qiskit": "qiskit", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import numpy as np
import matplotlib.pyplot as plt
from typing import Sequence

from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit.primitives import BaseEstimatorV2
from qiskit.circuit.library import XGate
from qiskit.circuit.library import efficient_su2
from qiskit.transpiler import PassManager
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager
from qiskit.transpiler.passes.scheduling import (
    ALAPScheduleAnalysis,
    PadDynamicalDecoupling,
)
from qiskit_ibm_runtime import QiskitRuntimeService, Session, EstimatorV2

def visualize_results(results):
    plt.plot(results["cost_history"], lw=2)
    plt.xlabel("Number of function evaluations")
    plt.ylabel("Energy")
    plt.show()
مثال صغير النطاق
في هذا القسم، نتناول كل خطوة من خطوات نمط Qiskit على نطاق صغير، مع شرح المكونات الرئيسية أثناء بناء سير العمل.
الخطوة 1: تحويل المدخلات الكلاسيكية إلى مسألة كمومية
-
المدخل: عدد السبينات (spins)
-
المخرج: دالة الاختبار (ansatz) وهاميلتونيان يُنمذجان سلسلة هايزنبرغ
نبني دالة الاختبار (ansatz) والهاميلتونيان اللذين ينمذجان سلسلة هايزنبرغ المكونة من 10 سبينات. في هذه الخطوة، سنبني هاميلتونيان هايزنبرغ لـ 10 سبينات على خريطة اقتران المعالج الخلفي الأقل انشغالاً ونُهيئ دالة الاختبار (ansatz) من نوع efficient_su2.
num_spins = 10
ansatz = efficient_su2(num_qubits=num_spins, reps=2)

service = QiskitRuntimeService()
backend = service.least_busy(
    operational=True, min_num_qubits=num_spins, simulator=False
)

coupling = backend.target.build_coupling_map()
reduced_coupling = coupling.reduce(list(range(num_spins)))

edge_list = reduced_coupling.graph.edge_list()
ham_list = []

for edge in edge_list:
    ham_list.append(("ZZ", edge, 0.5))
    ham_list.append(("YY", edge, 0.5))
    ham_list.append(("XX", edge, 0.5))

for qubit in reduced_coupling.physical_qubits:
    ham_list.append(("Z", [qubit], np.random.random() * 2 - 1))

hamiltonian = SparsePauliOp.from_sparse_list(ham_list, num_qubits=num_spins)

ansatz.draw("mpl", style="iqp")
الخطوة 2: تحسين المسألة لتنفيذها على العتاد الكمومي
-
المدخل: دائرة مجردة، ومتغير مرصود (observable)
-
المخرج: الدائرة المستهدفة والمتغير المرصود، محسَّنَين للمعالج الكمومي (QPU) المختار
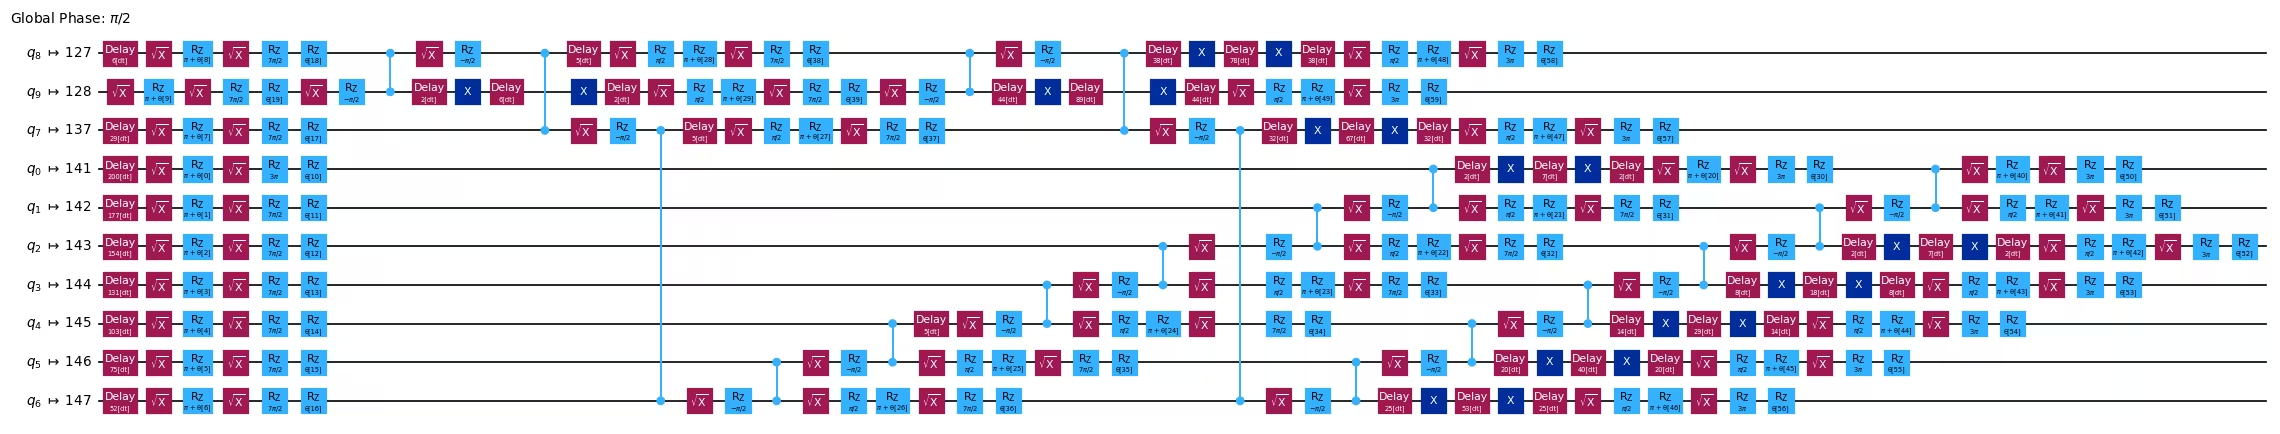
نستخدم دالة generate_preset_pass_manager من Qiskit لتوليد روتين تحسين آلي لدائرتنا بالنسبة إلى المعالج الكمومي المختار. نختار optimization_level=3 الذي يوفر أعلى مستوى من التحسين بين مديري التمريرات المُعدَّة مسبقاً. كما نُدرج تمريرات الجدولة ALAPScheduleAnalysis وPadDynamicalDecoupling لقمع أخطاء إزالة الترابط الكمومي.
target = backend.target
pm = generate_preset_pass_manager(optimization_level=3, target=target)
pm.scheduling = PassManager(
    [
        ALAPScheduleAnalysis(durations=target.durations()),
        PadDynamicalDecoupling(
            durations=target.durations(),
            dd_sequence=[XGate(), XGate()],
            pulse_alignment=target.pulse_alignment,
        ),
    ]
)
isa_ansatz = pm.run(ansatz)
isa_observable = hamiltonian.apply_layout(isa_ansatz.layout)
isa_ansatz.draw("mpl", scale=0.6, style="iqp", fold=-1, idle_wires=False)
الخطوة 3: التنفيذ باستخدام Qiskit primitives
-
المدخل: الدائرة المستهدفة والمتغير المرصود
-
المخرج: نتائج عملية التحسين
نُصغِّر طاقة الحالة الأساسية المُقدَّرة للنظام عبر تحسين معاملات الدائرة. نستخدم الأداة الأولية IBM Quantum Estimator لتقييم دالة التكلفة خلال عملية التحسين.
بما أننا حسَّنَّا الدائرة للمعالج الخلفي في الخطوة 2، يمكننا تجنب إجراء التحويل البرمجي (transpilation) على خادم Quantum Compute عبر تعيين skip_transpilation=True وتمرير الدائرة المحسَّنة. في هذا العرض التوضيحي، سنُشغِّل النمط على معالج كمومي (QPU) باستخدام أدوات IBM Quantum الأولية. للتشغيل باستخدام الأدوات الأولية المبنية على متجه الحالة في qiskit، استبدل كتلة الكود التي تستخدم أدوات IBM Quantum الأولية بالكتلة الموضوعة في تعليق.
في هذا البرنامج التعليمي، نستخدم التقريب العشوائي للاضطراب المتزامن (SPSA)، وهو محسِّن قائم على التدرج. سنقدم له مقدمة موجزة، ثم نوفر الكود لتنفيذ SPSA باستخدام Qiskit v2.0.
تعريف بـ SPSA
التقريب العشوائي للاضطراب المتزامن (SPSA) [1] هو خوارزمية تحسين تقرِّب متجه التدرج بالكامل باستخدام استدعاءَي دالة فقط في كل تكرار. لتكن دالة التكلفة ذات معاملاً مراد تحسينها، وليكن متجه المعاملات عند الخطوة من التكرار. لحساب التدرج، يُنشأ متجه عشوائي بحجم ، حيث يُسحب كل عنصر ، ، بشكل منتظم من . بعد ذلك، يُضرب كل عنصر من المتجه العشوائي في قيمة صغيرة لإنشاء اضطراب عشوائي. يُقدَّر التدرج حينئذٍ بالمعادلة:
بالحدس، بما أنه يُطبَّق اضطراب عشوائي أثناء تقدير التدرج، يُتوقَّع أن تُحتمَل الانحرافات الصغيرة في القيم الدقيقة لـ الناتجة عن الضوضاء وتُحسَب حسابها. في الواقع، يشتهر SPSA بمتانته أمام الضوضاء، ويتطلب استدعاءَي عتاد فقط في كل تكرار. لذا، يُعدّ من المحسِّنات الأكثر تفضيلاً لتنفيذ الخوارزميات التغايرية.
في هذا البرنامج التعليمي، تُحسَب المعاملات الفائقة للتكرار ، و ، وفق
حيث تُؤخذ القيم الثابتة على أنها ، ، ، ، و . هذه القيم مأخوذة من [2]. يُعدّ الضبط المناسب للمعاملات الفائقة ضرورياً لاستخراج أداء جيد من SPSA.
def spsa(
    fun, x0, args=(), A=30, alpha=0.9, a=0.3, c=0.1, gamma=0.4, maxiter=100
):
    nparams = len(x0)
    x = np.copy(x0)

    for i in range(maxiter):
        a_i = a / (A + i + 1) ** alpha
        c_i = c / (i + 1) ** gamma
        delta_i = np.random.choice([-1, 1], nparams)

        # two hardware calls
        eval_1 = fun(x + c_i * delta_i, *args)
        eval_2 = fun(x - c_i * delta_i, *args)

        # compute the gradient and update the parameters
        grad = (eval_1 - eval_2) / (2 * c_i) * np.reciprocal(delta_i)
        x = x - a_i * grad

    return x
def cost_func(
    params: Sequence,
    ansatz: QuantumCircuit,
    hamiltonian: SparsePauliOp,
    estimator: BaseEstimatorV2,
    cost_history_dict: dict,
) -> float:
    """Ground state energy evaluation."""
    energy = (
        estimator.run([(ansatz, hamiltonian, [params])]).result()[0].data.evs
    )

    cost_history_dict["iters"] += 1
    cost_history_dict["prev_vector"] = list(params)
    cost_history_dict["cost_history"].append(float(energy[0]))

    print(
        f"Fx Iters. done: {cost_history_dict['iters']} [Current cost: {round(energy[0], 5)}]",
        end="\r",
    )

    return energy

def solve(x0, isa_ansatz, isa_observable, maxiter=150):
    cost_history_dict = {
        "prev_vector": None,
        "iters": 0,
        "cost_history": [],
        "y_min": None,
    }

    # Evaluate the problem using a QPU via `qiskit-ibm-runtime`
    with Session(backend=backend) as session:
        estimator = EstimatorV2(mode=session)
        estimator.skip_transpilation = True
        estimator.options.environment.job_tags = ["TUT_HSVQE"]
        x_opt = spsa(
            cost_func,
            x0=x0,
            args=(isa_ansatz, isa_observable, estimator, cost_history_dict),
            maxiter=maxiter,
        )

        y_min = cost_func(
            x_opt, isa_ansatz, isa_observable, estimator, cost_history_dict
        )

    return y_min, cost_history_dict
np.random.seed(42)
num_params = ansatz.num_parameters
params = 2 * np.pi * np.random.random(num_params)
هنا نضع maxiter = 50. لاحظ أنه بما أن كل تكرار يتطلب استدعاءَي للدالة لحساب التدرج، فإن إجمالي عدد استدعاءات الدالة سيكون . يمكن زيادة maxiter إلى أي قيمة أعلى للحصول على تقدير طاقة أفضل.
maxiter = 50
spsa_min, spsa_history = solve(
    params, isa_ansatz, isa_observable, maxiter=maxiter
)
Fx Iters. done: 101 [Current cost: -3.03843]
الخطوة 4: المعالجة اللاحقة وإعادة النتيجة بالتنسيق الكلاسيكي المطلوب
-
المدخل: تقديرات طاقة الحالة الأساسية خلال عملية التحسين
-
المخرج: طاقة الحالة الأساسية المُقدَّرة
print(f"Estimated ground state energy: {spsa_min}")
Estimated ground state energy: [-3.03842968]
results = {
    "spsa": spsa_history,
}

visualize_results(spsa_history)

مثال عتاد واسع النطاق
لا يتضمن هذا البرنامج التعليمي مثالاً على عتاد واسع النطاق. مع ازدياد عدد الكيوبتات، يواجه VQE تحديات كبيرة بسبب ظاهرة الهضبة القاحلة: يتلاشى تدرج دالة التكلفة أسياً مع حجم النظام، مما يجعل التحسين غير قابل للتطبيق فعلياً للدوائر الكبيرة. ومع ضوضاء العتاد، يعني هذا أن توسع VQE إلى سلاسل سبين أكبر لا يُنتج نتائج قابلة للاستنساخ بشكل موثوق. للاطلاع على أساليب تتغلب على هذه القيود، راجع قسم الخطوات التالية أدناه.
التحدي
الآن وبعد أن أصبح لديك تنفيذ VQE يعمل لسلسلة هايزنبرغ، جرِّب ما يلي:
-
تجربة عمق دالة الاختبار (ansatz): عدِّل معامل
repsفيefficient_su2(على سبيل المثال، جرِّبreps=1وreps=3). كيف يؤثر عمق دالة الاختبار (ansatz) على طاقة الحالة الأساسية المُقدَّرة وسرعة التقارب؟ عند أي نقطة تلاحظ تناقص العوائد أو عدم الاستقرار؟ -
ضبط المعاملات الفائقة لـ SPSA: اضبط معاملات جدول معدل التعلم (
a،c،alpha،gamma،A) وراقب تأثيرها على التقارب. هل يمكنك إيجاد تهيئة تتقارب أسرع من القيم الافتراضية المستخدمة هنا؟ -
مقارنة طبولوجيات الاقتران: بدلاً من استخدام خريطة الاقتران الأصلية للمعالج الخلفي، جرِّب بناء سلسلة خطية بسيطة لأقرب جار وقارن النتائج. كيف تؤثر اتصالية العتاد المادي على عمق الدائرة بعد التحويل البرمجي (transpilation) وتقدير الطاقة النهائي؟
المراجع
[1] Spall, J. C. (2002). Implementation of the simultaneous perturbation algorithm for stochastic optimization. IEEE Transactions on Aerospace and Electronic Systems, 34(3), 817-823.
[2] Sahin, M. Emre, et al. (2025). Qiskit Machine Learning: an open-source library for quantum machine learning tasks at scale on quantum hardware and classical simulators. arXiv:2505.17756.
الخطوات التالية
إن أثار هذا العمل اهتمامك، فقد يهمك الاطلاع على المواد التالية:
-
جرِّب القطرنة الكمومية القائمة على العينات (SQD): كما تبيَّن في هذا البرنامج التعليمي، يواجه VQE تحديات على نطاق واسع بسبب الهضبات القاحلة والتكلفة العالية للقياسات. طورت IBM القطرنة الكمومية القائمة على العينات (SQD) بوصفه بديلاً أكثر قابلية للتوسع. على خلاف VQE، يتجنب SQD التحسين التغايري كلياً؛ إذ يولِّد الحاسوب الكمومي عينات، ثم يُسقط الحاسوب الكلاسيكي الهاميلتونيان على فضاء جزئي مُمتد بتلك العينات ويُجري القطرنة. يُوفر ذلك حداً أعلى لطاقة الحالة الأساسية بعدد أقل بكثير من القياسات ودون التعرض للهضبات القاحلة. اتبع درس SQD التعليمي لترى هذا النهج في العمل.
-
استكشف دورة خوارزميات القطرنة الكمومية: عمِّق فهمك لكل من VQE وSQD، بما فيها المقايضات بينهما، في دورة خوارزميات القطرنة الكمومية على IBM Quantum Learning.