القطرنة الكمومية بطريقة كريلوف لهاميلتونيات الشبكة
تقدير الاستخدام: 70 دقيقة على معالج Heron أو Nighthawk (ملاحظة: هذا تقدير فقط. قد يختلف وقت التشغيل الفعلي لديك.)
مخرجات التعلّم
-
كيفية تفسير القطرنة الكمومية بطريقة كريلوف (KQD) على أنها تعلّم دالة هاميلتونية منتهية تعمل كمرشح طيفي.
-
كيفية بناء مصفوفتي الهاميلتونية والتراكب المسقَطتين باستخدام قياسات اختبار التبديل الممتد.
-
كيفية حل مسألة القيم الذاتية المعمّمة (GEVP) الناتجة واسترجاع تقدير لطاقة الحالة الأرضية لهاميلتونية الشبكة.
المتطلبات الأساسية
الخلفية
يوضح هذا البرنامج التعليمي كيفية تنفيذ خوارزمية القطرنة الكمومية بطريقة كريلوف (KQD) في سياق أنماط Qiskit. ستتعلم أولاً النظرية الكامنة وراء الخوارزمية ثم سترى عرضاً توضيحياً لتنفيذها على وحدة معالجة كمية (QPU).
تقدير الخصائص منخفضة الطاقة لهاميلتونيات الأجسام المتعددة مهمة محورية في المحاكاة الكمومية. فعلى سبيل المثال، ترتبط طاقات الحالة الأرضية والإثارات المنخفضة ارتباطًا مباشرًا بالاستقرار الكيميائي، والترتيب المغناطيسي، والانتقالات الطورية الكمومية، واستجابة المواد. على الحاسوب التقليدي، ينمو بُعد فضاء هلبرت أسيًا مع عدد المدارات أو اللفات المغزلية، لذا يصبح القطر المباشر غير عملي بسرعة.
هناك عدة مناهج حوسبة كمومية لهذه المسألة. تستخدم الطرق التغايرية قريبة المدى، مثل حلّال القيم الذاتية الكمومي التغايري (VQE)، دوائر معلمنة ضحلة نسبيًا، لكنها تتطلب حلقة تحسين تقليدية غير خطية مع العديد من تقييمات الدائرة الكمومية. في الطرف الآخر، يوفر تقدير الطور الكمومي (QPE) طريقًا أكثر مباشرة لتقدير القيم الذاتية بضمانات صارمة، لكن QPE القياسي يتطلب دوائر متماسكة طويلة ويناسب بشكل رئيسي الحواسيب الكمومية المتسامحة مع الخطأ. تقع KQD بين هذين المنهجين: فهي تستخدم التطور الزمني الحقيقي للهاميلتونية، كما في الخوارزميات المعتمدة على تقدير الطور، لكنها تستبدل تقدير الطور الكامل بمسألة قيم ذاتية مسقَطة مدمجة يمكن حلها تقليديًا.
لنعتبر هاميلتونية لـ من الكيوبتات وحالة مرجعية . تبني طريقة KQD فضاء كريلوف من حالات مطورة زمنيًا حقيقيًا،
حيث هو بُعد كريلوف و هي الخطوة الزمنية. تُمثَّل عندئذٍ أي حالة في فضاء كريلوف كتركيب خطي من حالات الأساس هذه،
where the denominator normalizes the state.
بجبر بسيط، يمكننا أن نرى أن الطاقة المقابلة تُكتب كحاصل قسمة رايلي،
هنا، المصفوفتان و ،
تُعرّفان مصفوفتي التراكب والهاميلتونية المسقَطتين. تُقدَّر مدخلاتهما باستخدام قياسات الدائرة الكمومية.
نهدف إلى إيجاد المعامل الذي يعطي أدنى قيمة لـ :
وفقًا لنظرية رايلي-ريتز، يكافئ هذا التصغير حل مسألة القيم الذاتية المعمّمة (GEVP)،
لاحظ أن البُعد يمكن أن يكون صغيرًا بما يكفي ليتمكن الحاسوب التقليدي من حل مسألة GEVP.
هذا هو نفس المبدأ التغايري المستخدم في القطرنة الفرعية التقليدية، لكن هنا تُولَّد حالات الأساس بواسطة التطور الزمني الكمومي. مقارنة بـ VQE، تتطلب KQD عادةً دوائر أعمق لأنها تعتمد على التطور الزمني الحقيقي. في المقابل، تتجنب KQD التحسين غير الخطي للمعاملات والتنفيذ التكراري على العتاد الكمومي، وتتحسن بشكل منهجي مع توسيع الفضاء المسقَط. أُثبتت هذه الخوارزمية على نطاق واسع على عتاد كمومي موجود [2]، ويمكن تحليل أدائها بضمانات قابلة للإثبات [1].
المتطلبات
قبل البدء بهذا البرنامج التعليمي، تأكد من تثبيت ما يلي:
-
Qiskit SDK الإصدار v2.3 أو أحدث مع دعم التصور المرئي
-
Qiskit Runtime الإصدار 0.22 أو أحدث (
pip install qiskit-ibm-runtime) -
SciPy (
pip install scipy) -
Matplotlib (
pip install matplotlib) -
Pandas (
pip install pandas)
يتطلب التنفيذ على العتاد qiskit-ibm-runtime والوصول إلى حساب ®IBM Quantum.
الإعداد
تستورد خلية الإعداد الوحدات المطلوبة وتُعرّف دوال مساعدة لسير العمل:
-
بناء هاميلتونية هايزنبرغ؛
-
حل مسألة GEVP بعد تطبيق العتبة؛
-
تقييم مرشح كريلوف المتعلَّم؛
-
تحويل قيم المرشح إلى أوزان طيفية؛
-
رسم توزيعات الطاقة المرجعية والمرشَّحة.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "pandas": "pandas", "qiskit": "qiskit", "qiskit_ibm_runtime": "qiskit-ibm-runtime", "scipy": "scipy"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from __future__ import annotations

import warnings

import numpy as np
import pandas as pd
import scipy.linalg as la
import matplotlib.pyplot as plt

from qiskit import QuantumCircuit, transpile
from qiskit.circuit import Parameter
from qiskit.circuit.library import PauliEvolutionGate
from qiskit.primitives import StatevectorEstimator
from qiskit.quantum_info import Operator, SparsePauliOp
from qiskit.synthesis import LieTrotter, SuzukiTrotter
from qiskit.transpiler import PassManager, Layout
from qiskit.transpiler.passes import CommutativeOptimization
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager
from qiskit_ibm_runtime import QiskitRuntimeService, EstimatorV2, Batch
from qiskit_ibm_runtime.fake_provider import FakeMarrakesh

warnings.filterwarnings("ignore")

def make_heisenberg_hamiltonian(
    num_qubits: int,
    coupling: float = 1.0,
) -> SparsePauliOp:
    """Make a Heisenberg Hamiltonian for a 1D chain of qubits with nearest-neighbor interactions."""
    terms: list[tuple[str, complex]] = []

    def append_term(q0: int, q1: int, pauli: str):
        label = ["I"] * num_qubits
        label[num_qubits - 1 - q0] = pauli[0]
        label[num_qubits - 1 - q1] = pauli[1]
        terms.append(("".join(label), coupling))

    for pauli in ("XX", "YY", "ZZ"):
        for q in range(num_qubits - 1):
            append_term(q, q + 1, pauli)
    return SparsePauliOp.from_list(terms).simplify()

def _basis_state_transition_amplitude_sparse(
    hamiltonian: SparsePauliOp,
    bra_state: int,
    ket_state: int,
) -> complex:
    """Evaluate <bra_state|H|ket_state> for computational-basis states."""
    num_qubits = hamiltonian.num_qubits
    amplitude = 0.0 + 0.0j
    for pauli, coeff in zip(hamiltonian.paulis, hamiltonian.coeffs):
        new_state = ket_state
        phase = 1.0 + 0.0j
        for q in range(num_qubits):
            x = bool(pauli.x[q])
            z = bool(pauli.z[q])
            if not x and not z:
                continue
            bit = (new_state >> q) & 1
            if x and z:
                # Y|0> = i|1>, Y|1> = -i|0>
                phase *= 1j if bit == 0 else -1j
                new_state ^= 1 << q
            elif x:
                new_state ^= 1 << q
            else:
                # Z|0> = |0>, Z|1> = -|1>
                if bit:
                    phase *= -1
        if new_state == bra_state:
            amplitude += coeff * phase
    return amplitude

def basis_state_expectation_sparse(
    hamiltonian: SparsePauliOp,
    bitstring: str,
) -> complex:
    """Evaluate <bitstring|H|bitstring>."""
    state = int(bitstring, 2)
    return _basis_state_transition_amplitude_sparse(
        hamiltonian,
        bra_state=state,
        ket_state=state,
    )

def diagonalize_single_1_subspace(
    hamiltonian: SparsePauliOp,
) -> np.ndarray:
    """Diagonalize the Hamiltonian projected onto the single-excitation subspace."""
    num_qubits = hamiltonian.num_qubits

    # Integer basis states |...010...>, with the excitation at qubit k.
    basis = [1 << k for k in range(num_qubits)]

    h_single = np.empty((num_qubits, num_qubits), dtype=complex)

    for row, bra_state in enumerate(basis):
        for col, ket_state in enumerate(basis):
            h_single[row, col] = _basis_state_transition_amplitude_sparse(
                hamiltonian,
                bra_state=bra_state,
                ket_state=ket_state,
            )
    # Remove floating-point-level asymmetry.
    h_single = 0.5 * (h_single + h_single.conj().T)
    evals, _ = np.linalg.eigh(h_single)
    return np.real(evals)

def simple_transpilation(circuit: QuantumCircuit) -> QuantumCircuit:
    """Transpilation to simplify the circuit"""
    pm = PassManager(
        [
            CommutativeOptimization(),
        ]
    )
    circuit = transpile(circuit, optimization_level=3)
    circuit = pm.run(circuit)
    return circuit

def summarize_circuit(circuit: QuantumCircuit) -> dict[str, int | str]:
    """Summarize the circuit with depth, size, and 2-qubit gate information."""
    two_qubit_total = sum(
        inst.operation.num_qubits == 2 for inst in circuit.data
    )
    two_qubit_depth = circuit.depth(lambda x: x[0].num_qubits == 2)
    return {
        "depth": circuit.depth(),
        "size": circuit.size(),
        "2q gates": two_qubit_total,
        "2q depth": two_qubit_depth,
    }

def solve_thresholded_gevp(
    h_matrix: np.ndarray,
    s_matrix: np.ndarray,
    threshold: float = 1e-10,
) -> tuple[float, np.ndarray, int]:
    """Solve H c = E S c using canonical orthogonalization of S."""
    s_vals, s_vecs = la.eigh(s_matrix)

    valid = s_vals > threshold
    if not np.any(valid):
        raise ValueError(
            "All overlap eigenvalues were removed by thresholding."
        )

    keep = valid

    orthogonalizer = s_vecs[:, keep] @ np.diag(1.0 / np.sqrt(s_vals[keep]))
    h_orth = orthogonalizer.conj().T @ h_matrix @ orthogonalizer
    h_orth = 0.5 * (h_orth + h_orth.conj().T)

    eigvals, eigvecs = la.eigh(h_orth)

    coeffs = orthogonalizer @ eigvecs[:, 0]
    normalization = np.sqrt(np.real(coeffs.conj().T @ s_matrix @ coeffs))
    coeffs /= normalization

    return float(np.real(eigvals[0])), coeffs, int(np.sum(keep))
في الجزء الأول من هذا الدرس التعليمي، نوضّح طريقة KQD باستخدام محاكي متجه حالة محلي. لاحقًا، نستخدم Backend كموميًا حقيقيًا لمعالجة مسألة على نطاق فائدة عملية.
نُعرّف أيضًا Backend وهميًا لتوضيح التحويل الخاص بـ Backend وفحص الدائرة الناتجة.
try:
    service = QiskitRuntimeService()
except Exception:
    QiskitRuntimeService.save_account(
        token="<api_token>", instance="<instance>", overwrite=True
    )
    service = QiskitRuntimeService()

backend = FakeMarrakesh()
مثال محاكاة على نطاق صغير
الخطوة 1: تعيين المدخلات الكلاسيكية إلى مشكلة كمية
الهاميلتونية والحالة المرجعية
يستخدم هذا المثال سلسلة هايزنبرغ مفتوحة الحدود مكونة من 12 كيوبت ()،
بحالة جداء ذات إثارة واحدة
كحالة مرجعية. بما أن هاميلتونية هايزنبرغ المعرَّفة أعلاه تحافظ على العدد الكلي للإثارات، تبقى الحالة المرجعية في فضاء الإثارة الواحدة، الذي ينمو بُعده خطيًا فقط مع عدد الكيوبتات. لذا يمكننا حساب طاقة الحالة الأرضية الدقيقة بكفاءة، عن طريق قطر الهاميلتونية المقتصرة على ذلك الفضاء، واستخدامها كمعيار تشخيصي بحت لتقدير KQD. أما سير عمل KQD نفسه فيقدّر عناصر المصفوفة المسقَطة باستخدام بدائيات Qiskit ويحل المسألة المسقَطة الناتجة تقليديًا.
# Problem definition for the simulator example
num_qubits = 12
hamiltonian = make_heisenberg_hamiltonian(num_qubits=num_qubits, coupling=1.0)
ref_bitstring = "000001000000"
ref_energy = basis_state_expectation_sparse(hamiltonian, ref_bitstring)

print("Hamiltonian:")
print(hamiltonian)
print(f"Reference state: |{ref_bitstring}>")
print("Reference energy: ", ref_energy)
Hamiltonian:
SparsePauliOp(['IIIIIIIIIIXX', 'IIIIIIIIIXXI', 'IIIIIIIIXXII', 'IIIIIIIXXIII', 'IIIIIIXXIIII', 'IIIIIXXIIIII', 'IIIIXXIIIIII', 'IIIXXIIIIIII', 'IIXXIIIIIIII', 'IXXIIIIIIIII', 'XXIIIIIIIIII', 'IIIIIIIIIIYY', 'IIIIIIIIIYYI', 'IIIIIIIIYYII', 'IIIIIIIYYIII', 'IIIIIIYYIIII', 'IIIIIYYIIIII', 'IIIIYYIIIIII', 'IIIYYIIIIIII', 'IIYYIIIIIIII', 'IYYIIIIIIIII', 'YYIIIIIIIIII', 'IIIIIIIIIIZZ', 'IIIIIIIIIZZI', 'IIIIIIIIZZII', 'IIIIIIIZZIII', 'IIIIIIZZIIII', 'IIIIIZZIIIII', 'IIIIZZIIIIII', 'IIIZZIIIIIII', 'IIZZIIIIIIII', 'IZZIIIIIIIII', 'ZZIIIIIIIIII'],
              coeffs=[1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j,
 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j,
 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j,
 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j])
Reference state: |000001000000>
Reference energy:  (7+0j)
تعيين معاملات الخوارزمية
استنادًا إلى الحدود العليا لمعيار الهاميلتونية، يقترح المرجع [1] بشكل استدلالي الخطوة الزمنية كـ . نظرًا لأن المعيار الطيفي صعب الحساب، نستخدم بدلًا منه حده الأعلى:
نحدد بُعد كريلوف عند وعدد خطوات تروتر لكل خطوة زمنية عند : فضاء كريلوف كبير بما يكفي لحل الطيف منخفض الطاقة مع إبقاء أعمق دائرة () قابلة للتحمل، وعدد كافٍ من خطوات تروتر لإبقاء خطأ التقسيم صغيرًا عند تلك الدائرة الأعمق.
dt = np.pi / (3 * (num_qubits - 1))
print("dt in Krylov basis:  ", dt)

krylov_dim = 10
num_trotter_steps = 5
dt in Krylov basis: 0.09519977738150888
بناء الدائرة
هنا، نبني الدوائر لتقدير عناصر المصفوفة و . بما أن جميع قوى تتبادل، لدينا
Such matrices where the elements depend on the index differences in this manner are called Toeplitz and can be reconstructed from first-row elements indexed by .
هنا، نقدّم الدائرة المسماة اختبار التبديل الممتد، التي تُحضّر
حيث .
الحالة المرجعية
نُحضّر الحالة المرجعية .
qc_ref = QuantumCircuit(num_qubits)
for i, b in enumerate(reversed(ref_bitstring)):
    if b == "1":
        qc_ref.x(i)
display(qc_ref.draw("mpl", scale=0.5))

التطور الزمني
إدراك مؤثر التطور الزمني المولَّد بالهاميلتونية، مقربًا بواسطة تروترة لي البسيطة.
t = Parameter("t")

evol_gate = PauliEvolutionGate(
    hamiltonian,
    time=t,
    synthesis=LieTrotter(reps=num_trotter_steps),
    label="U(t)",
)

# Synthesize U(t) first and then control the synthesized circuit.
# This makes the controlled structure visible in the circuit drawer.
evolution_circuit = QuantumCircuit(num_qubits, name="U(t)")
evolution_circuit.append(evol_gate, range(num_qubits))
evolution_circuit = simple_transpilation(evolution_circuit)

# Make a controlled version of the evolution circuit.
controlled_evolution_gate = evolution_circuit.to_gate(label="U(t)").control(
    1, label="C-U(t)"
)
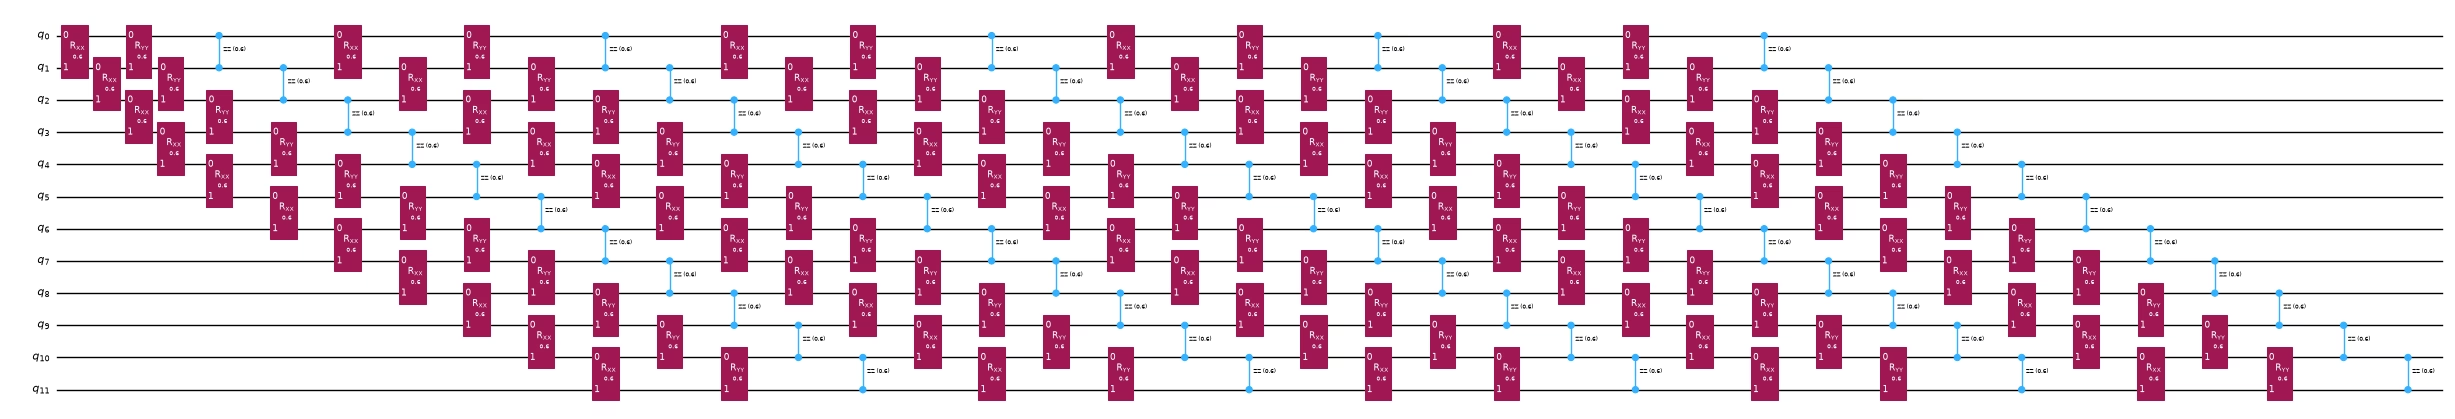
display(
    evolution_circuit.assign_parameters({t: 1.5}).draw(
        "mpl", scale=0.5, fold=-1
    )
)
دائرة اختبار التبديل الممتد [3]
تُحضّر الدائرة أولًا الحالة المرجعية على سجل النظام بينما تبقى الحالة المساعدة في :
بعد ذلك، يؤدي تطبيق بوابة هادامارد على الحالة المساعدة إلى إنشاء تراكب متماسك من فرعين:
أخيرًا، يطبق بوابة التطور الزمني المتحكم بها:
فقط عندما تكون الحالة المساعدة في فرع . لذلك،
في كتلة الشيفرة التالية، نطبّق:
والتي ستُسند كـ لـ في خطوة التنفيذ.
ancilla = 0
system_qubits = list(range(1, num_qubits + 1))

extended_swap_test = QuantumCircuit(num_qubits + 1)

# Append state preparation part
extended_swap_test = extended_swap_test.compose(qc_ref, system_qubits)

# Prepare the coherent branch label, (|0> + |1>) / sqrt(2).
extended_swap_test.h(ancilla)

# Apply U(t) only to the |1> branch of the ancilla.
extended_swap_test.append(
    controlled_evolution_gate, [ancilla] + system_qubits
)

# Decompose once more for visualization so that control bullets are visible.
display(extended_swap_test.draw("mpl", fold=-1))

المرصودات
لأي مرصود هيرميتي للنظام ، نحدد هنا المرصودات المراد حسابها:
وذلك لأن يعطي عنصر التراكب ، بينما يعطي عنصر الهاميلتونية .
باستخدام ، لدينا
بالمثل، باستخدام ،
لذلك، لدينا
أخيرًا، لكل حالة ، نحتاج إلى قياس:
n_qubits = hamiltonian.num_qubits

observable_labels = [
    "Re S_0d",
    "Im S_0d",
    "Re H_0d",
    "Im H_0d",
]

# X ⊗ I and Y ⊗ I.
# Qiskit's Pauli-label convention places qubit 0 on the rightmost character,
# so the ancilla Pauli is appended to the right.
obs_x_identity = SparsePauliOp("I" * n_qubits + "X")
obs_y_identity = SparsePauliOp("I" * n_qubits + "Y")

# X ⊗ H and Y ⊗ H.
obs_x_hamiltonian = SparsePauliOp.from_list(
    [
        (label + "X", coeff)
        for label, coeff in zip(
            hamiltonian.paulis.to_labels(),
            hamiltonian.coeffs,
        )
    ]
)

obs_y_hamiltonian = SparsePauliOp.from_list(
    [
        (label + "Y", coeff)
        for label, coeff in zip(
            hamiltonian.paulis.to_labels(),
            hamiltonian.coeffs,
        )
    ]
)

observables = [
    obs_x_identity,
    obs_y_identity,
    obs_x_hamiltonian,
    obs_y_hamiltonian,
]

for obs, label in zip(observables, observable_labels):
    print(f"Observable: {label}")
    print(obs)
    print()
Observable: Re S_0d
SparsePauliOp(['IIIIIIIIIIIIX'],
              coeffs=[1.+0.j])

Observable: Im S_0d
SparsePauliOp(['IIIIIIIIIIIIY'],
              coeffs=[1.+0.j])

Observable: Re H_0d
SparsePauliOp(['IIIIIIIIIIXXX', 'IIIIIIIIIXXIX', 'IIIIIIIIXXIIX', 'IIIIIIIXXIIIX', 'IIIIIIXXIIIIX', 'IIIIIXXIIIIIX', 'IIIIXXIIIIIIX', 'IIIXXIIIIIIIX', 'IIXXIIIIIIIIX', 'IXXIIIIIIIIIX', 'XXIIIIIIIIIIX', 'IIIIIIIIIIYYX', 'IIIIIIIIIYYIX', 'IIIIIIIIYYIIX', 'IIIIIIIYYIIIX', 'IIIIIIYYIIIIX', 'IIIIIYYIIIIIX', 'IIIIYYIIIIIIX', 'IIIYYIIIIIIIX', 'IIYYIIIIIIIIX', 'IYYIIIIIIIIIX', 'YYIIIIIIIIIIX', 'IIIIIIIIIIZZX', 'IIIIIIIIIZZIX', 'IIIIIIIIZZIIX', 'IIIIIIIZZIIIX', 'IIIIIIZZIIIIX', 'IIIIIZZIIIIIX', 'IIIIZZIIIIIIX', 'IIIZZIIIIIIIX', 'IIZZIIIIIIIIX', 'IZZIIIIIIIIIX', 'ZZIIIIIIIIIIX'],
              coeffs=[1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j,
 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j,
 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j,
 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j])

Observable: Im H_0d
SparsePauliOp(['IIIIIIIIIIXXY', 'IIIIIIIIIXXIY', 'IIIIIIIIXXIIY', 'IIIIIIIXXIIIY', 'IIIIIIXXIIIIY', 'IIIIIXXIIIIIY', 'IIIIXXIIIIIIY', 'IIIXXIIIIIIIY', 'IIXXIIIIIIIIY', 'IXXIIIIIIIIIY', 'XXIIIIIIIIIIY', 'IIIIIIIIIIYYY', 'IIIIIIIIIYYIY', 'IIIIIIIIYYIIY', 'IIIIIIIYYIIIY', 'IIIIIIYYIIIIY', 'IIIIIYYIIIIIY', 'IIIIYYIIIIIIY', 'IIIYYIIIIIIIY', 'IIYYIIIIIIIIY', 'IYYIIIIIIIIIY', 'YYIIIIIIIIIIY', 'IIIIIIIIIIZZY', 'IIIIIIIIIZZIY', 'IIIIIIIIZZIIY', 'IIIIIIIZZIIIY', 'IIIIIIZZIIIIY', 'IIIIIZZIIIIIY', 'IIIIZZIIIIIIY', 'IIIZZIIIIIIIY', 'IIZZIIIIIIIIY', 'IZZIIIIIIIIIY', 'ZZIIIIIIIIIIY'],
              coeffs=[1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j,
 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j,
 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j,
 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j])
لتقدير عناصر مصفوفة ، عدد حدود باولي أكبر بكثير من عددها لعناصر مصفوفة .
يمكننا الآن تقليل عدد حدود الهاميلتونية المقاسة باستخدام تقنية الإزاحة [4]. نقسّم الهاميلتونية كالتالي:
حيث يُختار بحيث تكون الحالة المرجعية حالة ذاتية له،
Then,
Here,
هو عنصر مصفوفة الهاميلتونية المُزاح. لذلك، نحتاج فقط إلى قياس و . تُعاد إحداث مساهمة تقليديًا باستخدام عنصر مصفوفة التراكب المقاس سلفًا.
في هذا المثال، الاختيار الطبيعي هو الجزء القطري من هاميلتونية هايزنبرغ،
بما أن الحالة المرجعية هي حالة أساس حاسوبي، فهي حالة ذاتية لكل حد .
مع ذلك، هناك اختيار أكثر فائدة يتمثل في تضمين ليس فقط حدود القطرية، بل أيضًا حدود التي تُفني الحالة المرجعية.
لكل زوج متجاور، يحقق المؤثر
and
لذلك، يسهم حد فقط عندما يكون للكيوبتين المتجاورين إشغالان مختلفان في السلسلة الثنائية المرجعية. إذا كان الكيوبتان كلاهما أو كلاهما ، فإن الحد يُفني الحالة المرجعية ويمكن إزاحته أيضًا.
لتكن ، حيث . وبذلك، يمكننا اختيار
لا يزال هذا المؤثر يحقق
لأن حدود تعمل قطريًا على ، بينما تعطي حدود المُزاحة صفرًا. تُحدَّد القيمة الذاتية المقابلة إذن فقط بواسطة حدود ،
بهذا الاختيار، تصبح الهاميلتونية المُزاحة:
نتيجة لذلك، تحتاج فقط الحواف ذات الإشغالات المختلفة في الحالة المرجعية إلى القياس. تُعاد إحداث جميع حدود وجميع حدود غير الفعالة من خلال مساهمة التراكب ، أو تعطي مساهمة صفرية بحكم البناء.
هذا يعطي مرصودًا أصغر مقارنة بإزاحة الجزء القطري فقط. على وجه الخصوص، بالنسبة لحالة مرجعية من أساس حاسوبي بإثارة موضعية، تبقى فقط الحواف المجاورة للإثارة في . لذلك، يمكن تقليل عدد حدود باولي في و بشكل كبير، بينما عنصر المصفوفة المُعاد إحداثه
يظل كما هو تمامًا.
def make_reduced_heisenberg_observables(
    ref_bitstring: str,
    coupling: float = 1.0,
) -> tuple[SparsePauliOp, SparsePauliOp, float]:
    """Build X⊗(H-T), Y⊗(H-T), and tau."""
    n_qubits = len(ref_bitstring)

    shifted_terms: list[tuple[str, complex]] = []
    tau = 0.0

    def bit(q: int) -> str:
        return ref_bitstring[n_qubits - 1 - q]

    def append_term(q0: int, q1: int, pauli: str):
        label = ["I"] * n_qubits
        label[n_qubits - 1 - q0] = pauli[0]
        label[n_qubits - 1 - q1] = pauli[1]
        shifted_terms.append(("".join(label), coupling))

    for q in range(n_qubits - 1):
        same_occupation = bit(q) == bit(q + 1)

        # ZZ contribution to tau
        tau += coupling * (1.0 if same_occupation else -1.0)

        # XX + YY survives only for opposite occupations.
        if not same_occupation:
            append_term(q, q + 1, "XX")
            append_term(q, q + 1, "YY")

    if shifted_terms:
        obs_x_shifted_hamiltonian = SparsePauliOp.from_list(
            [(label + "X", coeff) for label, coeff in shifted_terms]
        )
        obs_y_shifted_hamiltonian = SparsePauliOp.from_list(
            [(label + "Y", coeff) for label, coeff in shifted_terms]
        )
    else:
        obs_x_shifted_hamiltonian = SparsePauliOp(
            "I" * n_qubits + "X", coeffs=[0.0]
        )
        obs_y_shifted_hamiltonian = SparsePauliOp(
            "I" * n_qubits + "Y", coeffs=[0.0]
        )

    return obs_x_shifted_hamiltonian, obs_y_shifted_hamiltonian, tau

obs_x_shifted_hamiltonian, obs_y_shifted_hamiltonian, shift_tau = (
    make_reduced_heisenberg_observables(ref_bitstring)
)

print("Observable: Re shifted H_0d")
print(obs_x_shifted_hamiltonian)
print()

print("Observable: Im shifted H_0d")
print(obs_y_shifted_hamiltonian)
print()

print("tau =", shift_tau)

observables = [
    obs_x_identity,
    obs_y_identity,
    obs_x_shifted_hamiltonian,
    obs_y_shifted_hamiltonian,
]
observable_labels = [
    "Re S_0d",
    "Im S_0d",
    "Re shifted H_0d",
    "Im shifted H_0d",
]
Observable: Re shifted H_0d
SparsePauliOp(['IIIIIXXIIIIIX', 'IIIIIYYIIIIIX', 'IIIIXXIIIIIIX', 'IIIIYYIIIIIIX'],
              coeffs=[1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j])

Observable: Im shifted H_0d
SparsePauliOp(['IIIIIXXIIIIIY', 'IIIIIYYIIIIIY', 'IIIIXXIIIIIIY', 'IIIIYYIIIIIIY'],
              coeffs=[1.+0.j, 1.+0.j, 1.+0.j, 1.+0.j])

tau = 7.0
الخطوة 2: تحسين المشكلة لتنفيذها على العتاد الكمي
الآن نحوّل دائرة اختبار التبديل الممتد المجردة إلى قالب موجه نحو العتاد. قبل ذلك، نُحسّن الدائرة أكثر على المستوى المجرد أولًا.
مقارنة ترتيب حدود الهاميلتونية
أولًا، نقارن بين ترتيبات مختلفة لحدود باولي في هاميلتونية هايزنبرغ لمحاكاة الهاميلتونية. الهاميلتونية نفسها لا تتغير، لكن الترتيب يؤثر على كيفية توليد دائرة الصيغة الجدائية ومدى إمكانية موازاة البنية في الدائرة. فعلى سبيل المثال، يسرد الترتيب الساذج جميع حدود للجوار الأقرب، ثم جميع حدود ، ثم جميع حدود . هذا يضع الحواف المتجاورة مثل و بجانب بعضها، بحيث لا يمكن تنفيذها بالتوازي. يزور الترتيب الزوجي-ثم-الفردي الحواف الزوجية المنفصلة أولًا، متبوعة بالحواف الفردية، مما يكشف طبقات ثنائية الكيوبت متوازية. يذهب الترتيب المجمّع حسب الحواف الزوجية-الفردية خطوة أبعد: لكل حافة، يبقي حدود و و المحلية معًا، مع الاستمرار في زيارة الحواف الزوجية قبل الفردية. نتوقع أن يقلل الترتيبان الزوجي-ثم-الفردي والمجمّع حسب الحواف الزوجية-الفردية عمق الدائرة من خلال كشف طبقات ثنائية الكيوبت المتوازية، وأن يقلل الترتيب المجمّع حسب الحواف بالإضافة إلى ذلك خطأ تروتر لأن التفاعل الثنائي الكيوبت المحلي على نفس الحافة يُعالج ككتلة مدمجة.
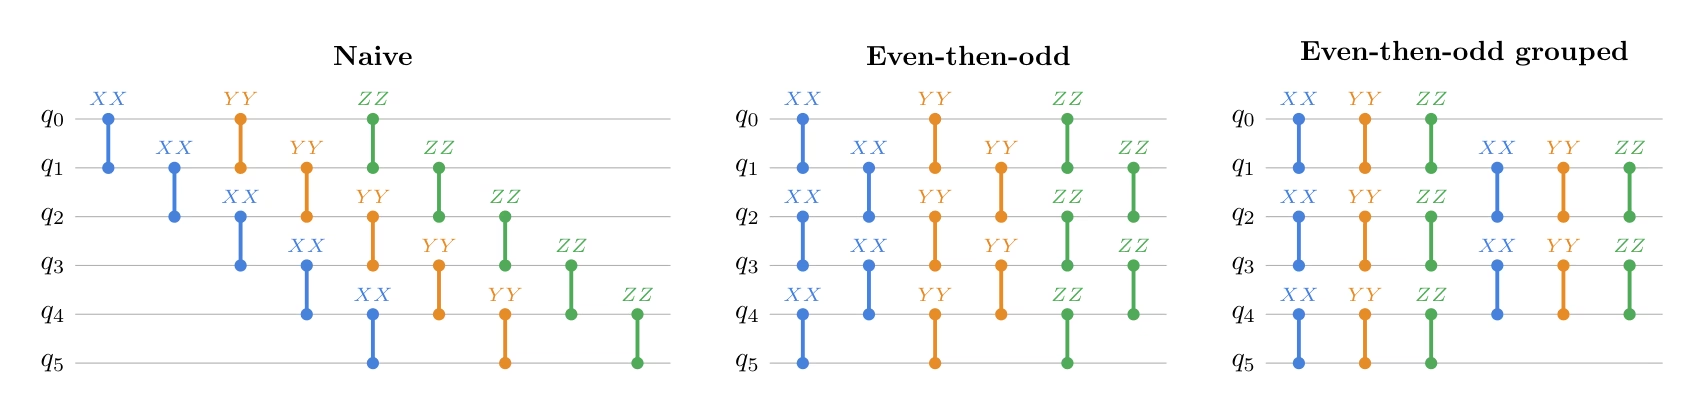
يؤثر ترتيب الهاميلتونية أيضًا على خطأ تروتر. إذا وضعنا حدودًا غير متبادلة بجانب بعضها، تحدث انتقالات الأساس بشكل أكثر تكرارًا، مما يسبب خطأ تروتر أكبر. من خلال تجميع الحدود التي تتطلب نفس تحويل أساس باولي، يمكن تجنب تغييرات الأساس الزائدة.
هنا، تستخدم المقارنة أكبر زمن تطور يظهر في تقديرات الصف الأول لكريلوف، باستخدام نفس شرط التحويل.
لقياس خطأ تروتر، نستخدم عدم إخلاص العملية بين الدائرة المُتروترة والتطور الدقيق للهاميلتونية،
where is the dimension of the Hilbert space.
يستخدم هذا التشخيص مصفوفات كثيفة، لذا فهو مناسب لهذا المثال الصغير المكون من 12 كيوبت لكنه ليس مقصودًا كإجراء فرعي قابل للتوسع.
# The comparison uses the largest time that appears in the first-row Krylov estimates.
# Circuit depth does not depend on this numeric value, but the Trotter error does.
comparison_time = (krylov_dim - 1) * dt

def make_heisenberg_hamiltonian_ordered(
    num_qubits: int,
    ordering: str,
    coupling: float = 1.0,
) -> SparsePauliOp:
    """Return the same Heisenberg Hamiltonian with a specified term ordering."""
    terms: list[tuple[str, complex]] = []
    even_edges = [(q, q + 1) for q in range(0, num_qubits - 1, 2)]
    odd_edges = [(q, q + 1) for q in range(1, num_qubits - 1, 2)]

    def append_term(q0: int, q1: int, pauli: str):
        label = ["I"] * num_qubits
        label[num_qubits - 1 - q0] = pauli[0]
        label[num_qubits - 1 - q1] = pauli[1]
        terms.append(("".join(label), coupling))

    if ordering == "naive":
        for pauli in ("XX", "YY", "ZZ"):
            for q in range(num_qubits - 1):
                append_term(q, q + 1, pauli)
    elif ordering == "even-then-odd":
        for pauli in ("XX", "YY", "ZZ"):
            for q0, q1 in even_edges + odd_edges:
                append_term(q0, q1, pauli)
    elif ordering == "even-odd edge-grouped":
        for q0, q1 in even_edges + odd_edges:
            for pauli in ("XX", "YY", "ZZ"):
                append_term(q0, q1, pauli)
    else:
        raise ValueError(f"Unknown ordering: {ordering}")

    return SparsePauliOp.from_list(terms).simplify()

def build_numeric_evolution_circuit(
    hamiltonian: SparsePauliOp,
    synthesis,
    time_value: float,
    **synthesis_kwargs,
) -> QuantumCircuit:
    """Build a numeric circuit for exp(-i H t) with a chosen synthesis rule."""
    evolution_gate = PauliEvolutionGate(
        hamiltonian,
        time=time_value,
        synthesis=synthesis(**synthesis_kwargs),
    )
    circuit = QuantumCircuit(hamiltonian.num_qubits)
    circuit.append(evolution_gate, range(hamiltonian.num_qubits))
    return circuit

def process_infidelity(
    circuit: QuantumCircuit,
    exact_matrix: np.ndarray,
) -> float:
    """Return 1 - |Tr(U_circuit† U_exact) / d|²."""
    circuit_matrix = np.asarray(Operator(circuit).data)
    dim = circuit_matrix.shape[0]
    normalized_trace = np.vdot(circuit_matrix, exact_matrix) / dim
    fidelity = np.abs(normalized_trace) ** 2
    return float(np.clip(1.0 - fidelity, 0.0, 1.0))

hamiltonians_by_ordering = {
    ordering: make_heisenberg_hamiltonian_ordered(
        num_qubits, ordering, coupling=1.0
    )
    for ordering in ["naive", "even-then-odd", "even-odd edge-grouped"]
}

print(f"Comparison time: {comparison_time}\n")

for order_name, ham_ordered in hamiltonians_by_ordering.items():
    print(f"{order_name}:")
    print([op for op, _ in ham_ordered.to_list()])
    print()

print("Precomputing the exact evolution operator... ", end="")
exact_matrix = la.expm(-1j * comparison_time * hamiltonian.to_matrix())
print("Done")
Comparison time: 0.8567979964335799

naive:
['IIIIIIIIIIXX', 'IIIIIIIIIXXI', 'IIIIIIIIXXII', 'IIIIIIIXXIII', 'IIIIIIXXIIII', 'IIIIIXXIIIII', 'IIIIXXIIIIII', 'IIIXXIIIIIII', 'IIXXIIIIIIII', 'IXXIIIIIIIII', 'XXIIIIIIIIII', 'IIIIIIIIIIYY', 'IIIIIIIIIYYI', 'IIIIIIIIYYII', 'IIIIIIIYYIII', 'IIIIIIYYIIII', 'IIIIIYYIIIII', 'IIIIYYIIIIII', 'IIIYYIIIIIII', 'IIYYIIIIIIII', 'IYYIIIIIIIII', 'YYIIIIIIIIII', 'IIIIIIIIIIZZ', 'IIIIIIIIIZZI', 'IIIIIIIIZZII', 'IIIIIIIZZIII', 'IIIIIIZZIIII', 'IIIIIZZIIIII', 'IIIIZZIIIIII', 'IIIZZIIIIIII', 'IIZZIIIIIIII', 'IZZIIIIIIIII', 'ZZIIIIIIIIII']

even-then-odd:
['IIIIIIIIIIXX', 'IIIIIIIIXXII', 'IIIIIIXXIIII', 'IIIIXXIIIIII', 'IIXXIIIIIIII', 'XXIIIIIIIIII', 'IIIIIIIIIXXI', 'IIIIIIIXXIII', 'IIIIIXXIIIII', 'IIIXXIIIIIII', 'IXXIIIIIIIII', 'IIIIIIIIIIYY', 'IIIIIIIIYYII', 'IIIIIIYYIIII', 'IIIIYYIIIIII', 'IIYYIIIIIIII', 'YYIIIIIIIIII', 'IIIIIIIIIYYI', 'IIIIIIIYYIII', 'IIIIIYYIIIII', 'IIIYYIIIIIII', 'IYYIIIIIIIII', 'IIIIIIIIIIZZ', 'IIIIIIIIZZII', 'IIIIIIZZIIII', 'IIIIZZIIIIII', 'IIZZIIIIIIII', 'ZZIIIIIIIIII', 'IIIIIIIIIZZI', 'IIIIIIIZZIII', 'IIIIIZZIIIII', 'IIIZZIIIIIII', 'IZZIIIIIIIII']

even-odd edge-grouped:
['IIIIIIIIIIXX', 'IIIIIIIIIIYY', 'IIIIIIIIIIZZ', 'IIIIIIIIXXII', 'IIIIIIIIYYII', 'IIIIIIIIZZII', 'IIIIIIXXIIII', 'IIIIIIYYIIII', 'IIIIIIZZIIII', 'IIIIXXIIIIII', 'IIIIYYIIIIII', 'IIIIZZIIIIII', 'IIXXIIIIIIII', 'IIYYIIIIIIII', 'IIZZIIIIIIII', 'XXIIIIIIIIII', 'YYIIIIIIIIII', 'ZZIIIIIIIIII', 'IIIIIIIIIXXI', 'IIIIIIIIIYYI', 'IIIIIIIIIZZI', 'IIIIIIIXXIII', 'IIIIIIIYYIII', 'IIIIIIIZZIII', 'IIIIIXXIIIII', 'IIIIIYYIIIII', 'IIIIIZZIIIII', 'IIIXXIIIIIII', 'IIIYYIIIIIII', 'IIIZZIIIIIII', 'IXXIIIIIIIII', 'IYYIIIIIIIII', 'IZZIIIIIIIII']

Precomputing the exact evolution operator... Done
نبقي أولًا قاعدة التركيب ثابتة عند خطوة تروتر واحدة من الرتبة الأولى ونغيّر فقط ترتيب حدود باولي. هدف هذه المقارنة بشكل رئيسي هو معرفة مقدار عمق الدائرة وتكلفة البوابات الثنائية الكيوبت التي يمكن تقليلها عن طريق كشف الحواف المنفصلة للجوار الأقرب للمحوّل.
ordering_comparison_rows = []
infidelity_reps = [1, 2, 4, 8]

for ordering, ham_ordered in hamiltonians_by_ordering.items():
    for reps in infidelity_reps:
        circuit = build_numeric_evolution_circuit(
            ham_ordered,
            LieTrotter,
            comparison_time,
            reps=reps,
        )
        decomposed_circuit = simple_transpilation(circuit)
        infidelity = process_infidelity(decomposed_circuit, exact_matrix)
        ordering_comparison_rows.append(
            {
                "ordering": ordering,
                "synthesis": f"LieTrotter(reps={reps})",
                "infidelity": infidelity,
                **summarize_circuit(decomposed_circuit),
            }
        )
        if reps == 1:
            print(f"Circuit for {ordering} ordering:")
            print([op for op, _ in ham_ordered.to_list()])
            display(decomposed_circuit.draw("mpl", fold=-1, scale=0.6))

ordering_comparison_df = pd.DataFrame(ordering_comparison_rows)
display(ordering_comparison_df)

hamiltonian_for_synthesis = hamiltonians_by_ordering["even-odd edge-grouped"]
Circuit for naive ordering:
['IIIIIIIIIIXX', 'IIIIIIIIIXXI', 'IIIIIIIIXXII', 'IIIIIIIXXIII', 'IIIIIIXXIIII', 'IIIIIXXIIIII', 'IIIIXXIIIIII', 'IIIXXIIIIIII', 'IIXXIIIIIIII', 'IXXIIIIIIIII', 'XXIIIIIIIIII', 'IIIIIIIIIIYY', 'IIIIIIIIIYYI', 'IIIIIIIIYYII', 'IIIIIIIYYIII', 'IIIIIIYYIIII', 'IIIIIYYIIIII', 'IIIIYYIIIIII', 'IIIYYIIIIIII', 'IIYYIIIIIIII', 'IYYIIIIIIIII', 'YYIIIIIIIIII', 'IIIIIIIIIIZZ', 'IIIIIIIIIZZI', 'IIIIIIIIZZII', 'IIIIIIIZZIII', 'IIIIIIZZIIII', 'IIIIIZZIIIII', 'IIIIZZIIIIII', 'IIIZZIIIIIII', 'IIZZIIIIIIII', 'IZZIIIIIIIII', 'ZZIIIIIIIIII']

Circuit for even-then-odd ordering:
['IIIIIIIIIIXX', 'IIIIIIIIXXII', 'IIIIIIXXIIII', 'IIIIXXIIIIII', 'IIXXIIIIIIII', 'XXIIIIIIIIII', 'IIIIIIIIIXXI', 'IIIIIIIXXIII', 'IIIIIXXIIIII', 'IIIXXIIIIIII', 'IXXIIIIIIIII', 'IIIIIIIIIIYY', 'IIIIIIIIYYII', 'IIIIIIYYIIII', 'IIIIYYIIIIII', 'IIYYIIIIIIII', 'YYIIIIIIIIII', 'IIIIIIIIIYYI', 'IIIIIIIYYIII', 'IIIIIYYIIIII', 'IIIYYIIIIIII', 'IYYIIIIIIIII', 'IIIIIIIIIIZZ', 'IIIIIIIIZZII', 'IIIIIIZZIIII', 'IIIIZZIIIIII', 'IIZZIIIIIIII', 'ZZIIIIIIIIII', 'IIIIIIIIIZZI', 'IIIIIIIZZIII', 'IIIIIZZIIIII', 'IIIZZIIIIIII', 'IZZIIIIIIIII']

Circuit for even-odd edge-grouped ordering:
['IIIIIIIIIIXX', 'IIIIIIIIIIYY', 'IIIIIIIIIIZZ', 'IIIIIIIIXXII', 'IIIIIIIIYYII', 'IIIIIIIIZZII', 'IIIIIIXXIIII', 'IIIIIIYYIIII', 'IIIIIIZZIIII', 'IIIIXXIIIIII', 'IIIIYYIIIIII', 'IIIIZZIIIIII', 'IIXXIIIIIIII', 'IIYYIIIIIIII', 'IIZZIIIIIIII', 'XXIIIIIIIIII', 'YYIIIIIIIIII', 'ZZIIIIIIIIII', 'IIIIIIIIIXXI', 'IIIIIIIIIYYI', 'IIIIIIIIIZZI', 'IIIIIIIXXIII', 'IIIIIIIYYIII', 'IIIIIIIZZIII', 'IIIIIXXIIIII', 'IIIIIYYIIIII', 'IIIIIZZIIIII', 'IIIXXIIIIIII', 'IIIYYIIIIIII', 'IIIZZIIIIIII', 'IXXIIIIIIIII', 'IYYIIIIIIIII', 'IZZIIIIIIIII']

ordering           synthesis  infidelity  depth  size  \
0                   naive  LieTrotter(reps=1)    0.999917     15    33
1                   naive  LieTrotter(reps=2)    0.805998     21    66
2                   naive  LieTrotter(reps=4)    0.271389     33   132
3                   naive  LieTrotter(reps=8)    0.074590     57   264
4           even-then-odd  LieTrotter(reps=1)    0.999917      6    33
5           even-then-odd  LieTrotter(reps=2)    0.805998     12    66
6           even-then-odd  LieTrotter(reps=4)    0.271389     24   132
7           even-then-odd  LieTrotter(reps=8)    0.074590     48   264
8   even-odd edge-grouped  LieTrotter(reps=1)    0.998432      6    33
9   even-odd edge-grouped  LieTrotter(reps=2)    0.653843     12    66
10  even-odd edge-grouped  LieTrotter(reps=4)    0.181529     24   132
11  even-odd edge-grouped  LieTrotter(reps=8)    0.045244     48   264

    2q gates  2q depth
0         33        15
1         66        21
2        132        33
3        264        57
4         33         6
5         66        12
6        132        24
7        264        48
8         33         6
9         66        12
10       132        24
11       264        48
عند reps=1، نلاحظ أن كلا الترتيبين الزوجي-ثم-الفردي والمجمّع حسب الحواف الزوجية-الفردية يقلصان العمق من 15 إلى 6 عن طريق كشف طبقات ثنائية الكيوبت المتوازية، بينما يبقى عدد البوابات الثنائية الكيوبت ثابتًا عبر الترتيبات الثلاثة جميعًا.
ومع ذلك، فإن الترتيبات الثلاثة جميعًا لها عدم إخلاص قريب من 1، لذا نمسح عدد تكرارات تروتر لفصل الترتيبات بشكل أوضح.
مع نمو عدد التكرارات، ينخفض عدم إخلاص الترتيب even-odd edge-grouped أسرع من الترتيبين الآخرين، ليصل إلى 0.045 عند reps=8 مقابل 0.075 للترتيب الساذج والترتيب الزوجي-ثم-الفردي.
مقارنة تركيب الصيغة الجدائية
بعد ذلك، نستكشف إعدادات متقدمة مختلفة لتروترة، مع تثبيت ترتيب الهاميلتونية عند الترتيب المجمّع حسب الحواف الزوجية-الفردية. نعتبر تروتر لي من الرتبة الأولى، وتروتر سوزوكي من الرتبة الثانية، وتروتر سوزوكي من الرتبة الرابعة.
synthesis_comparison_rows = []

for num_trotter_steps in [1, 2, 3, 4, 5]:
    synthesis_cases = [
        ("LieTrotter", LieTrotter, {"reps": num_trotter_steps}),
        (
            "SuzukiTrotter(order=2)",
            SuzukiTrotter,
            {"order": 2, "reps": num_trotter_steps},
        ),
        (
            "SuzukiTrotter(order=4)",
            SuzukiTrotter,
            {"order": 4, "reps": num_trotter_steps},
        ),
    ]
    for label, synthesis, kwargs in synthesis_cases:
        circuit = build_numeric_evolution_circuit(
            hamiltonian_for_synthesis,
            synthesis,
            comparison_time,
            **kwargs,
        )
        decomposed_circuit = simple_transpilation(circuit)
        synthesis_comparison_rows.append(
            {
                "synthesis": label,
                "reps": kwargs["reps"],
                "infidelity": process_infidelity(
                    decomposed_circuit, exact_matrix
                ),
                **summarize_circuit(decomposed_circuit),
            }
        )

synthesis_comparison_df = pd.DataFrame(synthesis_comparison_rows)
display(synthesis_comparison_df.sort_values(["2q gates", "2q depth"]))

# For memory free
exact_matrix = None
synthesis  reps    infidelity  depth  size  2q gates  \
0               LieTrotter     1  9.984324e-01      6    33        33
1   SuzukiTrotter(order=2)     1  9.733399e-01      9    51        51
3               LieTrotter     2  6.538427e-01     12    66        66
4   SuzukiTrotter(order=2)     2  2.522533e-01     15    84        84
6               LieTrotter     3  3.197242e-01     18    99        99
7   SuzukiTrotter(order=2)     3  4.804050e-02     21   117       117
9               LieTrotter     4  1.815291e-01     24   132       132
10  SuzukiTrotter(order=2)     4  1.453103e-02     27   150       150
12              LieTrotter     5  1.161770e-01     30   165       165
2   SuzukiTrotter(order=4)     1  2.884402e-01     33   183       183
13  SuzukiTrotter(order=2)     5  5.803455e-03     33   183       183
5   SuzukiTrotter(order=4)     2  1.641162e-03     63   348       348
8   SuzukiTrotter(order=4)     3  2.907076e-05     93   513       513
11  SuzukiTrotter(order=4)     4  2.791061e-06    123   678       678
14  SuzukiTrotter(order=4)     5  4.736685e-07    153   843       843

    2q depth
0          6
1          9
3         12
4         15
6         18
7         21
9         24
10        27
12        30
2         33
13        33
5         63
8         93
11       123
14       153
يعطي تروتر لي الدائرة الأقل عمقًا لكن به أكبر خطأ، بينما يكون تروتر سوزوكي من الرتبة الرابعة أكثر دقة لكنه يزيد من عمق الدائرة. لبقية هذا الدرس التعليمي، نختار تروتر سوزوكي من الرتبة الثانية لأنه يعطي دائرة قليلة العمق مع تقليل خطأ تروتر بشكل كبير مقارنة بالصيغة من الرتبة الأولى.
إزالة بوابة التطور الزمني المتحكم بها
في اختبار التبديل الممتد، يتطلب التحكم في التطور الزمني بكيوبت مساعد واحد أن يتحكم هذا الكيوبت المساعد في العديد من البوابات عبر النظام. يمكن أن يُدخل هذا عبئًا كبيرًا في التوجيه، وفي أسوأ الحالات، يتطلب فعليًا اتصالًا من الكل إلى واحد. لتجنب ذلك، يمكن إجراء تحسين إضافي عن طريق استبدال بوابة التطور الزمني المتحكم بها بنسخة خالية من التحكم، مستغلين تناظر الهاميلتونية. لنلاحظ الدائرة التالية.
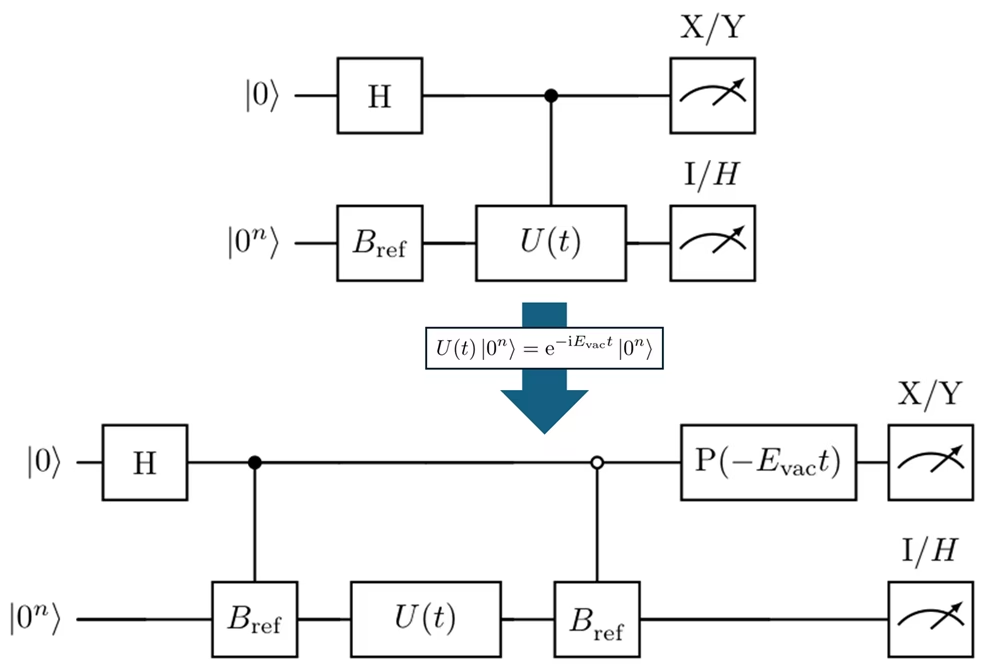
هنا، يُحضّر الحالة المرجعية، .
بدلًا من تحضير أولًا ثم تطبيق فقط على فرع ، تُحضّر الدائرة مباشرة الفرعين كـ
where
تُطبّق الدائرة أولًا بوابة هادامارد على الحالة المساعدة وتُحضّر الحالة المرجعية فقط على فرع :
بعد ذلك، يُطبّق مؤثر التطور الزمني غير المتحكم به على كلا الفرعين:
بما أن الهاميلتونية تحافظ على عدد الإثارات، يمكننا أن نرى أن هي حالتها الذاتية، وبالتالي يراكم مؤثر التطور طورًا فقط تحت الهاميلتونية:
Therefore,
بعد ذلك، يُطبّق فقط على فرع .
في هذه المرحلة، يكون للفرعين طور نسبي إضافي. لإزالته، نطبّق بوابة طور الحالة المساعدة
يحوّل هذا الحالة إلى
وبذلك، وحتى طور كلي غير ذي صلة، نكون قد حضّرنا أخيرًا
في كتلة الشيفرة التالية، نطبّق هذه الدائرة الخالية من التحكم.
controlled_extended_swap_test = extended_swap_test

# Reuse the ordering and synthesis rule selected by the comparison above.
evol_gate_optimized = PauliEvolutionGate(
    hamiltonian_for_synthesis,
    time=t,
    synthesis=SuzukiTrotter(order=2, reps=num_trotter_steps),
)

uncontrolled_evolution = QuantumCircuit(num_qubits, name="U_ST2(t)")
uncontrolled_evolution.append(evol_gate_optimized, range(num_qubits))

controlled_state_prep = QuantumCircuit(num_qubits + 1, name="C-Prep")
for q, bit in enumerate(reversed(ref_bitstring)):
    if bit == "1":
        controlled_state_prep.cx(ancilla, system_qubits[q])

vacuum_bitstring = "0" * num_qubits
vacuum_energy = basis_state_expectation_sparse(hamiltonian, "0" * num_qubits)

optimized_extended_swap_test = QuantumCircuit(num_qubits + 1)
optimized_extended_swap_test.h(ancilla)

# Prepare |psi_ref> only on the |1> branch.
optimized_extended_swap_test.compose(controlled_state_prep, inplace=True)
optimized_extended_swap_test.barrier()

# Apply the Trotterized time evolution without control.
optimized_extended_swap_test.compose(
    uncontrolled_evolution,
    qubits=system_qubits,
    inplace=True,
)
optimized_extended_swap_test.barrier()

# Map |0>|0...0> to |0>|psi_ref>, leaving the |1> branch unchanged.
optimized_extended_swap_test.x(ancilla)
optimized_extended_swap_test.compose(controlled_state_prep, inplace=True)
optimized_extended_swap_test.x(ancilla)

# Cancel the known vacuum phase so that the same X/Y observables can be used.
optimized_extended_swap_test.p(-vacuum_energy * t, ancilla)
optimized_extended_swap_test = simple_transpilation(
    optimized_extended_swap_test
)

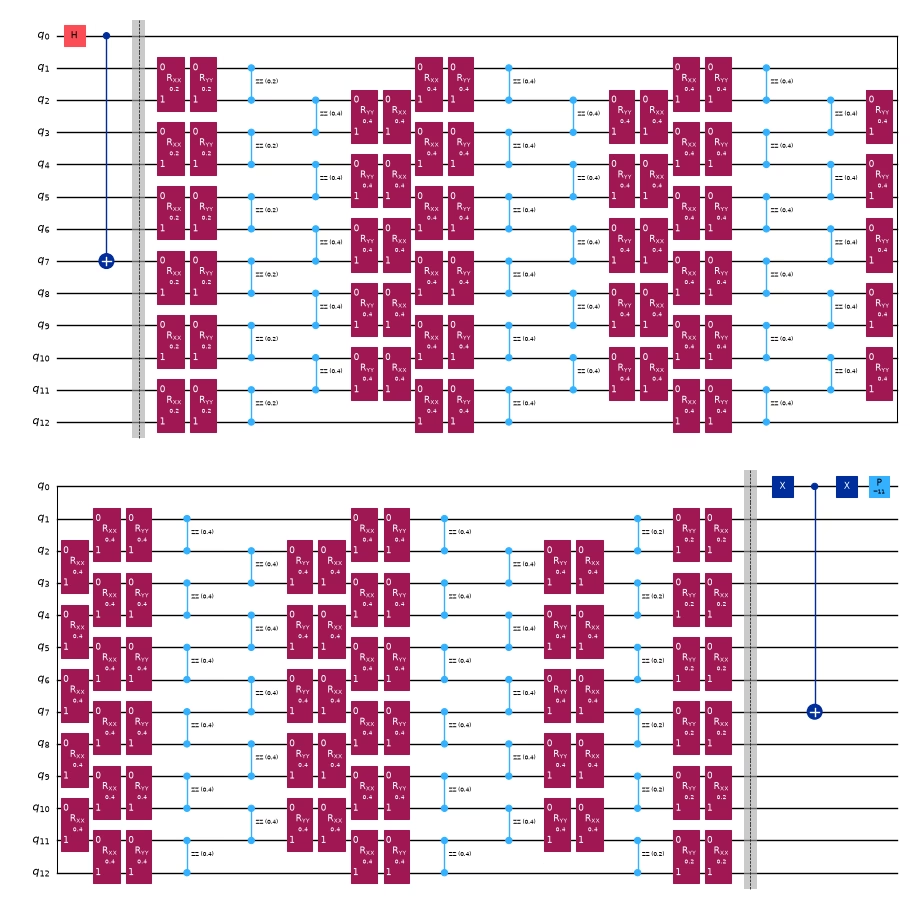
print(f"Vacuum energy E_vac = {vacuum_energy:.1f}")
display(
    optimized_extended_swap_test.assign_parameters({t: 1.0}).draw(
        "mpl", scale=0.5, fold=26
    )
)
Vacuum energy E_vac = 11.0+0.0j
التحويل
الآن، نحوّل الدائرتين المتحكم بها والخالية من التحكم لتصبحا قابلتين للتنفيذ على العتاد. لنقارن نتيجة الدوائر المحوَّلة.
pass_manager = generate_preset_pass_manager(
    backend=backend,
    optimization_level=3,
)

isa_controlled_extended_swap_test = pass_manager.run(
    controlled_extended_swap_test
)

pass_manager = generate_preset_pass_manager(
    backend=backend, optimization_level=3, routing_method="none"
)
isa_optimized_extended_swap_test = pass_manager.run(
    optimized_extended_swap_test
)

transpilation_result = [
    {
        "label": "abstract controlled U(t)",
        **summarize_circuit(isa_controlled_extended_swap_test),
    },
    {
        "label": "optimized non-controlled U(t)",
        **summarize_circuit(isa_optimized_extended_swap_test),
    },
]

display(pd.DataFrame(transpilation_result))

def filter_qubits_from_layout(layout):
    q_layout = Layout(
        {
            physical: virtual
            for physical, virtual in layout.get_physical_bits().items()
            if virtual._register.name == "q"
        }
    )
    return q_layout

print(
    filter_qubits_from_layout(
        isa_optimized_extended_swap_test.layout.initial_layout
    )
)

isa_observables = [
    op.apply_layout(isa_optimized_extended_swap_test.layout)
    for op in observables
]
label  depth   size  2q gates  2q depth
0       abstract controlled U(t)  15457  23786      4686      4580
1  optimized non-controlled U(t)    261   1716       307        57
Layout({
18: <Qubit register=(13, "q"), index=0>,
5: <Qubit register=(13, "q"), index=1>,
6: <Qubit register=(13, "q"), index=2>,
7: <Qubit register=(13, "q"), index=3>,
8: <Qubit register=(13, "q"), index=4>,
9: <Qubit register=(13, "q"), index=5>,
10: <Qubit register=(13, "q"), index=6>,
11: <Qubit register=(13, "q"), index=7>,
12: <Qubit register=(13, "q"), index=8>,
13: <Qubit register=(13, "q"), index=9>,
14: <Qubit register=(13, "q"), index=10>,
15: <Qubit register=(13, "q"), index=11>,
19: <Qubit register=(13, "q"), index=12>
})
الخطوة 3: التنفيذ باستخدام أوليات Qiskit
الخطوة التالية هي إرسال نفس الدائرة المعلمنة لعدة قيم لـ . لكل ، نقدّر أربع قيم توقع: ، ، ، و . تُدمج هذه الأرقام الأربعة بعد ذلك في عناصر الصف الأول المركّبة و .
هنا، و يمكن حسابهما تقليديًا لأن متناثرة، لذا نتخطى حالة .
pub_list = []
d_values = list(range(1, krylov_dim))

# Exact local statevector estimator.
estimator = StatevectorEstimator()

# We use the circuit before the transpilation for the local simulator,
# but we will use the transpiled circuit for the real backend.
for d in d_values:
    parameter_values = [d * dt]

    for ob in observables:
        pub_list.append(
            (
                optimized_extended_swap_test,
                ob,
                parameter_values,
            )
        )

job = estimator.run(pub_list)

# Local PrimitiveJob does not provide Runtime-style job inputs,
# so preserve the inputs directly.
inputs = pub_list
result = job.result()

print(f"Number of Krylov basis states: r = {len(d_values)}")
print(f"Number of PUBs: {len(pub_list)}")
print(f"Each d uses observables: {observable_labels}")
Number of Krylov basis states: r = 9
Number of PUBs: 36
Each d uses observables: ['Re S_0d', 'Im S_0d', 'Re shifted H_0d', 'Im shifted H_0d']
الخطوة 4: المعالجة اللاحقة وإرجاع النتيجة بالصيغة الكلاسيكية المطلوبة
بعد تقدير المصفوفات المسقَطة، نُنظّم ونحل مسألة GEVP
تعطي أصغر قيمة ذاتية معمّمة تقدير KQD لطاقة الحالة الأرضية.
h_shifted_row_est = np.zeros(krylov_dim, dtype=complex)
s_row_est = np.zeros(krylov_dim, dtype=complex)

h_shifted_row_est[0] = ref_energy - shift_tau
s_row_est[0] = 1.0

for idx, (pub_input, pub_result) in enumerate(zip(inputs, result)):
    d_index, obs_index = divmod(idx, len(observables))
    ev = np.asarray(pub_result.data.evs).reshape(-1)[0]
    std = np.asarray(pub_result.data.stds).reshape(-1)[0]

    if obs_index == 0:
        s_row_est[d_index + 1] = ev
    elif obs_index == 1:
        s_row_est[d_index + 1] += 1j * ev
    elif obs_index == 2:
        h_shifted_row_est[d_index + 1] = ev
    elif obs_index == 3:
        h_shifted_row_est[d_index + 1] += 1j * ev

# H_0d = shifted_H_0d + tau * S_0d.
h_row_est = h_shifted_row_est + shift_tau * s_row_est

h_matrix_est = la.toeplitz(h_row_est.conj(), h_row_est)
s_matrix_est = la.toeplitz(s_row_est.conj(), s_row_est)

s_eigvals = la.eigvalsh(0.5 * (s_matrix_est + s_matrix_est.conj().T))
positive_s_eigvals = s_eigvals[s_eigvals > 1e-12]
s_condition_number = (
    positive_s_eigvals[-1] / positive_s_eigvals[0]
    if len(positive_s_eigvals) > 0
    else np.inf
)

with np.printoptions(precision=3, suppress=True):
    print("Estimated first row of S:")
    print(s_row_est)
    print()
    print("Estimated first row of H:")
    print(h_row_est)
    print()
    print("Eigenvalues of the estimated overlap matrix S:")
    print(s_eigvals)
    print(f"Condition number above 1e-12: {s_condition_number:.3e}")
    print()
Estimated first row of S:
[ 1.   +0.j     0.758-0.596j  0.203-0.836j -0.291-0.636j -0.444-0.229j
 -0.276+0.053j -0.044+0.051j  0.006-0.121j -0.155-0.218j -0.345-0.101j]

Estimated first row of H:
[ 7.   +0.j     4.842-4.76j   0.044-6.185j -3.791-3.653j -4.137+0.39j
 -1.495+2.654j  1.331+1.777j  1.85 -0.763j -0.032-2.278j -2.222-1.372j]

Eigenvalues of the estimated overlap matrix S:
[-0.     0.     0.     0.     0.     0.     0.01   0.355  3.526  6.109]
Condition number above 1e-12: 1.904e+12
الآن نحل مسألة القيم الذاتية المعمّمة باستخدام المصفوفات المُعاد بناؤها من تقديرات الدائرة. في حساب متجه حالة مثالي مع تطور زمني حقيقي دقيق، ينبغي أن يُعيد هذا إنتاج النتيجة المسقَطة الدقيقة. من الناحية العملية، يمكن أن تأتي الانحرافات من تروترة، وخطأ أخذ العينات، وعدم استقرار عددي في مصفوفة التراكب.
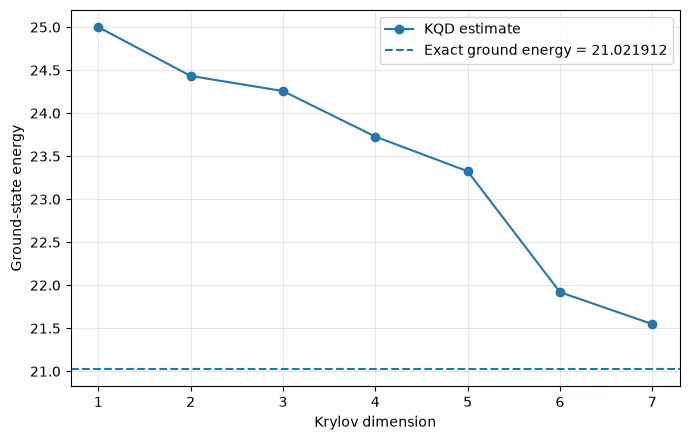
نلاحظ كيف تتقارب الطاقة مع زيادة بُعد فضاء كريلوف.
exact_evals = diagonalize_single_1_subspace(hamiltonian)
exact_ground = min(exact_evals)
print("exact ground state energy:  ", exact_ground)

threshold = 1e-12
energy_convergence = []

for r in range(1, krylov_dim + 1):
    energy_est_kqd, coeffs_est, retained_est = solve_thresholded_gevp(
        h_matrix_est[:r, :r],
        s_matrix_est[:r, :r],
        threshold=threshold,
    )
    energy_convergence.append(energy_est_kqd)
    print(
        f"Krylov ground state energy (dim={r}, retained={retained_est}): ",
        energy_est_kqd,
    )
exact ground state energy:   3.136296694843727
Krylov ground state energy (dim=1, retained=1):  7.0
Krylov ground state energy (dim=2, retained=2):  4.184510657551266
Krylov ground state energy (dim=3, retained=3):  3.5539074630394136
Krylov ground state energy (dim=4, retained=4):  3.3366270761341044
Krylov ground state energy (dim=5, retained=5):  3.252017453225087
Krylov ground state energy (dim=6, retained=6):  3.2300275138879186
Krylov ground state energy (dim=7, retained=7):  3.2299154099085685
Krylov ground state energy (dim=8, retained=7):  3.2298063744216776
Krylov ground state energy (dim=9, retained=7):  3.2296778282872456
Krylov ground state energy (dim=10, retained=8):  3.223647515867734
def plot_energy_convergence(energy_convergence, exact_ground, krylov_dim):
    fig, ax = plt.subplots(figsize=(7, 4.5))

    ax.plot(
        range(1, krylov_dim + 1),
        energy_convergence,
        marker="o",
        label="KQD estimate",
    )

    ax.axhline(
        exact_ground,
        linestyle="--",
        label=f"Exact ground energy = {exact_ground:.6f}",
    )

    ax.set_xlabel("Krylov dimension")
    ax.set_ylabel("Ground-state energy")
    ax.grid(True, alpha=0.3)
    ax.legend()
    plt.tight_layout()
    plt.show()

plot_energy_convergence(energy_convergence, exact_ground, krylov_dim)

مثال على عتاد كبير النطاق
استخدم القسم السابق نموذجًا من 12 كيوبت بحيث يمكن استخدام محاكاة متجه الحالة كأداة تشخيصية. نُوسّع الآن نفس سير عمل KQD إلى سلسلة هايزنبرغ من 30 كيوبت ونُحضّر حمل العمل للتنفيذ على عتاد IBM Quantum.
ضغط الخطوات 1-4 في كتلة شيفرة واحدة
هنا نضع الآن كل هذه التفاصيل معًا في سير عمل واحد على نطاق أكبر، يُشغَّل بعد ذلك على عتادنا الكمومي الحقيقي. في هذا القسم، نطبّق إعدادات واقعية للتخفيف من الأخطاء لتحسين موثوقية النتائج. بما أن عناصر المصفوفة المقابلة لقيم مختلفة من يمكن تقييمها بالتوازي، نستخدم وضع Batch لتنفيذها بكفاءة.
# -------------------------Step 1-------------------------

# Map the classical problem to quantum circuits and observables.
# Problem and KQD parameters.
large_num_qubits = 30
large_krylov_dim = 7
large_num_trotter_steps = 3
large_dt = np.pi / (3 * (large_num_qubits - 1))
large_t = Parameter("t_large")

# Use a single excitation near the center of the chain.
large_excitation_qubit = large_num_qubits // 2
large_ref_label = ["0"] * large_num_qubits
large_ref_label[large_num_qubits - 1 - large_excitation_qubit] = "1"
large_ref_bitstring = "".join(large_ref_label)

# Use the ordering and product formula selected in the preceding section.
large_hamiltonian = make_heisenberg_hamiltonian_ordered(
    large_num_qubits,
    ordering="even-odd edge-grouped",
    coupling=1.0,
)
large_ref_energy = float(
    np.real(
        basis_state_expectation_sparse(large_hamiltonian, large_ref_bitstring)
    )
)
large_vacuum_energy = float(
    np.real(
        basis_state_expectation_sparse(
            large_hamiltonian, "0" * large_num_qubits
        )
    )
)

large_evolution_gate = PauliEvolutionGate(
    large_hamiltonian,
    time=large_t,
    synthesis=SuzukiTrotter(order=2, reps=large_num_trotter_steps),
)
large_uncontrolled_evolution = QuantumCircuit(
    large_num_qubits,
    name="U_ST2_large(t)",
)
large_uncontrolled_evolution.append(
    large_evolution_gate,
    range(large_num_qubits),
)

# Build the control-free extended-swap-test circuit.
large_ancilla = 0
large_system_qubits = list(range(1, large_num_qubits + 1))

large_controlled_state_prep = QuantumCircuit(
    large_num_qubits + 1,
    name="C-Prep-large",
)
large_controlled_state_prep.cx(
    large_ancilla,
    large_system_qubits[large_excitation_qubit],
)

large_extended_swap_test = QuantumCircuit(large_num_qubits + 1)
large_extended_swap_test.h(large_ancilla)
large_extended_swap_test.compose(large_controlled_state_prep, inplace=True)
large_extended_swap_test.compose(
    large_uncontrolled_evolution,
    qubits=large_system_qubits,
    inplace=True,
)
large_extended_swap_test.x(large_ancilla)
large_extended_swap_test.compose(
    large_controlled_state_prep.inverse(),
    inplace=True,
)
large_extended_swap_test.x(large_ancilla)
large_extended_swap_test.p(
    -large_vacuum_energy * large_t,
    large_ancilla,
)

# Reuse the Hamiltonian-shifting construction from the preceding section.
(
    large_obs_x_shifted_hamiltonian,
    large_obs_y_shifted_hamiltonian,
    large_shift_tau,
) = make_reduced_heisenberg_observables(large_ref_bitstring)

large_observables = [
    SparsePauliOp("I" * large_num_qubits + "X"),
    SparsePauliOp("I" * large_num_qubits + "Y"),
    large_obs_x_shifted_hamiltonian,
    large_obs_y_shifted_hamiltonian,
]
large_observable_labels = [
    "Re S_0d",
    "Im S_0d",
    "Re shifted H_0d",
    "Im shifted H_0d",
]

# -------------------------Step 2-------------------------

# Optimize the problem for quantum execution.
# Select a real backend and transpile the parameterized circuit to ISA form.
large_backend = service.backend("ibm_boston")
large_pass_manager = generate_preset_pass_manager(
    backend=large_backend, optimization_level=3, routing_method="none"
)
large_isa_circuit = large_pass_manager.run(large_extended_swap_test)
large_isa_observables = [
    observable.apply_layout(large_isa_circuit.layout)
    for observable in large_observables
]

large_two_qubit_gate_count = sum(
    instruction.operation.num_qubits == 2
    for instruction in large_isa_circuit.data
)

print(f"Backend: {large_backend.name}")
print(f"System qubits: {large_num_qubits}")
print(f"Total circuit qubits: {large_isa_circuit.num_qubits}")
print(f"Krylov dimension: {large_krylov_dim}")
print(f"Time step: {large_dt:.6f}")
print(f"Shift tau: {large_shift_tau}")
print(f"ISA circuit depth: {large_isa_circuit.depth()}")
print(f"ISA two-qubit gates: {large_two_qubit_gate_count}")
print(
    f"ISA two-qubit depth: {large_isa_circuit.depth(lambda x: x[0].num_qubits == 2)}"
)

# -------------------------Step 3-------------------------

# Execute on quantum hardware with Qiskit Runtime primitives.
# Submit one job per d, with all four observables in that job.
large_d_values = list(range(1, large_krylov_dim))
retrieve_batch_id = None
large_jobs = []

if retrieve_batch_id is None:
    large_estimator_options = {
        "default_shots": 8192,
        "dynamical_decoupling": {
            "enable": True,
            "sequence_type": "XpXm",
        },
        "resilience": {
            "measure_mitigation": True,
            "measure_noise_learning": {
                "num_randomizations": 32,
                "shots_per_randomization": 256,
            },
            "layer_noise_learning": {
                "max_layers_to_learn": 4,
                "layer_pair_depths": [0, 1, 2, 4, 16, 32],
                "num_randomizations": 32,
                "shots_per_randomization": 128,
            },
            "zne_mitigation": True,
            "zne": {
                "amplifier": "pea",
                "noise_factors": [1.0, 1.5, 2.0],
                "extrapolator": ("exponential", "linear"),
            },
        },
        "twirling": {
            "enable_gates": True,
            "enable_measure": True,
            "num_randomizations": 32,
            "shots_per_randomization": 256,
            "strategy": "active-accum",
        },
    }

    with Batch(backend=large_backend) as large_batch:
        large_batch_id = large_batch.session_id
        large_estimator = EstimatorV2(
            mode=large_batch,
            options=large_estimator_options,
        )
        # Krylov quantum diagonalization of lattice Hamiltonians -> TUT_KQDOLH.
        large_estimator.options.environment.job_tags = ["TUT_KQDOLH"]

        for d in large_d_values:
            parameter_values = [d * large_dt]
            pubs_for_d = [
                (large_isa_circuit, observable, parameter_values)
                for observable in large_isa_observables
            ]
            job = large_estimator.run(pubs_for_d)
            large_jobs.append(job)
            print(
                f"Submitted d={d}: job_id={job.job_id()}, "
                f"PUBs={len(pubs_for_d)}"
            )

    print(f"Batch ID: {large_batch_id}")
else:
    large_batch_id = retrieve_batch_id
    large_jobs = service.jobs(
        session_id=large_batch_id,
        limit=None,
        descending=False,
    )

large_job_ids_by_d = {
    d: job.job_id() for d, job in zip(large_d_values, large_jobs)
}
print(f"Job IDs by d: {large_job_ids_by_d}")

# -------------------------Step 4-------------------------

# Post-process the quantum results and solve the classical GEVP.
# Reconstruct the first rows of S and the shifted Hamiltonian matrix.
large_s_row_est = np.zeros(large_krylov_dim, dtype=complex)
large_h_shifted_row_est = np.zeros(large_krylov_dim, dtype=complex)
large_s_row_est[0] = 1.0
large_h_shifted_row_est[0] = large_ref_energy - large_shift_tau

for d, job in zip(large_d_values, large_jobs):
    job_result = job.result()

    if len(job_result) != len(large_observables):
        raise RuntimeError(
            f"Expected {len(large_observables)} PUB results for d={d}, "
            f"but received {len(job_result)}."
        )

    expectation_values = [
        np.asarray(pub_result.data.evs).reshape(-1)[0]
        for pub_result in job_result
    ]

    large_s_row_est[d] = expectation_values[0] + 1j * expectation_values[1]
    large_h_shifted_row_est[d] = (
        expectation_values[2] + 1j * expectation_values[3]
    )

# H_0d = shifted_H_0d + tau * S_0d.
large_h_row_est = large_h_shifted_row_est + large_shift_tau * large_s_row_est

large_s_matrix_est = la.toeplitz(
    large_s_row_est.conj(),
    large_s_row_est,
)
large_h_matrix_est = la.toeplitz(
    large_h_row_est.conj(),
    large_h_row_est,
)

large_exact_gnd = min(diagonalize_single_1_subspace(large_hamiltonian))

large_energy_convergence = []

with np.printoptions(precision=5, suppress=True):
    print("Estimated first row of S:")
    print(large_s_row_est)
    print("Estimated first row of H:")
    print(large_h_row_est)
    print("exact ground state energy:  ", large_exact_gnd)

    for r in range(1, large_krylov_dim + 1):
        energy_est_kqd, coeffs_est, retained_est = solve_thresholded_gevp(
            large_h_matrix_est[:r, :r],
            large_s_matrix_est[:r, :r],
            threshold=5e-2,
        )
        large_energy_convergence.append(energy_est_kqd)
        print(
            f"Krylov ground state energy (dim={r}, retained={retained_est}): ",
            energy_est_kqd,
        )

plot_energy_convergence(
    large_energy_convergence, large_exact_gnd, large_krylov_dim
)
Backend: ibm_boston
System qubits: 30
Total circuit qubits: 156
Krylov dimension: 7
Time step: 0.036110
Shift tau: 25.0
ISA circuit depth: 219
ISA two-qubit gates: 728
ISA two-qubit depth: 52
Job IDs by d: {1: 'd9fl4p4jeosc73fk4dg0', 2: 'd9fl4pineu4c739poecg', 3: 'd9fl4q2neu4c739poedg', 4: 'd9fl4qhhtsac739fjgn0', 5: 'd9fl4r4jeosc73fk4dhg', 6: 'd9fl4rkjeosc73fk4dj0'}
Estimated first row of S:
[ 1.     +0.j       0.42055-0.65466j -0.17883-0.73125j -0.64523-0.31601j
 -0.70781+0.55574j -0.02467+0.70525j  0.59301+0.55602j]
Estimated first row of H:
[ 25.      +0.j       10.3419 -16.5586j   -5.017  -18.03933j
 -16.44797 -6.98173j -17.17081+14.84502j   0.62722+17.81196j
  15.68886+12.74875j]
exact ground state energy:   21.021912418526902
Krylov ground state energy (dim=1, retained=1):  25.0
Krylov ground state energy (dim=2, retained=2):  24.432409110686205
Krylov ground state energy (dim=3, retained=3):  24.256856893278556
Krylov ground state energy (dim=4, retained=4):  23.727409826799715
Krylov ground state energy (dim=5, retained=4):  23.324720470780864
Krylov ground state energy (dim=6, retained=5):  21.91957579005085
Krylov ground state energy (dim=7, retained=5):  21.548331214122644
ملحق: منظور دالة الهاميلتونية (المرشح الطيفي)
قدّم سير العمل الرئيسي KQD بشكل إجرائي: بناء أساس كريلوف من حالات مطورة زمنيًا حقيقيًا، وتقدير المصفوفتين المسقَطتين و ، وحل مسألة GEVP. يعيد هذا الملحق النظر في نفس الحساب من زاوية مكمّلة تشرح لماذا تعمل KQD: منظور دالة الهاميلتونية، أو المرشح الطيفي [3]، [5]. يعيد استخدام نموذج الـ 12 كيوبت، والخطوة الزمنية ، وحل كريلوف الذي حصلنا عليه أعلاه؛ ولا يلزم تنفيذ دائرة جديدة.
الحالة المرجعية كتوزيع للطاقة
لتكن للهاميلتونية التحليل الذاتي
بحالات ذاتية للطاقة . يمكن توسيع أي حالة مرجعية في هذا الأساس الذاتي،
لذا تحمل وزنًا طيفيًا عند كل طاقة . الطاقة المرجعية هي متوسط هذا التوزيع، .
التحليل الذاتي لهاميلتونية عامة من كيوبت مكلف أسيًا، لذا فإن هذه الصورة مجرد أداة تشخيصية، وهي ليست جزءًا من الخوارزمية. هنا، مع ذلك، يمكننا حسابها بتكلفة زهيدة لنفس مسألة : تحافظ هاميلتونية هايزنبرغ على العدد الكلي للإثارات، وتحمل الحالة المرجعية إثارة واحدة، لذا يعيش كامل محتواها الطيفي في فضاء الإثارة الواحدة الذي ينمو بُعده خطيًا فقط مع . لذا نعيد استخدام كتلة الإثارة الواحدة الدقيقة (المستخدمة بالفعل أعلاه كمعيار) ونقرأ توزيع الحالة المرجعية داخل ذلك الفضاء.
# Exact single-excitation-subspace decomposition of the reference state.
# This reuses make_heisenberg_hamiltonian / _basis_state_transition_amplitude_sparse
# and the n=12 `hamiltonian` and `ref_bitstring` defined in the small-scale example.
single_excitation_states = [1 << k for k in range(num_qubits)]

h_single = np.array(
    [
        [
            _basis_state_transition_amplitude_sparse(hamiltonian, bra, ket)
            for ket in single_excitation_states
        ]
        for bra in single_excitation_states
    ]
)
h_single = 0.5 * (h_single + h_single.conj().T)

subspace_evals, subspace_evecs = la.eigh(h_single)
subspace_evals = np.real(subspace_evals)

# Reference-state coordinates inside the single-excitation subspace.
ref_position = single_excitation_states.index(int(ref_bitstring, 2))
ref_in_subspace = np.zeros(num_qubits, dtype=complex)
ref_in_subspace[ref_position] = 1.0

# Amplitudes and spectral weights of the reference in the energy eigenbasis.
ref_eigen_amplitudes = subspace_evecs.conj().T @ ref_in_subspace
ref_spectral_weights = np.abs(ref_eigen_amplitudes) ** 2

print(f"Single-excitation subspace dimension: {num_qubits}")
print(f"Subspace ground-state energy:         {subspace_evals[0]:.6f}")
print(
    f"Reference energy (sum p_m E_m):       {np.sum(ref_spectral_weights * subspace_evals):.6f}"
)
print(f"Reference weight on subspace ground:  {ref_spectral_weights[0]:.6f}")
Single-excitation subspace dimension: 12
Subspace ground-state energy:         3.136297
Reference energy (sum p_m E_m):       7.000000
Reference weight on subspace ground:  0.163827
تتعلم KQD مرشحًا يُعيد تشكيل هذا التوزيع
تُعرَّف دالة الهاميلتونية من خلال الحساب الطيفي،
أو بعبارة أخرى، مجموع مرجّح من المساقط الذاتية. يعيد تطبيقه على المرجع تشكيل كل سعة طيفية، :
لو كانت ذات ذروة حادة عند أدنى طاقة ( و فيما عدا ذلك)، فستعمل كمسقط للحالة الأرضية، وسيكون الناتج المُطبَّع (قريبًا من) الحالة الأرضية. لذلك، فإن مرشحًا طيفيًا جيدًا يمرر الترددات المنخفضة في الطاقة هو بالضبط ما نريده.
لا يحدد KQD مسبقًا. بل يوسّع المرشح في أساس التطور الزمني الحقيقي،
دالة مثلثية للطاقة معاملاتها هي بالضبط المتجه الذاتي لمسألة GEVP التي حُلَّت أعلاه. لذا فإن تصغير حاصل قسمة رايلي يعادل تعلّم المرشح الذي يكبح على أفضل وجه وزن الحالة المثارة في المرجع. يمنح بُعد كريلوف الأكبر المرشح مزيدًا من درجات الحرية وذروة أحدّ عند طاقة الحالة الأرضية.
تقوم الدالة المساعدة أدناه بتقييم هذا المرشح المتعلَّم على محور الطاقة؛ ثم نطبقه على التوزيع المرجعي الذي حصلنا عليه أعلاه.
def trigonometric_krylov_filter(
    coeffs: np.ndarray,
    energies: np.ndarray,
    time_step: float,
) -> np.ndarray:
    """Evaluate the learned Krylov filter f(E) = sum_l c_l exp(-i l dt E)."""
    values = np.zeros_like(energies, dtype=complex)
    for ell, coeff in enumerate(coeffs):
        values += coeff * np.exp(-1j * ell * time_step * energies)
    return values

def filtered_spectral_weights(
    weights: np.ndarray,
    filter_values: np.ndarray,
) -> np.ndarray:
    """Reshape spectral weights by |f(E)|^2 and renormalize."""
    reshaped = weights * np.abs(filter_values) ** 2
    return reshaped / np.sum(reshaped)

# Recover the KQD coefficients from the already-estimated projected matrices.
# The shift only moves H by tau * S, so it does not change the GEVP eigenvector;
# we solve at the full Krylov dimension used in the small-scale example.
_, kqd_coeffs, _ = solve_thresholded_gevp(
    h_matrix_est,
    s_matrix_est,
    threshold=1e-12,
)

filter_on_spectrum = trigonometric_krylov_filter(
    kqd_coeffs, subspace_evals, dt
)
filtered_weights = filtered_spectral_weights(
    ref_spectral_weights, filter_on_spectrum
)

print(f"Ground-state overlap  (reference): {ref_spectral_weights[0]:.4f}")
print(f"Ground-state overlap  (filtered):  {filtered_weights[0]:.4f}")
print(
    f"Mean energy           (reference): {np.sum(ref_spectral_weights * subspace_evals):.6f}"
)
print(
    f"Mean energy           (filtered):  {np.sum(filtered_weights * subspace_evals):.6f}"
)
Ground-state overlap  (reference): 0.1638
Ground-state overlap  (filtered):  0.9638
Mean energy           (reference): 7.000000
Mean energy           (filtered):  3.164503
تصوير المرشح ومرونته
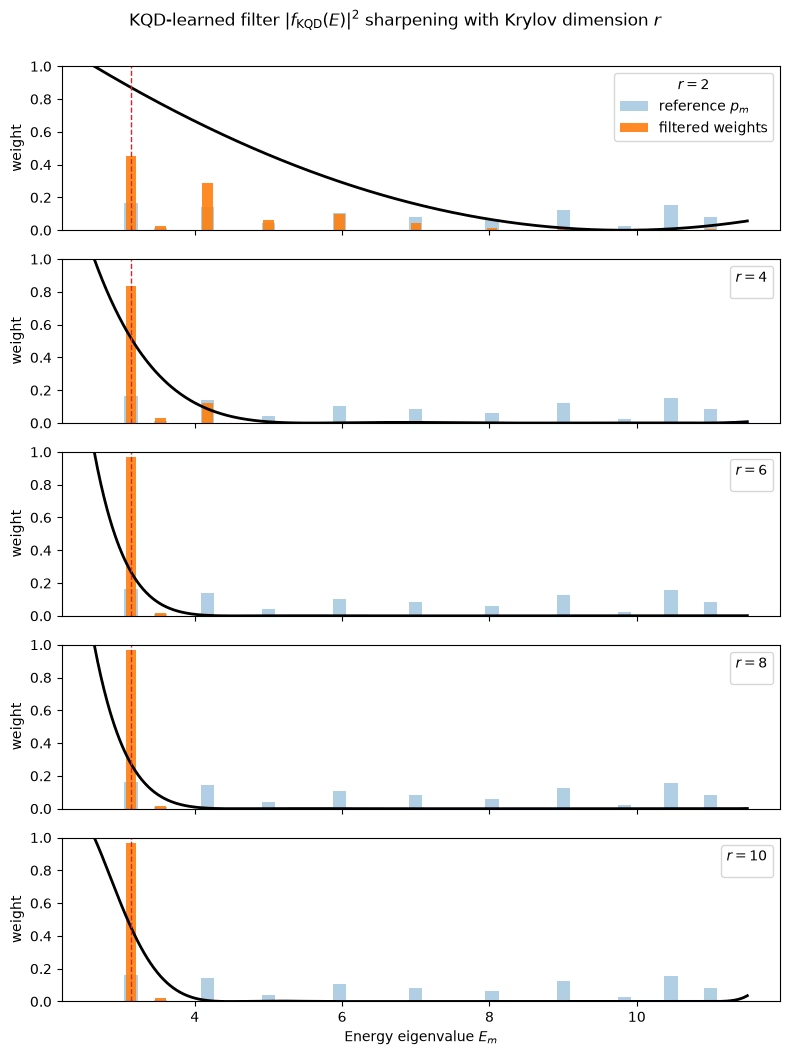
نعرض أولًا المرشح المتعلَّم عند بُعد كريلوف الكامل المستخدم أعلاه، ثم نتتبع كيف يزداد حدةً مع نمو البُعد .
توضح الأعمدة الأوزان الطيفية المرجعية (قبل) والأوزان المرشَّحة (بعد)، إلى جانب شدة المرشح المتعلَّم على محور طاقة متصل. يركّز المرشح الوزن عند أدنى طاقة لفضاء الإثارة المفردة — وهي نفس الطاقة التي تقاربت إليها تقديرات KQD في المثال صغير النطاق. لاحظ أن هذه هي الحالة الأرضية ضمن قطاع الإثارة المفردة، وهي الهدف ذو الصلة لحالة المرجع هذه التي تحافظ على الإثارة، وليست الحالة الأرضية العامة.
fig, ax = plt.subplots(figsize=(8, 4))

visible = (ref_spectral_weights > 1e-4) | (filtered_weights > 1e-4)
ax.bar(
    subspace_evals[visible],
    ref_spectral_weights[visible],
    width=0.18,
    alpha=0.45,
    label="reference $p_m$",
)
ax.bar(
    subspace_evals[visible],
    filtered_weights[visible],
    width=0.14,
    alpha=0.9,
    label=r"filtered $p_m\,|f_{\rm KQD}(E_m)|^2$",
)

energy_grid = np.linspace(
    subspace_evals.min() - 0.5, subspace_evals.max() + 0.5, 800
)
filter_intensity = (
    np.abs(trigonometric_krylov_filter(kqd_coeffs, energy_grid, dt)) ** 2
)
filter_intensity /= filter_intensity.max()
ax.plot(
    energy_grid,
    filter_intensity,
    color="k",
    linewidth=2,
    label=r"$|f_{\rm KQD}(E)|^2$ (normalized)",
)

ax.axvline(
    subspace_evals[0],
    color="C3",
    linestyle="--",
    linewidth=1,
    label="subspace ground energy",
)
ax.set_xlabel("Energy eigenvalue $E_m$")
ax.set_ylabel("Spectral weight")
ax.set_ylim(0, 1)
ax.legend(loc="upper right")
plt.tight_layout()
plt.show()

زيادة بُعد كريلوف: مرونة الدالة المتعلَّمة
تذكّر أن المرشح المتعلَّم هو كثيرة حدود مثلثية في الطاقة تحتوي على من المعاملات،
بُعد كريلوف هو بالضبط عدد المعاملات الحرة، لذا فهو يتحكم في مرونة الدالة. يمكن لقيمة الصغيرة أن تنتج فقط مرشحًا عريضًا يتغير بلطف ويسرّب وزنًا إلى الحالات المثارة المنخفضة؛ وعندما يزداد ، يمكن للمرشح أن يشكّل ذروة أضيق عند الطاقة المستهدفة ويكبح ما تبقى من وزن الحالة المثارة بقوة أكبر. هذا هو النظير في المرشح الطيفي لتقارب الطاقة الملحوظ في المثال صغير النطاق: مع نمو ، ينهار التوزيع المرشَّح نحو الحالة الأرضية للفضاء الفرعي وتنخفض الطاقة المقدَّرة نحوها.
نعيد استخدام المصفوفات المسقَطة التي قُدِّرت بالفعل أعلاه ونحل ببساطة مسألة GEVP عند كل كتلة رئيسية بحجم ، ثم نقيّم المرشح المقابل ونرسمه.
# Sweep the Krylov dimension using the leading r x r blocks of the estimated matrices.
sweep_dims = [r for r in (2, 4, 6, 8, krylov_dim) if r <= krylov_dim]
sweep_dims = sorted(set(sweep_dims))

energy_grid = np.linspace(
    subspace_evals.min() - 0.5, subspace_evals.max() + 0.5, 800
)

sweep_cases = []
print(" r    retained    ground overlap    filtered energy")
print("--    --------    --------------    ---------------")
for r in sweep_dims:
    _, coeffs_r, retained_r = solve_thresholded_gevp(
        h_matrix_est[:r, :r],
        s_matrix_est[:r, :r],
        threshold=1e-12,
    )
    filter_on_spectrum_r = trigonometric_krylov_filter(
        coeffs_r, subspace_evals, dt
    )
    filtered_weights_r = filtered_spectral_weights(
        ref_spectral_weights, filter_on_spectrum_r
    )
    filtered_energy_r = float(np.sum(filtered_weights_r * subspace_evals))

    sweep_cases.append((r, coeffs_r, filtered_weights_r))
    print(
        f"{r:2d}    {retained_r:8d}    {filtered_weights_r[0]:14.4f}    {filtered_energy_r:15.6f}"
    )

print(f"\nSubspace ground-state energy (target): {subspace_evals[0]:.6f}")

# One panel per Krylov dimension: filtered spectrum (bars) + filter intensity (curve).
fig, axes = plt.subplots(
    len(sweep_cases),
    1,
    figsize=(8, 2.1 * len(sweep_cases)),
    sharex=True,
)
axes = np.atleast_1d(axes)

for idx, (ax, (r, coeffs_r, filtered_weights_r)) in enumerate(
    zip(axes, sweep_cases)
):
    visible = (ref_spectral_weights > 1e-4) | (filtered_weights_r > 1e-4)
    ax.bar(
        subspace_evals[visible],
        ref_spectral_weights[visible],
        width=0.18,
        alpha=0.35,
        color="C0",
        label="reference $p_m$" if idx == 0 else None,
    )
    ax.bar(
        subspace_evals[visible],
        filtered_weights_r[visible],
        width=0.14,
        alpha=0.9,
        color="C1",
        label="filtered weights" if idx == 0 else None,
    )

    filter_intensity_r = (
        np.abs(trigonometric_krylov_filter(coeffs_r, energy_grid, dt)) ** 2
    )
    filter_intensity_r /= filter_intensity_r.max()
    ax.plot(energy_grid, filter_intensity_r, color="k", linewidth=2)

    ax.axvline(subspace_evals[0], color="C3", linestyle="--", linewidth=1)
    ax.set_ylim(0, 1)
    ax.set_ylabel("weight")
    ax.legend(loc="upper right", title=f"$r={r}$")

axes[-1].set_xlabel("Energy eigenvalue $E_m$")
fig.suptitle(
    r"KQD-learned filter $|f_{\rm KQD}(E)|^2$ sharpening with Krylov dimension $r$",
    y=1.0,
)
fig.tight_layout()
plt.show()
r    retained    ground overlap    filtered energy
--    --------    --------------    ---------------
 2           2            0.4549           4.184510
 4           4            0.8373           3.310168
 6           6            0.9706           3.158100
 8           7            0.9701           3.158725
10           8            0.9638           3.164503

Subspace ground-state energy (target): 3.136297
الخطوات التالية
إذا وجدت هذا العمل مثيرًا للاهتمام، فقد تهمك المواد التالية:
المراجع
[1] E. N. Epperly, L. Lin, and Y. Nakatsukasa, A theory of quantum subspace diagonalization, SIAM Journal on Matrix Analysis and Applications 43, 1263-1290 (2022).
[2] N. Yoshioka, M. Amico, W. Kirby, et al., Diagonalization of large many-body Hamiltonians on a quantum processor, arXiv:2407.14431 (2024).
[3] R. M. Parrish and P. L. McMahon, Quantum filter diagonalization: quantum eigendecomposition without full quantum phase estimation, Physical Review Letters 122, 230401 (2019).
[4] G. Lee, S. Choi, J. Huh, and A. F. Izmaylov, Efficient strategies for reducing sampling error in quantum Krylov subspace diagonalization, Digital Discovery 4, 954-969 (2025).
[5] G. Lee, M. Kang, J. Hong, S. Fomichev and J. Huh, Filtered Quantum Phase Estimation, arXiv:2510.04294 (2025).