إدارة الأداء: دالة Qiskit من Q-CTRL Fire Opal
راجع مرجع API
Qiskit Functions ميزة تجريبية متاحة فقط لمستخدمي خطط IBM Quantum® Premium وFlex وOn-Prem (عبر IBM Quantum Platform API). هي في مرحلة إصدار معاينة وعرضة للتغيير.
Package versions
تم تطوير الكود في هذه الصفحة باستخدام المتطلبات التالية. ننصح باستخدام هذه الإصدارات أو أحدث.
qiskit[all]~=2.3.1
qiskit-ibm-runtime~=0.45.1
نظرة عامة
يُسهّل Fire Opal Performance Management على أي شخص الحصول على نتائج ذات معنى من الحواسيب الكمومية على نطاق واسع دون الحاجة إلى أن يكون خبيرًا في الأجهزة الكمومية. عند تشغيل الدوائر باستخدام Fire Opal Performance Management، تُطبَّق تقنيات كبت الأخطاء المدفوعة بالذكاء الاصطناعي تلقائيًا، مما يُتيح توسيع نطاق المسائل الأكبر التي تشمل مزيدًا من البوابات والقبيتات. يُقلل هذا النهج من عدد اللقطات (shots) اللازمة للوصول إلى الإجابة الصحيحة دون أي تكلفة إضافية — مما يوفر وفرات كبيرة في وقت الحوسبة والتكلفة.
يكبت Performance Management الأخطاء ويزيد من احتمالية الحصول على الإجابة الصحيحة على الأجهزة الصاخبة. بعبارة أخرى، يزيد من نسبة الإشارة إلى الضوضاء. تُظهر الصورة التالية كيف أن الدقة المتزايدة التي يوفرها Performance Management يمكنها تقليل الحاجة إلى لقطات إضافية في حالة خوارزمية تحويل فورييه الكمومي (Quantum Fourier Transform) بعشرة قبيتات. بـ 30 لقطة فقط، يصل Q-CTRL إلى عتبة الثقة البالغة 99%، في حين يتطلب الإعداد الافتراضي (QiskitRuntime Sampler، optimization_level=3 وresilience_level=1، ibm_sherbrooke) 170,000 لقطة. بالحصول على الإجابة الصحيحة بشكل أسرع، توفر وقت حوسبة كبيرًا.
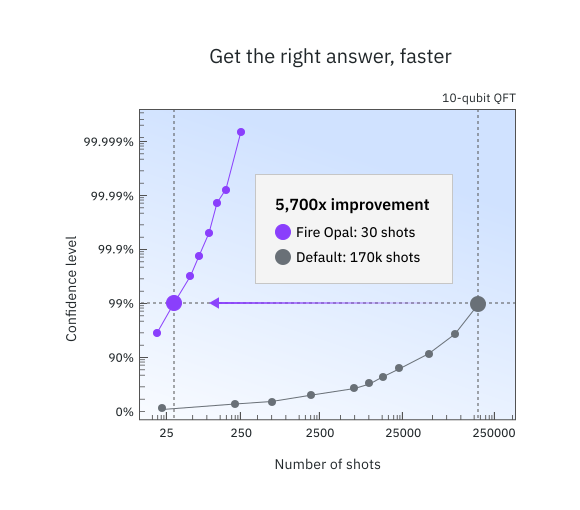
يمكن استخدام دالة Performance Management مع أي خوارزمية، ويمكنك استخدامها بسهولة بدلًا من بدائيات IBM Quantum القياسية. خلف الكواليس، تعمل تقنيات كبت أخطاء متعددة معًا لمنع الأخطاء من الحدوث أثناء التشغيل. جميع طرق pipeline في Fire Opal مُهيَّأة مسبقًا وغير مرتبطة بخوارزمية بعينها، مما يعني أنك دائمًا تحصل على أفضل أداء فور الاستخدام.
للحصول على إمكانية الوصول إلى Performance Management، تواصل مع Q-CTRL.
الوصف
يوفر Fire Opal Performance Management خيارَين للتنفيذ مشابهَين لبدائيات IBM Quantum، بحيث يمكنك استبدال Sampler وEstimator من Q-CTRL بسهولة. سير العمل العام لاستخدام دالة Performance Management هو:
- حدِّد دائرتك (والمؤثرات في حالة Estimator).
- شغِّل الدائرة.
- استرجع النتائج.
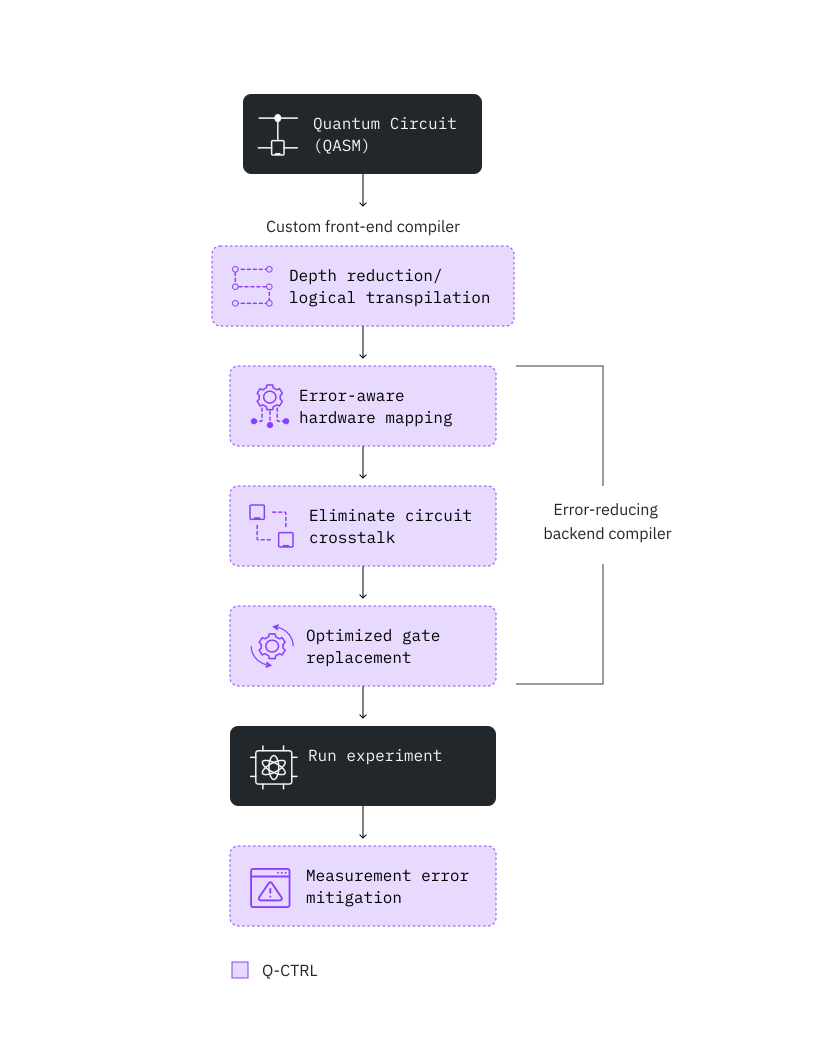
للحد من ضوضاء الأجهزة، يستخدم Fire Opal مجموعة من تقنيات كبت الأخطاء المدفوعة بالذكاء الاصطناعي الموضحة في الصورة التالية. مع Fire Opal، تكون جميع مراحل pipeline مؤتمتة بالكامل دون أي حاجة للتهيئة.
يُلغي pipeline الخاص بـ Fire Opal الحاجة إلى تكاليف إضافية، مثل زيادة وقت التشغيل الكمومي أو القبيتات الفيزيائية الإضافية. لاحظ أن وقت المعالجة الكلاسيكي لا يزال عاملًا مؤثرًا (راجع قسم المعايير للاطلاع على التقديرات، حيث يعكس "الوقت الإجمالي" كلًا من المعالجة الكلاسيكية والكمومية). على عكس تخفيف الأخطاء الذي يستلزم تكلفة إضافية في شكل أخذ عينات، يعمل كبت أخطاء Fire Opal على مستوى البوابات والنبضات لمعالجة مصادر الضوضاء المختلفة ومنع احتمالية حدوث الأخطاء. بمنع الأخطاء، تنتفي الحاجة إلى المعالجة اللاحقة المكلفة.
تُصوِّر الصورة التالية طرق كبت الأخطاء التي يؤتمتها Fire Opal Performance Management.
تقدم الدالة بدائيَّتَين، Sampler وEstimator، ومدخلات ومخرجات كلتيهما تمتد لتشمل المواصفات المُنفَّذة لـ بدائيات IBM Quantum V2.
المعايير
تُظهر نتائج معيارية الخوارزميات المنشورة تحسينًا ملحوظًا في الأداء عبر خوارزميات مختلفة، تشمل Bernstein-Vazirani وتحويل فورييه الكمومي وبحث Grover وخوارزمية التحسين الكمومي التقريبي (QAOA) ومحلل القيم الذاتية المتغيري الكمومي (VQE). يقدم باقي هذا القسم مزيدًا من التفاصيل حول أنواع الخوارزميات التي يمكنك تشغيلها، فضلًا عن الأداء ووقت التشغيل المتوقعَين.
تُوضح الدراسات المستقلة التالية كيف يُمكِّن Performance Management من Q-CTRL البحث الخوارزمي على نطاق قياسي:
- نوى الكم المُعامَلة وفعّالة الطاقة لتشخيص أعطال خدمات الشبكة - تعلم نواة كمومية يصل إلى 50 قبيت
- تقدير الفارق في الطور الكمومي المستند إلى الموتر لعرض توضيحي على نطاق واسع - تقدير الطور الكمومي يصل إلى 33 قبيت
- التعلم الهرمي للتعلم الآلي الكمومي: تقنية تدريب جديدة للدوائر الكمومية المتغيرة ذات النطاق الواسع - تحميل بيانات كمومية يصل إلى 21 قبيت
يوفر الجدول التالي دليلًا تقريبيًا للدقة وأوقات التشغيل من عمليات المعيارية السابقة على ibm_fez. قد يختلف الأداء على الأجهزة الأخرى. وقت الاستخدام مبني على افتراض 10,000 لقطة لكل دائرة. "عدد القبيتات" المُشار إليه ليس حدًا صارمًا، بل يمثل عتبات تقريبية يمكنك عندها توقع دقة حل متسقة للغاية. وقد تم حل مسائل أكبر بنجاح، ويُشجَّع على الاختبار بعد تجاوز هذه الحدود.
| مثال | عدد القبيتات | الدقة | مقياس الدقة | الوقت الإجمالي (ثانية) | استخدام وقت التشغيل (ثانية) | البدائية (الوضع) |
|---|---|---|---|---|---|---|
| Bernstein–Vazirani | 50 قبيت | 100% | معدل النجاح (النسبة المئوية للتشغيلات التي تكون فيها الإجابة الصحيحة أعلى سلسلة بت عدًا) | 10 | 8 | Sampler |
| تحويل فورييه الكمومي | 30 قبيت | 100% | معدل النجاح (النسبة المئوية للتشغيلات التي تكون فيها الإجابة الصحيحة أعلى سلسلة بت عدًا) | 10 | 8 | Sampler |
| تقدير الطور الكمومي | 30 قبيت | 99.9998% | دقة الزاوية المُحددة: 1- abs(real_angle - angle_found)/pi | 10 | 8 | Sampler |
| محاكاة كمومية: نموذج Ising (15 خطوة) | 20 قبيت | 99.775% | (المُعرَّف أدناه) | 60 (لكل خطوة) | 15 (لكل خطوة) | Estimator |
| محاكاة كمومية 2: ديناميكيات جزيئية (20 نقطة زمنية) | 34 قبيت | 96.78% | (المُعرَّف أدناه) | 10 (لكل نقطة زمنية) | 6 (لكل نقطة زمنية) | Estimator |
تعريف دقة قياس قيمة التوقع - المقياس مُعرَّف على النحو التالي:
حيث = قيمة التوقع المثالية، و = قيمة التوقع المقاسة، و = القيمة المثالية القصوى، و = القيمة المثالية الدنيا. و هو ببساطة متوسط قيمة عبر قياسات متعددة.
يُستخدم هذا المقياس لأنه لا يتأثر بالإزاحات الكلية والقياس في نطاق القيم القابلة للتحقيق. بعبارة أخرى، بغض النظر عن رفع أو خفض نطاق قيم التوقع المحتملة أو زيادة انتشارها، يجب أن تظل قيمة ثابتة.
البداية
يستخدم Fire Opal Performance Management الإصدار 2.0.0 من Qiskit، وهو الإصدار الموصى به. الإصدارات المدعومة هي Qiskit >=v2.0.0.
قم بالمصادقة باستخدام مفتاح API لـ IBM Quantum Platform، واختر دالة Qiskit كما يلي. (يفترض هذا المقطع البرمجي أنك حفظت حسابك بالفعل في بيئتك المحلية.)
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "qiskit": "qiskit", "qiskit_ibm_catalog": "qiskit-ibm-catalog", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
# This cell is hidden from users. It hides the "...You have imported samplomatic..." warning.
import warnings

warnings.filterwarnings("ignore", message=".*You have imported samplomatic*")
from qiskit_ibm_catalog import QiskitFunctionsCatalog

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# verify that you have access to the function
catalog.list()
[QiskitFunction(qunova/hivqe-chemistry),
 QiskitFunction(global-data-quantum/quantum-portfolio-optimizer),
 QiskitFunction(algorithmiq/tem),
 QiskitFunction(qedma/qesem),
 QiskitFunction(multiverse/singularity),
 QiskitFunction(ibm/circuit-function),
 QiskitFunction(q-ctrl/optimization-solver),
 QiskitFunction(colibritd/quick-pde),
 QiskitFunction(q-ctrl/performance-management),
 QiskitFunction(kipu-quantum/iskay-quantum-optimizer)]
# Access Function
perf_mgmt = catalog.load("q-ctrl/performance-management")
إذا أردت استخدام backend لا تدعمه هذه الوظيفة حاليًا، تواصل مع Q-CTRL لإضافة الدعم.
بدائية Estimator
مثال على Estimator
استخدم بدائية Estimator في Fire Opal Performance Management لتحديد قيمة التوقع لزوج دائرة-مراقِب واحد.
بالإضافة إلى حزمتَي qiskit-ibm-catalog وqiskit، ستحتاج أيضًا إلى حزمة numpy لتشغيل هذا المثال. يمكنك تثبيت هذه الحزمة بإلغاء تعليق الخلية التالية إذا كنت تشغّل هذا المثال في دفتر ملاحظات باستخدام IPython kernel.
# %pip install numpy
1. إنشاء الدائرة
كمثال، أنشئ مؤثر هيرميتي عشوائيًا ومراقِبًا لإدخالهما في دالة Performance Management.
import numpy as np
from qiskit.circuit.library import iqp
from qiskit.quantum_info import random_hermitian, SparsePauliOp

n_qubits = 50

# Generate a random circuit
mat = np.real(random_hermitian(n_qubits, seed=1234))
circuit = iqp(mat)
circuit.measure_all()

# Define observables as a string
observable = SparsePauliOp("Z" * n_qubits)
# Create PUB tuple
estimator_pubs = [(circuit, observable)]
2. تشغيل الدائرة
شغِّل الدائرة وحدِّد اختياريًا الـ backend وعدد اللقطات.
# This cell is hidden from users
from qiskit_ibm_runtime import QiskitRuntimeService

service = QiskitRuntimeService()
backend_name = service.least_busy().name
# Run the circuit using Estimator
qctrl_estimator_job = perf_mgmt.run(
    primitive="estimator",
    pubs=estimator_pubs,
    backend_name=backend_name,
)
يمكنك استخدام واجهات برمجة تطبيقات Qiskit Serverless المألوفة للتحقق من حالة حمل عمل دالة Qiskit الخاصة بك:
qctrl_estimator_job.status()
'QUEUED'
3. استرجاع النتيجة
# Retrieve the counts from the result list
result = qctrl_estimator_job.result()
النتائج لها نفس تنسيق نتيجة Estimator:
import numpy

result_str = str(result)

with numpy.printoptions(threshold=200):
    print(
        f"The result of the submitted job had {len(result)} PUB "
        f"and has a value:\n {result[0]}\n"
    )

print("The associated PubResult of this job has the following DataBins:")
print(f"{result[0].data}\n")

print(f"And this DataBin has attributes: {result[0].data.keys()}")

print("The expectation values measured from this PUB are:")
print(f"{result[0].data.evs}")
The result of the submitted job had 1 PUB
The result of the submitted job had 1 PUB and has a value:
 PubResult(data=DataBin(evs=0.0195, stds=0.9998098569228051), metadata={'precision': None})

The associated PubResult of this job has the following DataBins:
DataBin(evs=0.0195, stds=0.9998098569228051)

And this DataBin has attributes: dict_keys(['evs', 'stds'])
The expectation values measured from this PUB are:
0.0195
بدائية Sampler
مثال على Sampler
استخدم بدائية Sampler في Fire Opal Performance Management لتشغيل دائرة Bernstein–Vazirani. هذه الخوارزمية تُستخدم للعثور على سلسلة مخفية من مخرجات دالة صندوق أسود، وهي خوارزمية شائعة لقياس الأداء (benchmarking) لأن لها إجابة صحيحة واحدة فقط. 1. إنشاء الدائرة
حدِّد الإجابة الصحيحة للخوارزمية، وهي السلسلة الثنائية المخفية، ثم أنشئ دائرة Bernstein–Vazirani. يمكنك ضبط عرض الدائرة ببساطة عن طريق تغيير قيمة circuit_width.
import qiskit

circuit_width = 35
hidden_bitstring = "1" * circuit_width

# Create circuit, reserving one qubit for BV oracle
bv_circuit = qiskit.QuantumCircuit(circuit_width + 1, circuit_width)
bv_circuit.x(circuit_width)
bv_circuit.h(range(circuit_width + 1))
for input_qubit, bit in enumerate(reversed(hidden_bitstring)):
    if bit == "1":
        bv_circuit.cx(input_qubit, circuit_width)
bv_circuit.barrier()
bv_circuit.h(range(circuit_width + 1))
bv_circuit.barrier()
for input_qubit in range(circuit_width):
    bv_circuit.measure(input_qubit, input_qubit)

# Create PUB tuple
sampler_pubs = [(bv_circuit,)]
2. تشغيل الدائرة
شغِّل الدائرة وحدِّد اختياريًا الـ backend وعدد اللقطات.
# Run the circuit using Sampler
qctrl_sampler_job = perf_mgmt.run(
    primitive="sampler",
    pubs=sampler_pubs,
    backend_name=backend_name,
)
تحقق من حالة حمل عمل Qiskit Function الخاص بك أو أعِد النتائج كما يلي:
# Print the ID so you can use it later, if necessary
print(qctrl_sampler_job.job_id)

qctrl_sampler_job.status()
60fe2fa1-a860-43e4-8615-c6ac4180f93b
'QUEUED'
3. استرجاع النتيجة
# Retrieve the job results
sampler_result = qctrl_sampler_job.result()
# Get results for the first (and only) PUB
pub_result = sampler_result[0]
counts = pub_result.data.c.get_counts()

print("Counts for the meas output register (limited to 30 results):")
for i, (bitstring, count) in enumerate(counts.items()):
    if i >= 50:
        print(f"  ... ({len(counts) - 30} more items)")
        break
    print(f"  {bitstring}: {count}")
Counts for the meas output register (limited to 30 results):
  11111111111111111111111111111111111: 1661
  11111111111111111111111111110111111: 60
  11111111111111111111111111111101111: 54
  11111111111111111111111111111110111: 54
  11111111111111011111111111111111111: 46
  11111111111111111110111111111111111: 44
  11111111111111111111111101111111111: 42
  11111111111111111111111110111111111: 42
  11111111111111110111111111111111111: 41
  11111111111111111111111111111111101: 39
  11111111111111111111101111111111111: 38
  11111111111111111111110111111111111: 38
  11111111111111111111111111101111111: 37
  11111111111111111111111111111111110: 36
  11111111111110111111111111111111111: 35
  11111111111111111111111111111011111: 32
  11111111111111101111111111111111111: 32
  01111111111111111111111111111111111: 27
  11111111111111111011111111111111111: 23
  11111111101111111111111111111111111: 22
  11111111111111111111111111111111011: 21
  11111111011111111111111111111111111: 20
  00000000000000011111111111111111111: 18
  11111111111111111111110101111111111: 18
  00000001111111111111111111111111111: 17
  11111111001111111111111111111111111: 16
  11101111111111111111111111111111111: 16
  11111111111101111111111111111111111: 16
  00000101111111111111111111111111111: 13
  11111111111111111111111011111111111: 13
  11111111111111111111111110101111111: 13
  11111111111111111101111111111111111: 12
  10111111111111111111111111111111111: 12
  11111111111111111111111110001111111: 12
  00000000000000000011111111111111111: 11
  11111111111111111111111111111110110: 10
  00000000000000000000000001111111111: 10
  11111111111011111111111111111111111: 9
  11111111111111101011111111111111111: 9
  00000000011111111111111111111111111: 8
  10101111111111111111111111111111111: 8
  00000000000000000000000001011111111: 8
  11111111111111111111111111111111001: 8
  00000111111111111111111111111111111: 7
  11111111111111111111111111111101110: 7
  11111111110111111111111111111111111: 7
  00000000000001011111111111111111111: 6
  00000000000000001111111111111111111: 6
  00000000000000000001011111111111111: 6
  11111111111111111111111111011111111: 6
  ... (1050 more items)
3. ارسم أفضل السلاسل الثنائية (bitstrings)
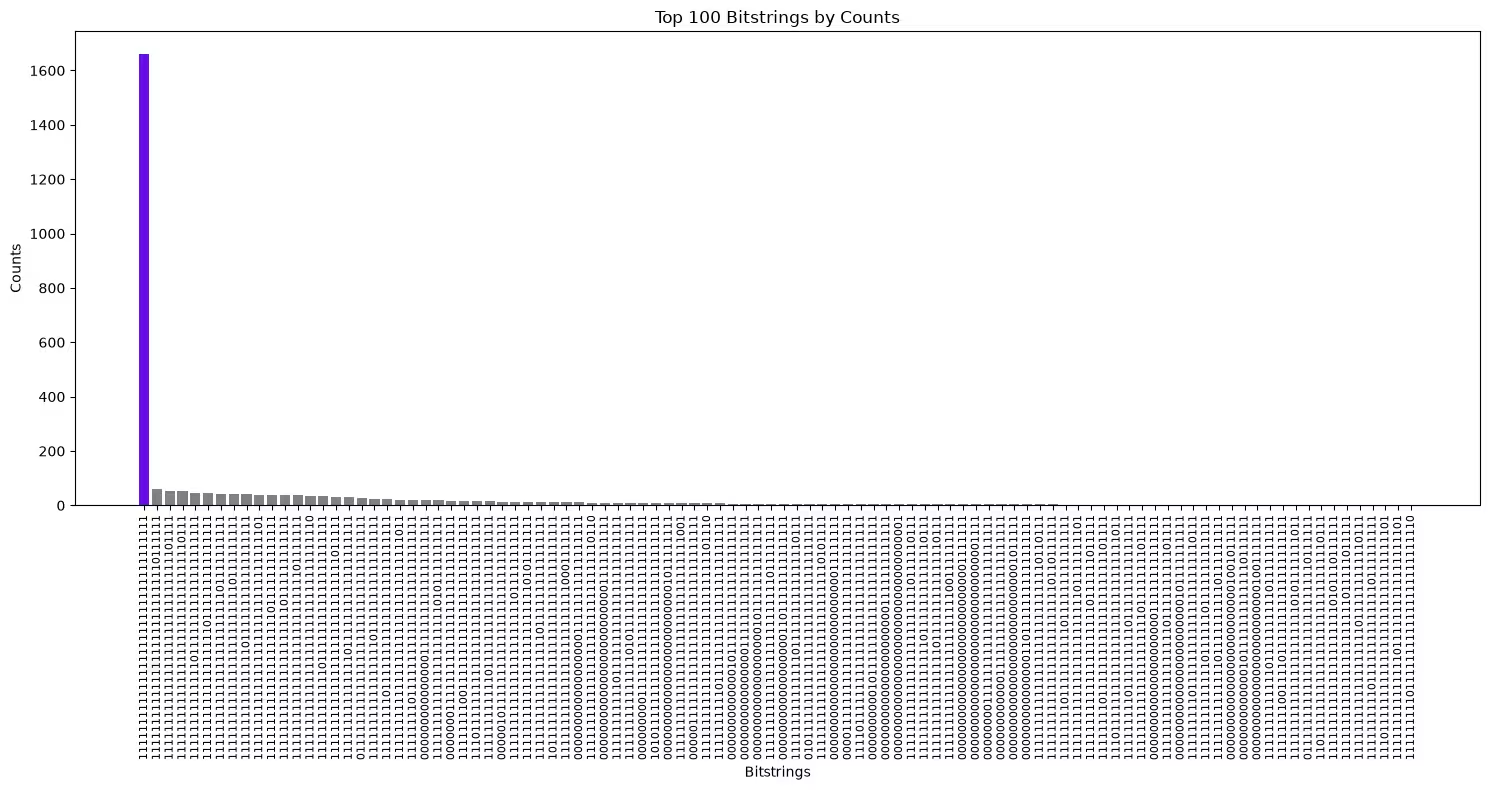
ارسم السلسلة الثنائية ذات أعلى عدد تكرارات لترى ما إذا كانت السلسلة المخفية هي الأكثر شيوعًا.
import matplotlib.pyplot as plt

def plot_top_bitstrings(counts_dict, hidden_bitstring=None):
    # Sort and take the top 100 bitstrings
    top_100 = sorted(counts_dict.items(), key=lambda x: x[1], reverse=True)[
        :100
    ]
    if not top_100:
        print("No bitstrings found in the input dictionary.")
        return

    # Unzip the bitstrings and their counts
    bitstrings, counts = zip(*top_100)

    # Assign colors: purple if the bitstring matches hidden_bitstring,
    # otherwise gray
    colors = [
        "#680CE9" if bit == hidden_bitstring else "gray" for bit in bitstrings
    ]

    # Create the bar plot
    plt.figure(figsize=(15, 8))
    plt.bar(
        range(len(bitstrings)), counts, tick_label=bitstrings, color=colors
    )

    # Rotate the bitstrings for better readability
    plt.xticks(rotation=90, fontsize=8)
    plt.xlabel("Bitstrings")
    plt.ylabel("Counts")
    plt.title("Top 100 Bitstrings by Counts")

    # Show the plot
    plt.tight_layout()
    plt.show()
السلسلة الثنائية المخفية مُبرزة باللون الأرجواني، ويُفترض أن تكون السلسلة ذات أعلى عدد من التكرارات.
plot_top_bitstrings(counts, hidden_bitstring)
سجل التغييرات
-
2026-02-20: إشعار إهمال - سيتم إهمال حقل البيانات الوصفية
provider_job_idsخلال 30 يومًا في الإصدار 0.13.0. يمكن للمستخدمين الوصول إلى معرّف الوظيفة من خلال طريقةjob_id()الخاصة بخدمة التشغيل. -
2026-02-11: تمت إضافة دعم
ibm_miami، وإضافة بيانات تعريفية للتنفيذ إلىPubResult.
الحصول على الدعم
لأي أسئلة أو مشكلات، تواصل مع Q-CTRL.
الخطوات التالية
-
اطلب الوصول إلى Q-CTRL Performance Management.
-
تفضّل بزيارة مرجع API الخاص بدالة Qiskit هذه.
-
جرِّب البرنامج التعليمي Transverse-Field Ising Model مع Q-CTRL's Performance Management.
-
جرِّب البرنامج التعليمي Quantum Phase Estimation مع Q-CTRL's Qiskit Functions