QESEM: دالة Qiskit من Qedma
راجع مرجع واجهة برمجة التطبيقات
إصدارات الحزم
تم تطوير الشيفرة الموجودة في هذه الصفحة باستخدام المتطلبات التالية. نوصي باستخدام هذه الإصدارات أو أحدث.
qiskit[all]~=2.5.0
qiskit-ibm-runtime~=0.47.0
Qiskit Functions ميزة تجريبية متاحة فقط لمستخدمي خطط IBM Quantum® Premium وFlex وOn-Prem (عبر IBM Quantum Platform API). وهي في مرحلة إصدار معاينة وقابلة للتغيير.
نظرة عامة
على الرغم من التحسينات الكبيرة التي شهدتها وحدات المعالجة الكمومية في السنوات الأخيرة، لا تزال الأخطاء الناجمة عن الضوضاء والعيوب في الأجهزة الحالية تمثّل تحديًا محوريًا لمطوّري الخوارزميات الكمومية. ومع اقتراب المجال من الحسابات الكمومية ذات المقياس الأداتي التي يتعذّر التحقق منها كلاسيكيًا، تتزايد أهمية الحلول القادرة على إلغاء الضوضاء بدقة مضمونة. للتغلب على هذا التحدي، طوّرت Qedma نظام تخفيف الأخطاء الكمومي (QESEM)، المدمج بسلاسة في IBM Quantum Platform بوصفه دالة Qiskit.
مع QESEM، يمكن للمستخدمين تشغيل دوائرهم الكمومية على وحدات المعالجة الكمومية الصاخبة للحصول على نتائج دقيقة للغاية وخالية من الأخطاء، مع تكاليف زمنية منخفضة وقريبة من الحدود الأساسية. لتحقيق ذلك، يستخدم QESEM مجموعة من الأساليب الخاصة التي طوّرتها Qedma لتوصيف الأخطاء وتقليلها. تشمل تقنيات تقليل الأخطاء: تحسين البوابات، والترانسبيلاسيون الواعي بالضوضاء، وقمع الأخطاء (ES)، وتخفيف الأخطاء غير المتحيز (EM). بهذا الجمع من الأساليب القائمة على التوصيف، يستطيع المستخدمون الحصول على نتائج موثوقة وخالية من الأخطاء للدوائر الكمومية الكبيرة ذات الأحجام الكبيرة، مما يفتح تطبيقات لا يمكن تحقيقها بطريقة أخرى.
للاطلاع على وصف كامل للمكوّنات الأساسية، إضافةً إلى عرض توضيحي بمقياس أداتي، راجع الورقة البحثية تخفيف الأخطاء بدقة عالية وموثوقة للدوائر الكمومية بمقياس الأداة.
الوصف
يمكنك استخدام دالة QESEM من Qedma لتقدير تكلفة تنفيذ دوائرك وتشغيلها بسهولة مع قمع الأخطاء وتخفيفها، مما يتيح أحجام دوائر أكبر ودقة أعلى. لاستخدام QESEM، تُقدّم دارة كمومية، ومجموعة من المرصودات (observables) لقياسها، ودقة إحصائية مستهدفة لكل مرصود، ووحدة معالجة كمومية مختارة. قبل تشغيل الدارة للوصول إلى الدقة المستهدفة، يمكنك تقدير وقت وحدة المعالجة الكمومية المطلوب استنادًا إلى حساب تحليلي لا يستلزم تنفيذ الدارة. بمجرد أن تقتنع بتقدير وقت وحدة المعالجة الكمومية، يمكنك تشغيل الدارة مع QESEM.
عند تشغيل دارة ما، يُنفّذ QESEM بروتوكول توصيف الجهاز المُخصَّص لدارتك، مما يُنتج نموذج ضوضاء موثوقًا للأخطاء التي تحدث في الدارة. استنادًا إلى هذا التوصيف، يُطبّق QESEM أولًا الترانسبيلاسيون الواعي بالضوضاء لتعيين الدارة المُدخَلة على مجموعة من الكيوبتات والبوابات الفيزيائية، مما يُقلّل من الضوضاء المؤثرة على المرصود المستهدف. وتشمل هذه البوابات المتاحة أصلًا (CX/CZ على أجهزة IBM®)، إضافةً إلى بوابات إضافية مُحسَّنة بواسطة QESEM، لتشكيل مجموعة البوابات الموسّعة الخاصة بـ QESEM. ثم يُشغّل QESEM مجموعة من دوائر ES وEM القائمة على التوصيف على وحدة المعالجة الكمومية ويجمع نتائج قياساتها. تُعالَج هذه النتائج بعد ذلك كلاسيكيًا لتوفير قيمة توقع غير متحيزة وهامش خطأ لكل مرصود، مقابلةً للدقة المطلوبة.
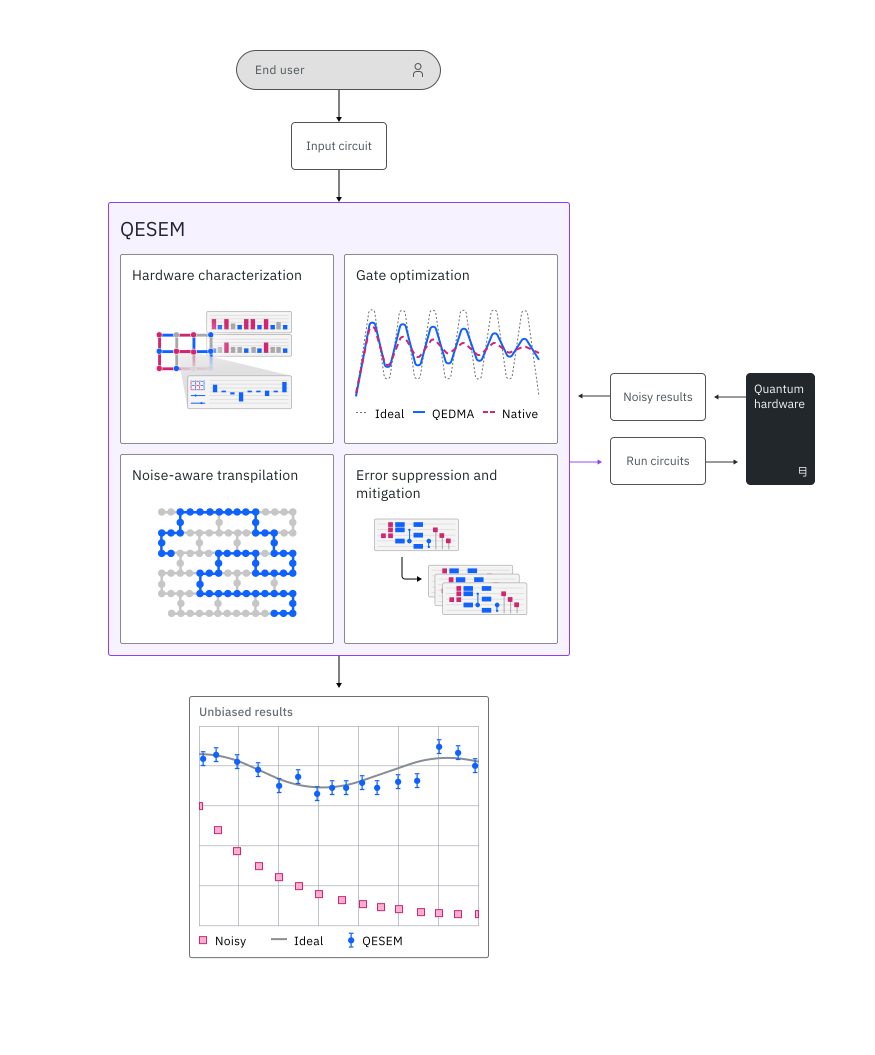 أثبت QESEM قدرته على تقديم نتائج عالية الدقة لمجموعة متنوعة من التطبيقات الكمومية وعلى أكبر أحجام الدوائر القابلة للتحقيق اليوم. يتيح QESEM المميزات التالية الموجّهة للمستخدم، والمستعرضة في قسم المعايير أدناه:
- دقة مضمونة: يُخرج QESEM تقديرات غير متحيزة لقيم التوقع للمؤثرات. أسلوب EM الخاص به مجهّز بضمانات نظرية، التي - جنبًا إلى جنب مع توصيف Qedma المتقدم - تضمن تقارب التخفيف نحو مخرجات الدارة الخالية من الضوضاء وصولًا إلى الدقة المحددة من قِبَل المستخدم. على النقيض من كثير من أساليب EM الاستدلالية المعرضة للأخطاء المنهجية أو التحيّزات، فإن دقة QESEM المضمونة ضرورية لضمان نتائج موثوقة في الدوائر والمؤثرات الكمومية العامة.
- قابلية التوسّع لوحدات معالجة كمومية كبيرة: يعتمد وقت وحدة المعالجة الكمومية في QESEM على أحجام الدوائر، لكنه مستقل في حالات أخرى عن عدد الكيوبتات. أثبتت Qedma عمل QESEM على أكبر الأجهزة الكمومية المتاحة اليوم، بما فيها أجهزة IBM Quantum Eagle بـ 127 كيوبت وHeron بـ 133 كيوبت.
- لا يختص بتطبيق بعينه: جرى توظيف QESEM في مجموعة متنوعة من التطبيقات، تشمل محاكاة هاميلتونيان، وVQE، وQAOA، وتقدير السعة. يمكن للمستخدمين إدخال أي دارة كمومية ومؤثر لقياسها والحصول على نتائج دقيقة وخالية من الأخطاء. القيود الوحيدة تفرضها مواصفات الجهاز ووقت وحدة المعالجة الكمومية المخصص، اللذان يحددان أحجام الدوائر المتاحة ودقة المخرجات. في المقابل، كثير من حلول تقليل الأخطاء مخصصة لتطبيقات بعينها أو تعتمد على إرشاديات غير مضبوطة، مما يجعلها غير صالحة للدوائر والتطبيقات الكمومية العامة.
- مجموعة بوابات موسّعة: يدعم QESEM بوابات الزوايا الكسرية، ويوفّر بوابات ذات الزوايا الكسرية المُحسَّنة من Qedma على أجهزة IBM Quantum Heron وEagle. تُتيح مجموعة البوابات الموسّعة هذه تصريفًا أكثر كفاءة وتفتح أحجام دوائر أكبر بعامل يصل إلى 2 مقارنةً بتصريف CX/CZ الافتراضي.
- المؤثرات متعددة القواعد: يدعم QESEM المؤثرات المُدخَلة المؤلفة من عديد من سلاسل باولي غير المتبادلة في التبديل، كهاميلتونيانات عامة. يتم اختيار قواعد القياس وتحسين توزيع موارد وحدة المعالجة الكمومية (اللقطات والدوائر) تلقائيًا بواسطة QESEM لتقليل وقت وحدة المعالجة الكمومية المطلوب لتحقيق الدقة المطلوبة. يأخذ هذا التحسين في الاعتبار نسب الإخلاص ومعدلات التنفيذ للجهاز، مما يُمكّنك من تشغيل دوائر أعمق والحصول على دقة أعلى.
المعايير
جرى اختبار QESEM على مجموعة واسعة من حالات الاستخدام والتطبيقات. يمكن للأمثلة التالية مساعدتك في تقييم أنواع أعباء العمل التي يمكنك تشغيلها مع QESEM.
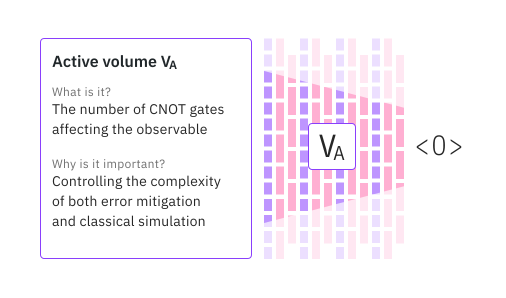
مؤشر رئيسي لقياس صعوبة كل من تخفيف الأخطاء والمحاكاة الكلاسيكية لدارة ومؤثر معينة هو الحجم الفعّال: عدد بوابات CNOT المؤثرة على المؤثر في الدارة. يعتمد الحجم الفعّال على عمق الدارة وعرضها، ووزن المؤثر، وبنية الدارة التي تُحدد المخروط الضوئي للمؤثر. لمزيد من التفاصيل، راجع الحديث من قمة IBM Quantum 2024. يُقدّم QESEM قيمة كبيرة بصفة خاصة في نظام الحجم الكبير، إذ يُعطي نتائج موثوقة للدوائر والمؤثرات العامة.
| التطبيق | عدد الكيوبتات | الجهاز | وصف الدارة | الدقة | الوقت الإجمالي | استخدام وقت التشغيل |
|---|---|---|---|---|---|---|
| دارة VQE | 8 | Eagle (r3) | 21 طبقة إجمالية، 9 قواعد قياس، سلسلة أحادية الأبعاد | 98% | 35 دقيقة | 14 دقيقة |
| Kicked Ising | 28 | Eagle (r3) | 3 طبقات فريدة × 3 خطوات، طوبولوجيا heavy-hex ثنائية الأبعاد | 97% | 22 دقيقة | 4 دقائق |
| Kicked Ising | 28 | Eagle (r3) | 3 طبقات فريدة × 8 خطوات، طوبولوجيا heavy-hex ثنائية الأبعاد | 97% | 116 دقيقة | 23 دقيقة |
| محاكاة هاميلتونيان بطريقة تروتر | 40 | Eagle (r3) | 2 طبقتان فريدتان × 10 خطوات تروتر، سلسلة أحادية الأبعاد | 97% | 3 ساعات | 25 دقيقة |
| محاكاة هاميلتونيان بطريقة تروتر | 119 | Eagle (r3) | 3 طبقات فريدة × 9 خطوات تروتر، طوبولوجيا heavy-hex ثنائية الأبعاد | 95% | 6.5 ساعات | 45 دقيقة |
| Kicked Ising | 136 | Heron (r2) | 3 طبقات فريدة × 15 خطوة، طوبولوجيا heavy-hex ثنائية الأبعاد | 99% | 52 دقيقة | 9 دقائق |
تُقاس الدقة هنا بالنسبة إلى القيمة المثالية للمرصود: ، حيث '' هي الدقة المطلقة للتخفيف (التي يحددها المستخدم)، و هي المرصود في الدارة الخالية من الضوضاء. يقيس "استخدام وقت التشغيل" استخدام المعيار في batch mode (مجموع استخدام المهام الفردية)، بينما يقيس "الوقت الإجمالي" الاستخدام في session mode (الزمن الفعلي المنقضي للتجربة)، الذي يشمل الأوقات الكلاسيكية وأوقات الاتصال الإضافية. يتوفر QESEM للتنفيذ في كلا الوضعين، بحيث يمكن للمستخدمين الاستفادة القصوى من مواردهم المتاحة.
تُحاكي دوائر Kicked Ising ذات 28 كيوبتًا بلّورة الوقت المتقطعة الشبه دورية (Discrete Time Quasicrystal) التي درسها Shinjo وآخرون (انظر arXiv 2403.16718 وQ2B24 Tokyo) على ثلاث حلقات متصلة من ibm_kawasaki. معاملات الدارة المستخدمة هنا هي ، مع حالة ابتدائية مغناطيسية . المؤثر المقيسة هي القيمة المطلقة للمغنطة . جرى تشغيل تجربة Kicked Ising ذات المقياس الأداتي على أفضل 136 كيوبت من ibm_fez؛ أُجري هذا المعيار تحديدًا عند زاوية كليفورد ، حيث يتنامى الحجم الفعّال ببطء مع عمق الدارة، مما يُتيح - مقرونًا بنسب إخلاص الجهاز العالية - تحقيق دقة عالية في وقت تشغيل قصير.
دوائر محاكاة هاميلتونيان بطريقة تروتر مخصصة لنموذج Ising بالحقل المستعرض عند زوايا كسرية: و على التوالي (انظر Q2B24 Tokyo). جرى تشغيل الدارة ذات المقياس الأداتي على أفضل 119 كيوبت من ibm_brisbane، بينما أُجريت تجربة الـ 40 كيوبتًا على أفضل سلسلة متاحة. تُبلَّغ الدقة للمغنطة؛ وقد تم الحصول على نتائج عالية الدقة للمرصودات ذات الأوزان الأعلى أيضًا.
طُوّرت دارة VQE بالتعاون مع باحثين من مركز تكنولوجيا الكم والتطبيقات في مركز سينكروترون الإلكترونات الألماني (DESY). كان المرصود المستهدف هنا هاميلتونيانًا يتألف من عدد كبير من سلاسل باولي غير المتبادلة في التبديل، مما يبرز الأداء المُحسَّن لـ QESEM في المرصودات متعددة القواعد. طُبّق التخفيف على نموذج مُحسَّن كلاسيكيًا؛ وعلى الرغم من أن هذه النتائج لا تزال غير منشورة، فإن نتائج بنفس الجودة ستُحصَّل لدوائر مختلفة ذات خصائص بنيوية مماثلة.
البدء
سجّل الدخول باستخدام مفتاح IBM Quantum Platform API، واختر دالة QESEM Qiskit كما يلي. (يفترض هذا المقتطف أنك قد حفظت حسابك بالفعل في بيئتك المحلية.)
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"qiskit": "qiskit", "qiskit_ibm_catalog": "qiskit-ibm-catalog", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import qiskit
from qiskit_ibm_catalog import QiskitFunctionsCatalog

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# verify that you have access to the function
catalog.list()
# load the function
qesem_function = catalog.load("qedma/qesem")
أمثلة
مثال مهمة تقدير الوقت
تُستخدَم مهمة تقدير الوقت لتقدير وقت QPU المطلوب لـ pub وbackend_name معينين. يمكن أيضًا ضبط backend_name على أي Backend محاكاة (simulator)؛ على سبيل المثال، fake_fez.
يستخدم QESEM طريقة تخفيف أخطاء (EM) شبه احتمالية قائمة على التوصيف (characterization-based). لهذه الطريقة عبء زمني على QPU يتوسع تقريبًا كما يلي:
حيث هي الحجم النشط للدائرة، و هي الدقة المستهدفة، و هي عدم إخلاص البوابات الأصلية.
لاحظ أن "estimate_time_only": "empirical" تستخدم بضع دقائق من وقت وحدة المعالجة الكمومية لتقدير الوقت المطلوب للمهمة (إذا كانت الخلفية جهازًا حقيقيًا؛ أما إذا كانت محاكيًا، فلن يُستخدم أي وقت من وحدة المعالجة الكمومية). عادةً ما يستغرق ذلك حوالي 5 دقائق، لكن لا يتجاوز 10 دقائق. إذا تغيّر عدم الإخلاص بشكل كبير بين مهمة تقدير الوقت التجريبي ومهمة التخفيف، فسيتغير وقت وحدة المعالجة الكمومية بشكل كبير أيضًا.
للبدء، جرّب هذا المثال الأساسي لتقدير وقت وحدة المعالجة الكمومية المطلوب لتشغيل QESEM لـ pub معيّن:
# This cell is hidden from users
from qiskit_ibm_runtime import QiskitRuntimeService

service = QiskitRuntimeService()
backend_name = service.least_busy().name
backend_name = "fake_fez"

circ = qiskit.QuantumCircuit(5)
circ.cx(0, 1)
circ.cx(2, 3)
circ.cx(1, 2)
circ.cx(3, 4)

avg_magnetization = qiskit.quantum_info.SparsePauliOp.from_sparse_list(
    [("Z", [q], 1 / 5) for q in range(5)], num_qubits=5
)
other_observable = qiskit.quantum_info.SparsePauliOp.from_sparse_list(
    [("ZZ", [0, 1], 1.0), ("XZ", [1, 4], 0.5)], num_qubits=5
)

time_estimation_job = qesem_function.run(
    pubs=[(circ, [avg_magnetization, other_observable])],
    options={
        "estimate_time_only": "empirical",
    },
    backend_name=backend_name,  # example: "fake_fez", "ibm_fez"
)
time_estimate_result = (
    time_estimation_job.result()
)  # a list of results per pub (circuit)
يصف مقتطف الكود التالي كيفية استرداد مقاييس تنفيذ مختلفة من مهمة تقدير الوقت (عند ضبط estimate_time_only):
pub_result = time_estimate_result[0]

print(
    f"The estimated QPU time for mitigation for this PUB is: {pub_result.metadata['time_estimation_sec']}"
)
print(
    f"The QPU time that this time estimation job took is (here it is 0 because we used fake_fez): {pub_result.metadata['total_qpu_time']}"
)
print(
    f"Gates fidelity measured during the experiment: {pub_result.metadata['gate_fidelities']}"
)
print(f"Total shots: {pub_result.metadata['total_shots']}")
print(f"Resource usage breakdown: {pub_result.metadata['resource_usage']}")
The estimated QPU time for mitigation for this PUB is: 300
The QPU time that this time estimation job took is (here it is 0 because we used fake_fez): 0
Gates fidelity measured during the experiment: {'CZ': 0.9951354916722668, 'ID1Q': 0.9991246627329172}
Total shots: 220000
Resource usage breakdown: {'RUNNING: MAPPING': {'CPU_TIME': 33.6066133165732, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: OPTIMIZING_FOR_HARDWARE': {'CPU_TIME': 184.53575124032795, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: WAITING_FOR_QPU': {'CPU_TIME': 0.0, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: EXECUTING_QPU': {'CPU_TIME': 0.0, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: POST_PROCESSING': {'CPU_TIME': 0.0, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}}
عند تفعيل تقدير الوقت التجريبي، تشغّل QESEM عددًا صغيرًا من الدوائر لتوفير تقدير أكثر دقة لوقت وحدة المعالجة الكمومية. نتائج التخفيف من هذه الدوائر متاحة في حقل empirical_estimation_mitigation_results الخاص بالمهمة.
بما أن هذه النتائج مشتقة من عينة محدودة من الدوائر، فهي أقل دقة بكثير من النتائج النهائية التي يتم الحصول عليها من مهمة تخفيف QESEM الكاملة. ومع ذلك، عندما تكون الدائرة صغيرة أو تكون الدقة المستهدفة منخفضة، قد يكون التخفيف الذي يتم إجراؤه أثناء تقدير الوقت التجريبي كافيًا للوصول إلى الدقة المطلوبة، وقد لا تكون مهمة التخفيف الكاملة ضرورية.
حقل empirical_estimation_mitigation_results هو قائمة من كائنات PrimitiveResult لكل مجموعة معاملات مدخلة. إذا لم تكن الدائرة معلمنة (parametrized)، فسيكون طول القائمة 1.
empirical_estimation_mitigation_results = time_estimate_result[0].metadata[
    "empirical_estimation_mitigation_results"
][0]  # a list per parameter
print("Partial results for the observables:")

print(
    f"    Mitigated expectation values: {empirical_estimation_mitigation_results.data.evs}"
)
print(
    f"    Mitigated error bars: {empirical_estimation_mitigation_results.data.stds}"
)
print(
    f"    Number of shots used for mitigation: {empirical_estimation_mitigation_results.metadata['mitigation_shots']}"
)
transpiled_circ = empirical_estimation_mitigation_results.metadata[
    "transpiled_circ"
]
print(f"    Qubit mapping: {transpiled_circ['qubit_maps']}")
print(
    f"    Number of measurement bases: {transpiled_circ['num_measurement_bases']}\n"
)

# results per obs
emp_obs_results = empirical_estimation_mitigation_results.metadata["results"][
    0
]
# print(f"Results for each observable: {results}")
print("Results for each observable:")

for i, (obs_array, result_dict) in enumerate(emp_obs_results):
    # obs_array, result_dict = results
    print(f"Observable {i+1}: {obs_array}")
    print(
        f"    QESEM mitigated value: {result_dict['qesem']['value']} \u00b1 {result_dict['qesem']['error_bar']}"
    )
Partial results for the observables:
    Mitigated expectation values: [1.00347302 1.00693905]
    Mitigated error bars: [0.00304061 0.00714276]
    Number of shots used for mitigation: 180000
    Qubit mapping: [[[0, 136], [1, 143], [2, 142], [3, 141], [4, 140]]]
    Number of measurement bases: 2

Results for each observable:
Observable 1: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
    QESEM mitigated value: 1.003473015776871 ± 0.0030406128032204015
Observable 2: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
    QESEM mitigated value: 1.0069390542613554 ± 0.0071427606736885925
مثال على مهمة تخفيف QESEM
يُنفّذ المثال التالي وظيفة QESEM:
sample_job = qesem_function.run(
    pubs=[(circ, [avg_magnetization, other_observable])],
    backend_name=backend_name,  # example: "ibm_fez"
    # options = {
    #     "estimate_time_only": "empirical",
    #     "default_precision": 0.2,  # Default precision is applied to all pubs that don't have a precision specified, see API reference for more details
    #     "max_execution_time": 3600,  # You can specify a maximum QPU time in seconds, see API reference for more details
    #     "transpilation_level": "standard",  # "minimal_with_layout_opt" for minimal transpilation, see API reference for more details
    #     "parallel_execution": True,  # True for parallel execution, see API reference for more details
    # },
)
للحصول على وصف تفصيلي لكل حقل مدخل وخيار، راجع مرجع واجهة برمجة تطبيقات QESEM. يمكنك استخدام واجهات برمجة تطبيقات Qiskit Serverless المألوفة للتحقق من حالة عبء عمل دالة Qiskit أو استرداد النتائج:
# Print the ID so you can use it later, if necessary
print(sample_job.job_id)
print(sample_job.status())
sample_result = sample_job.result()
3ac6b2df-15b0-4dc0-8f48-cf14bd20a1c8
DONE
يُظهر مقتطف الكود التالي كيفية استرداد نتائج التخفيف ومقاييس التنفيذ. تحتوي هذه على بيانات أساسية تُتيح فهمًا أعمق لكيفية تأثير المعاملات المختلفة على تنفيذ QESEM. قد تكون ذات صلة أيضًا عند كتابة ورقة بحثية مستندة إلى أبحاثك.
for pub_idx, pub_result in enumerate(
    sample_result
):  # each element in the list is a result for a different pub, here we sent only one pub
    print(f"\nPUB {pub_idx}:")
    print(
        f"  The QPU time that this job took is (here it is 0 because we used fake_fez): {pub_result.metadata['total_qpu_time']}"
    )
    print(
        f"  Gates fidelity measured during the experiment: {pub_result.metadata['gate_fidelities']}"
    )
    print(f"  Total shots: {pub_result.metadata['total_shots']}")
    print(
        f"  Number of shots used for mitigation: {pub_result.metadata['mitigation_shots']}"
    )
    print(
        f"  Resource usage breakdown: {pub_result.metadata['resource_usage']}"
    )
PUB 0:
  The QPU time that this job took is (here it is 0 because we used fake_fez): 0.0
  Gates fidelity measured during the experiment: {'CZ': 0.9953704216147041, 'ID1Q': 0.9991834123567518}
  Total shots: 446000
  Number of shots used for mitigation: 194000
  Resource usage breakdown: {'RUNNING: MAPPING': {'CPU_TIME': 32.52745003718883, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: OPTIMIZING_FOR_HARDWARE': {'CPU_TIME': 257.850521848537, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: WAITING_FOR_QPU': {'CPU_TIME': 0.0, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: EXECUTING_QPU': {'CPU_TIME': 0.0, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: POST_PROCESSING': {'CPU_TIME': 0.0, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}}
في metadata["results"]، تُجمَّع النتائج أولاً حسب مثيل الدائرة ثم حسب المُلاحَظ (observable).
print("Full QESEM mitigation results:")

for pub_idx, pub_result in enumerate(sample_result):
    print(f"\nPUB {pub_idx}:")

    print(f"  Mitigated expectation values: {pub_result.data.evs}")
    print(f"  Mitigated error bars: {pub_result.data.stds}")
    noisy_results = pub_result.metadata.get("noisy_results")
    print(f"  Unmitigated expectation values: {noisy_results.evs}")
    print(f"  Unmitigated error bars: {noisy_results.stds}")

    print("  Transpiled circuits:")
    for circ_idx, transpiled_circ in enumerate(
        pub_result.metadata["transpiled_circs"]
    ):
        print(f"    Circuit {circ_idx}:")
        # print(f"      Circuit: \n {transpiled_circ['circuit']}") # not printing it because it's long but you can see the transpiled circuit itself
        print(f"      Qubit mapping: {transpiled_circ['qubit_maps']}")
        print(
            f"      Measurement bases: {transpiled_circ['num_measurement_bases']}"
        )

    print("  Results for each observable:")
    for circ_idx, circ_results in enumerate(pub_result.metadata["results"]):
        print(f"    Circuit {circ_idx}:")
        for obs_idx, (obs_array, result_dict) in enumerate(circ_results):
            print(f"      Observable {obs_idx}: {obs_array}")
            print(
                f"        QESEM mitigated value: {result_dict['qesem']['value']} ± {result_dict['qesem']['error_bar']}"
            )
            print(
                f"        Unmitigated value: {result_dict['unmitigated']['value']} ± {result_dict['unmitigated']['error_bar']}"
            )
Full QESEM mitigation results:

PUB 0:
  Mitigated expectation values: [1.00648343 1.00636289]
  Mitigated error bars: [0.00253812 0.00693586]
  Unmitigated expectation values: [0.98031429 0.96357143]
  Unmitigated error bars: [0.00124128 0.00578812]
  Transpiled circuits:
    Circuit 0:
      Qubit mapping: [[[0, 140], [1, 141], [2, 142], [3, 143], [4, 136]]]
      Measurement bases: 2
  Results for each observable:
    Circuit 0:
      Observable 0: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
        QESEM mitigated value: 1.0064834305181962 ± 0.002538119914534849
        Unmitigated value: 0.9803142857142859 ± 0.0012412835813609938
      Observable 1: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
        QESEM mitigated value: 1.0063628870614818 ± 0.006935859820870656
        Unmitigated value: 0.9635714285714285 ± 0.005788121870526659
تفصيل النتائج الرئيسية:
mitigated: قيمة التوقع المخففة بالكامل من QESEM.unmitigated: نتيجة الضوضاء الفيزيائية الخام بدون تخفيف الأخطاء.
نتائج الاستقراء الاستدلالي (heuristic extrapolation) لـ QESEM
في تشغيل QESEM قياسي بقيمة precision عائمة مفردة، تتضمن النتائج أيضًا نقاط تحجيم الضوضاء المتاحة تلقائيًا والتي تُستخدم لاستدلال QESEM. يتم حساب هذه النقاط دون موارد إضافية من وحدة المعالجة الكمومية.
يمثل المقياس 1.0 مستوى ضوضاء الجهاز الفيزيائي مع تخفيف القراءة (REM)، بينما 2.0 هو نقطة تضخيم الضوضاء المكملة، أيضًا مع REM. تُستخدم هذه النقاط لإنتاج نتيجة qesem_heuristic.
-
qesem_heuristic: تقدير على غرار ZNE يُحسب من بيانات تحجيم الضوضاء المتاحة. حاليًا، يستخدم هذا استقراءً أسيًا. -
noise_scaling.results_with_REM: قيم التوقع عند عوامل تحجيم ضوضاء مختلفة، جميعها مع تخفيف القراءة (REM).
هناك تفصيل دقيق لكنه مهم وهو أن نتيجة المقياس 1.0 ليست نفسها نتيجة unmitigated. كلاهما يتوافق مع مستوى ضوضاء الجهاز الفيزيائي، لكن نقطة المقياس 1.0 تتضمن تخفيف القراءة، بينما unmitigated لا تتضمنه.
print("QESEM heuristic results:")

for pub_idx, pub_result in enumerate(sample_result):
    print(f"\nPUB {pub_idx}:")
    for circ_idx, circ_results in enumerate(pub_result.metadata["results"]):
        print(f"  Circuit {circ_idx}:")
        for obs_idx, (obs_array, result_dict) in enumerate(circ_results):
            print(f"    Observable {obs_idx}: {obs_array}")
            qesem_heuristic = result_dict["qesem_heuristic"][0]
            print("      QESEM heuristic:")
            print(
                f"        Value: {qesem_heuristic['value']} ± {qesem_heuristic['error_bar']}"
            )
            print(
                f"        Extrapolation: {qesem_heuristic['extrapolation']}"
            )
            print(
                f"        Scale factors: {qesem_heuristic['scale_factors']}"
            )
            noise_scaling = result_dict["noise_scaling"]
            print("      Noise scaling results:")
            print(
                f"        Scaling method: {noise_scaling['scaling_method']}"
            )
            print("        Results with Readout mitigation (REM):")
            for rem_result in sorted(
                (
                    item
                    for item in noise_scaling["results_with_REM"]
                    if item["scale"] != 0.0
                ),
                key=lambda item: item["scale"],
            ):
                print(
                    f"          Scale factor {rem_result['scale']}: {rem_result['value']} ± {rem_result['error_bar']}"
                )
QESEM heuristic results:

PUB 0:
  Circuit 0:
    Observable 0: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
      QESEM heuristic:
        Value: 1.0008161638888535 ± 0.0038859458884403964
        Extrapolation: exponential
        Scale factors: [1.0, 2.0]
      Noise scaling results:
        Scaling method: QESEM
        Results with Readout mitigation (REM):
          Scale factor 1.0: 0.9918395459270772 ± 0.0012565417579355634
          Scale factor 2.0: 0.982943441922748 ± 0.0028919278067695018
    Observable 1: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
      QESEM heuristic:
        Value: 0.9960853148925298 ± 0.013811635038961175
        Extrapolation: exponential
        Scale factors: [1.0, 2.0]
      Noise scaling results:
        Scaling method: QESEM
        Results with Readout mitigation (REM):
          Scale factor 1.0: 0.9902860583785115 ± 0.005921236914723409
          Scale factor 2.0: 0.984520565414274 ± 0.006909522262347639
تركز الأمثلة التالية على المدخلات والنتائج الخاصة بالميزة، لذلك لا تطبع مقاييس التنفيذ الكاملة في كل مرة. البيانات الوصفية عالية المستوى الموضحة سابقًا، مثل total_qpu_time وgate_fidelities وtotal_shots وmitigation_shots وresource_usage، متاحة لهذه المهام أيضًا.
يُعاد استخدام بعض المتغيرات من الأمثلة السابقة، بما في ذلك الخلفية والمُلاحَظات ومعاملات الدائرة الأساسية، أدناه للإيجاز.
يمكن أيضًا تشغيل جميع الأمثلة التالية باستخدام التقدير الزمني التجريبي (empirical time estimation). لتمكينه، مرّر "estimate_time_only": "empirical" في خيارات الدالة.
مثال على دائرة معلمنة
تُقيّم العديد من الخوارزميات نفس الدائرة عند عدة قيم معاملات. إرسال الدائرة المعلمنة كمهمة QESEM واحدة يتيح لـ QESEM مشاركة التوصيف والمعايرة عبر مثيلات الدائرة، مما يمكن أن يقلل من عبء وقت وحدة المعالجة الكمومية مقارنة بتشغيل مهام منفصلة.
يتطلب إرسال دائرة معلمنة استخدام مستوى النقل (transpilation) "minimal_with_layout_opt".
يجب أن تكون الدوائر المُرسَلة بهذا المستوى معبرة بالفعل باستخدام بوابات الأساس الخاصة بالخلفية، حسب الخلفية. عند هذا المستوى، تحافظ QESEM على البنية المُرسَلة قريبة قدر الإمكان من الدائرة المدخلة، وتحترم الحواجز أثناء التنضيد (تجميع العمليات في طبقات من بوابات ثنائية الكيوبت متوازية)، ولا تزال تتعامل تلقائيًا مع تخطيط الأجهزة إلى كيوبتات عالية الإخلاص واتصال الجهاز.
من الناحية العملية، يعني هذا أنه يجب عليك نقل الدوائر إلى بوابات الأساس الخاصة بالخلفية المستهدفة قبل الإرسال. يظهر أدناه مثال بسيط على نقل بوابات الأساس.
تدعم QESEM حاليًا مُلاحَظًا واحدًا فقط لكل مجموعة معاملات. يتم ضم صفي المعاملات أدناه مع المُلاحَظين: يُقاس الصف الأول باستخدام avg_magnetization، ويُقاس الصف الثاني باستخدام other_observable.
# Transpile to the backend basis gates only. With minimal_with_layout_opt, QESEM handles hardware mapping/connectivity and observable layout internally.
from qiskit_ibm_runtime.fake_provider import FakeFez

backend = FakeFez()
basis = backend.operation_names
print(basis)

param0 = qiskit.circuit.Parameter("param0")
param1 = qiskit.circuit.Parameter("param1")
parametrized_circ = qiskit.QuantumCircuit(5)
parametrized_circ.rx(param0, 0)
parametrized_circ.rx(param1, 1)
parametrized_circ.cx(0, 1)
parametrized_circ.cx(2, 3)
parametrized_circ.cx(1, 2)
parametrized_circ.cx(3, 4)

parametrized_circ = qiskit.transpile(
    parametrized_circ, basis_gates=basis, optimization_level=1
)
parametrized_parameter_values = [[0.5, 0.1], [0.0, 0.6]]
parametrized_observables = [avg_magnetization, other_observable]

parametrized_job = qesem_function.run(
    pubs=[
        (
            parametrized_circ,
            parametrized_observables,
            parametrized_parameter_values,
            0.1,
        )
    ],
    backend_name=backend_name,
    options={
        "max_execution_time": 300,
        "transpilation_level": "minimal_with_layout_opt",
    },
)
print(parametrized_job.job_id)
print(parametrized_job.status())
d1b0e29b-196c-4896-aec6-44a268ebd874
DONE
parametrized_result = parametrized_job.result()
print("Parameterized circuit QESEM results:")

for pub_idx, pub_result in enumerate(parametrized_result):
    print(f"\nPUB {pub_idx}:")
    print(f"  Mitigated expectation values: {pub_result.data.evs}")
    print(f"  Mitigated error bars: {pub_result.data.stds}")
    noisy_results = pub_result.metadata["noisy_results"]
    print(f"  Unmitigated expectation values: {noisy_results.evs}")
    print(f"  Unmitigated error bars: {noisy_results.stds}")
    print("  Results for each parameter value:")
    for param_idx, param_results in enumerate(pub_result.metadata["results"]):
        print(
            f"    Parameter set {param_idx}: {parametrized_parameter_values[param_idx]}"
        )
        for obs_idx, (obs_array, result_dict) in enumerate(param_results):
            print(f"      Observable {obs_idx}: {obs_array}")
            print(
                f"        QESEM mitigated value: {result_dict['qesem']['value']} ± {result_dict['qesem']['error_bar']}"
            )
            print(
                f"        Unmitigated value: {result_dict['unmitigated']['value']} ± {result_dict['unmitigated']['error_bar']}"
            )
Parameterized circuit QESEM results:

PUB 0:
  Mitigated expectation values: [0.92392021 0.82517653]
  Mitigated error bars: [0.00565281 0.00616016]
  Unmitigated expectation values: [0.9028     0.78771429]
  Unmitigated error bars: [0.00335142 0.00925413]
  Results for each parameter value:
    Parameter set 0: [0.5, 0.1]
      Observable 0: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
        QESEM mitigated value: 0.923920210615709 ± 0.005652811570890183
        Unmitigated value: 0.9028 ± 0.0033514176105045447
    Parameter set 1: [0.0, 0.6]
      Observable 0: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
        QESEM mitigated value: 0.8251765289285893 ± 0.006160161743353999
        Unmitigated value: 0.7877142857142858 ± 0.009254130564027902
مثال متعدد الـ pub
يُعد التنفيذ متعدد الـ pub مفيدًا عندما تريد تشغيل عدة دوائر مترابطة في مهمة QESEM واحدة. مثل التنفيذ المعلمن، يمكن أن يقلل هذا من العبء لأن QESEM يمكنها مشاركة التوصيف والمعايرة عبر مثيلات الدائرة بدلاً من تكرارها في مهام منفصلة.
هذا مفيد بشكل خاص للدوائر ذات بنية الطبقات المشتركة، مثل أعباء عمل من نوع Trotter، حيث تعيد الدوائر المختلفة استخدام نفس الطبقات الفريدة. في هذه الحالة، يمكن أن يؤدي تشغيلها معًا إلى تقليل تكلفة التوصيف مقارنة بمهام QESEM المستقلة.
تتطلب مهام متعددة الـ pub "transpilation_level": "minimal_with_layout_opt". كما في المثال المعلمن، يجب تحويل الدوائر إلى بوابات الأساس الخاصة بـ Backend المستهدف قبل الإرسال. تتعامل QESEM بعد ذلك داخليًا مع اتصال الجهاز وتحديد التخطيط (layout) وتعيين الدارة على كيوبتات عالية الإخلاص.
يحتوي كل PUB أدناه على دائرة واحدة ونفس المُلاحَظين المستخدمين سابقًا في الدفتر، لذا فإن PrimitiveResult المُعاد يحتوي على PubResult واحدة لكل دائرة مدخلة.
يستخدم المثال أدناه دائرتي Trotter بسيطتين بنفس نمط الطبقة: تحتوي circ_a على طبقة Trotter واحدة، وتكرر circ_b نفس نمط الطبقة مرتين. هذا يجعل البنية المشتركة واضحة.
def make_trotter_circuit(num_qubits, num_layers, zz_angle=0.2, x_angle=0.1):
    trotter_circ = qiskit.QuantumCircuit(num_qubits)
    for _ in range(num_layers):
        for q in range(num_qubits):
            trotter_circ.rx(x_angle, q)
        trotter_circ.barrier()
        for q in range(0, num_qubits - 1, 2):
            trotter_circ.rzz(zz_angle, q, q + 1)
        trotter_circ.barrier()
        for q in range(1, num_qubits - 1, 2):
            trotter_circ.rzz(zz_angle, q, q + 1)
        trotter_circ.barrier()
    return trotter_circ

circ_a = make_trotter_circuit(num_qubits=5, num_layers=1)
circ_b = make_trotter_circuit(num_qubits=5, num_layers=2)
multi_pubs = [
    (
        qiskit.transpile(qci, basis_gates=basis, optimization_level=1),
        [avg_magnetization, other_observable],
    )
    for qci in [circ_a, circ_b]
]

multi_circ_job = qesem_function.run(
    pubs=multi_pubs,
    backend_name=backend_name,
    options={
        "max_execution_time": 300,
        "transpilation_level": "minimal_with_layout_opt",
        "default_precision": 0.1,
    },
)
print(multi_circ_job.job_id)
print(multi_circ_job.status())
e34565b8-7262-4133-a120-de42ce624a99
DONE
multi_circ_result = multi_circ_job.result()
print("Multi-pub QESEM results:")

for pub_idx, pub_result in enumerate(multi_circ_result):
    print(f"\nPUB {pub_idx}:")
    print(f"  Mitigated expectation values: {pub_result.data.evs}")
    print(f"  Mitigated error bars: {pub_result.data.stds}")
    noisy_results = pub_result.metadata["noisy_results"]
    print(f"  Unmitigated expectation values: {noisy_results.evs}")
    print(f"  Unmitigated error bars: {noisy_results.stds}")
    print("  Results for each observable:")
    for circ_idx, circ_results in enumerate(pub_result.metadata["results"]):
        print(f"    Circuit {circ_idx}:")
        for obs_idx, (obs_array, result_dict) in enumerate(circ_results):
            print(f"      Observable {obs_idx}: {obs_array}")
            print(
                f"        QESEM mitigated value: {result_dict['qesem']['value']} ± {result_dict['qesem']['error_bar']}"
            )
            print(
                f"        Unmitigated value: {result_dict['unmitigated']['value']} ± {result_dict['unmitigated']['error_bar']}"
            )
Multi-pub QESEM results:

PUB 0:
  Mitigated expectation values: [0.99502406 1.02209332]
  Mitigated error bars: [0.00483819 0.00707488]
  Unmitigated expectation values: [0.96934286 0.97271429]
  Unmitigated error bars: [0.00124855 0.00617294]
  Results for each observable:
    Circuit 0:
      Observable 0: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
        QESEM mitigated value: 0.9950240647925642 ± 0.004838188086259301
        Unmitigated value: 0.9693428571428573 ± 0.0012485470362492692
      Observable 1: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
        QESEM mitigated value: 1.0220933230604674 ± 0.007074884384355636
        Unmitigated value: 0.9727142857142859 ± 0.006172939375512439

PUB 1:
  Mitigated expectation values: [0.98850017 1.02555188]
  Mitigated error bars: [0.0077912  0.01672652]
  Unmitigated expectation values: [0.93682857 0.95371429]
  Unmitigated error bars: [0.00156245 0.00665735]
  Results for each observable:
    Circuit 0:
      Observable 0: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
        QESEM mitigated value: 0.988500171577252 ± 0.007791203181151346
        Unmitigated value: 0.9368285714285716 ± 0.001562451883089579
      Observable 1: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
        QESEM mitigated value: 1.02555188098689 ± 0.016726524388086233
        Unmitigated value: 0.9537142857142858 ± 0.006657345655544263
مثال على ضبط الأخطاء شبه الاحتمالي (QET)
يطلب ضبط الأخطاء شبه الاحتمالي (QET) قيم توقع عند عوامل تحجيم ضوضاء مختارة. هذا مفيد لدراسات تحجيم الضوضاء المخصصة وسير عمل الاستقراء إلى الضوضاء الصفرية. المقياس 1.0 هو مستوى الضوضاء الفيزيائية، والقيم بين 0.0 و1.0 تقلل الضوضاء جزئيًا، والقيم أعلى من 1.0 تضخم الضوضاء.
لاستخدام QET مع دالة Qiskit، مرر قاموسًا كدقة PUB. يربط القاموس كل عامل تحجيم ضوضاء مطلوب بدقته المستهدفة. تُخزَّن نتائج عوامل التحجيم المُعادة في noise_scaling.results_with_REM وتتضمن تخفيف القراءة. لذلك فإن نقطة المقياس 1.0 ليست مطابقة للقيمة غير المخففة، لأن 1.0 تتضمن تخفيف القراءة بينما unmitigated لا تتضمنه.
عند طلب مقياس، تُعيد QESEM أيضًا المقياس المكمل حول 1.0 دون استخدام إضافي لوحدة المعالجة الكمومية. على سبيل المثال، يمكن أن يعيد طلب 0.5 أيضًا 1.5، ويمكن أن يعيد طلب 1.3 أيضًا 0.7. الدقة على المقياس المكمل غير مضمونة.
noise_scale_precision = {0.5: 0.15, 1.3: 0.2}

qet_job = qesem_function.run(
    pubs=[
        (
            circ,
            [avg_magnetization, other_observable],
            None,
            noise_scale_precision,
        )
    ],
    backend_name=backend_name,
    options={"max_execution_time": 300},
)
print(qet_job.job_id)
print(qet_job.status())
8195fa58-f037-4651-8715-36ce1cdc5521
DONE
qet_result = qet_job.result()
print("QET noise-scaling results:")

for pub_idx, pub_result in enumerate(qet_result):
    print(f"\nPUB {pub_idx}:")
    noisy_results = pub_result.metadata["noisy_results"]
    print(f"  Unmitigated expectation values: {noisy_results.evs}")
    print(f"  Unmitigated error bars: {noisy_results.stds}")
    print("  Results for each observable:")
    for circ_idx, circ_results in enumerate(pub_result.metadata["results"]):
        print(f"    Circuit {circ_idx}:")
        for obs_idx, (obs_array, result_dict) in enumerate(circ_results):
            print(f"      Observable {obs_idx}: {obs_array}")
            noise_scaling = result_dict["noise_scaling"]
            print(
                f"        Scaling method: {noise_scaling['scaling_method']}"
            )
            print("        Results with Readout mitigation (REM):")
            for rem_result in sorted(
                (
                    item
                    for item in noise_scaling["results_with_REM"]
                    if item["scale"] != 0.0
                ),
                key=lambda item: item["scale"],
            ):
                print(
                    f"          Scale factor {rem_result['scale']}: {rem_result['value']} ± {rem_result['error_bar']}"
                )
QET noise-scaling results:

PUB 0:
  Unmitigated expectation values: [0.97822857 0.96171429]
  Unmitigated error bars: [0.00123812 0.00672958]
  Results for each observable:
    Circuit 0:
      Observable 0: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
        Scaling method: QESEM
        Results with Readout mitigation (REM):
          Scale factor 0.5: 0.9938730340199383 ± 0.0032116907357568275
          Scale factor 0.7: 0.9963976191853445 ± 0.00036300258869586616
          Scale factor 1.0: 0.9898115079506586 ± 0.0012525947426560995
          Scale factor 1.3: 0.9864667065580341 ± 0.002633221613518526
          Scale factor 1.5: 0.9838755527197551 ± 0.002948417797996015
      Observable 1: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
        Scaling method: QESEM
        Results with Readout mitigation (REM):
          Scale factor 0.5: 1.0006538544450332 ± 0.002121742014777343
          Scale factor 0.7: 1.0004159801523036 ± 0.0021671375357823794
          Scale factor 1.0: 0.9898058846339917 ± 0.00690183710903159
          Scale factor 1.3: 0.9948946719997267 ± 0.002146532859610311
          Scale factor 1.5: 0.9927220368192772 ± 0.0020875057190323882
استرداد رسائل الخطأ
إذا كانت حالة عبء عملك هي ERROR، استخدم job.result() لاسترداد رسالة الخطأ كما يلي:
# Get the result and truncate for readability
result = sample_job.result()
result_str = str(result)
max_length = 500  # Adjust this value as necessary

if len(result_str) > max_length:
    truncated = (
        result_str[:max_length]
        + f"... (truncated {len(result_str) - max_length} characters)"
    )
else:
    truncated = result_str

print(truncated)
PrimitiveResult([PubResult(data=DataBin(evs=np.ndarray(<shape=(2,), dtype=float64>), stds=np.ndarray(<shape=(2,), dtype=float64>), shape=(2,)), metadata={'gate_fidelities': {'CZ': 0.9979444718552628, 'ID1Q': 0.9991994239814883}, 'total_shots': 498600, 'mitigation_shots': 223400, 'transpiled_circs': [{'circuit': 'OPENQASM 3.0;\ninclude "stdgates.inc";\nbit[76] c0;\nqubit[76] q0;\nrx(0) q0[54];\nrx(0) q0[59];\nrx(0) q0[75];\nrz(pi/2) q0[54];\nrz(pi/2) q0[59];\nrz(pi/2) q0[75];\nrx(pi/2) q0[54];\nr... (truncated 3771 characters)
الحصول على الدعم
فريق دعم Qedma هنا لمساعدتك! إذا واجهت أي مشكلات أو لديك أسئلة حول استخدام دالة QESEM Qiskit، لا تتردد في التواصل معنا. موظفو الدعم المتمرسون والودودون لدينا مستعدون لمساعدتك في أي مخاوف أو استفسارات تقنية قد تكون لديك.
يمكنك مراسلتنا عبر البريد الإلكتروني على support@qedma.com للحصول على المساعدة. يُرجى تضمين أكبر قدر ممكن من التفاصيل حول المشكلة التي تواجهها لمساعدتنا في تقديم استجابة سريعة ودقيقة. يمكنك أيضًا التواصل مع ممثل Qedma POC المخصص لك عبر البريد الإلكتروني أو الهاتف.
لمساعدتنا في خدمتك بكفاءة أكبر، يُرجى تقديم المعلومات التالية عند التواصل معنا:
-
وصف تفصيلي للمشكلة
-
معرّف الوظيفة (Job ID)
-
أي رسائل خطأ أو رموز ذات صلة
نحن ملتزمون بتزويدك بدعم سريع وفعّال لضمان حصولك على أفضل تجربة ممكنة مع دالة Qiskit الخاصة بنا.
نحن نسعى دائمًا إلى تحسين منتجنا ونرحّب باقتراحاتك! إذا كان لديك أفكار حول كيفية تحسين خدماتنا أو ميزات تودّ رؤيتها، يُرجى إرسال أفكارك إلى support@qedma.com.
الخطوات التالية
-
تفضّل بزيارة مرجع واجهة برمجة التطبيقات لدالة Qiskit هذه.
-
جرّب البرنامج التعليمي محاكاة نموذج إيزنغ ثنائي الأبعاد ذو المجال المائل باستخدام دالة QESEM.