تعلّم الحالات الكمية المشوشة باستخدام الظلال الكلاسيكية
تقدير الاستخدام: 34 دقيقة على معالج Heron r2 (ملاحظة: هذا تقدير فقط. قد يختلف زمن التشغيل لديك.)
نواتج التعلم
-
اجمع قياسات عشوائية على معالج كمي من IBM® باستخدام Julia واحفظها لتحليلها لاحقًا
-
افحص بيانات القياس بحثًا عن كيوبتات وبوابات معطوبة قبل التعلّم
-
ملاءمة نموذج مؤثر حاصل ضرب مصفوفات (MPO) لحالة مشوشة مع الظلال الكلاسيكية
-
تحقق من صحة النموذج على قياسات محجوزة وقارنه بالدائرة المثالية
المتطلبات الأساسية
-
الظلال الكلاسيكية، كما قُدمت في درس التصوير الظلي لحالة غرينبرغر-هورن-زايلنغر (GHZ) التعليمي
-
المصفوفات الكثافية والحالات المختلطة، المشروحة في أساسيات المعلومات الكمية
-
تشغيل الدوائر من Julia باستخدام
Qiskit.jlوQiskitIBMRuntime.jl، كما قُدّم في درس محاكاة التطور الزمني لنموذج إيزينغ ذي الحقل المستعرض التعليمي
الخلفية
على معالج كمي حقيقي، تحوّل الضوضاء الحالة النقية التي صُممت الدائرة لتحضيرها إلى حالة مختلطة . يمكن لتصوير الحالة الكمية الكامل أن يعيد بناء ، لكن عدد القياسات التي يحتاجها ينمو أسيًا مع عدد الكيوبتات. أما Votto وآخرون [1] فقد تعلموا بدلًا من ذلك نموذجًا مدمجًا لـ لما يصل إلى 96 كيوبت انطلاقًا من قياسات عشوائية. ويتبع هذا الدرس سير عملهم.
في القياس العشوائي [2]، يُدوَّر كل كيوبت بواسطة وحدوي عشوائي مستقل ثم يُقاس في الأساس الحسابي. تسمى سحبة واحدة من الدورانات إعداد قياس، ويُكرَّر كل إعداد لـ لقطة. وتعطي اللقطة ذات بتات النتيجة الظل الكلاسيكي [3]
الذي يساوي متوسطه على الإعدادات واللقطات . يسحب الدرس التعليمي المطلوب مسبقًا كل من الأسس الثلاثة لباولي؛ أما هذا الدرس، مثل الورقة، فيسحبها بانتظام من جميع الوحدويات أحادية الكيوبت (عشوائية بمقياس هار)، وتنطبق الصيغة نفسها.
تقدّر الظلال خصائص بضعة كيوبتات في كل مرة. تجمعها الورقة في مؤثر حاصل ضرب مصفوفات (MPO)، الذي يكتب المصفوفة الكثافية على شكل سلسلة من موترات صغيرة، واحد لكل كيوبت؛ والحالات المشوشة ذات الارتباطات قصيرة المدى لا تحتاج إلا إلى روابط صغيرة بين الموترات المتجاورة. وعلى غرار خوارزمية مجموعة إعادة التطبيع للمصفوفة الكثافية (DMRG)، يمسح المتعلّم السلسلة ويحدّث موترًا واحدًا في كل مرة، بحيث يطابق النموذج الظلال على نافذة من كيوبت متمركزة حول ذلك الموتر (المعادلة 4 في الورقة). يظل بُعد الرابطة ثابتًا خلال هذه التحديثات، ولذلك لا يقتطع المتعلّم النموذج أبدًا. ولأن البيانات تدخل عبر هذه النوافذ فقط، فإن عدد الإعدادات المطلوبة لا ينمو مع طول السلسلة.
تُقسَّم الإعدادات إلى مجموعة تدريب ومجموعة اختبار. وعلى مجموعة الاختبار، تقدّر الورقة أقصى دقة تطابق بين والنموذج ،
قياس مباشرة يتطلب عددًا أسيًا من القياسات. وبدلًا من ذلك تفترض الورقة شرط التحليل التقريبي (AFC): تضمحل الارتباطات في ضمن بضعة كيوبتات، فتتحلل التداخلات والنقاوات العامة إلى حدود على كتل من كيوبتات متجاورة. وتعطي النقاوة أيضًا إنتروبيا ريني-2 ، التي تقيس مدى اختلاط الحالة.
تحضّر الورقة حالة إيزينغ المركولة ذات العمق
على 96 كيوبت من ibm_brisbane، وهو معالج Eagle، مع 2,048 إعدادًا من 1,024 لقطة عند . يعرض الشكل 1(c,d) في الورقة نتيجتين عند :
-
يصل النموذج المتعلَّم إلى مع الحالة التجريبية عند ، وهو أعلى بكثير من تداخل الحالة المثالية مع التجربة.
-
تنمو الإنتروبيا خطيًا، ، وتتفق إنتروبيا النموذج مع تقدير مستقل من مجموعة الاختبار.
يتحقق هذا الدرس من النتيجتين، أولًا في محاكاة بثمانية كيوبتات تُعرف فيها الإجابات الدقيقة، ثم في تشغيل جديد بـ 96 كيوبت على ibm_fez، وهو معالج Heron r2. المتعلّم تنفيذ مستقل بلغة Julia للمعادلات الواردة في الورقة وملحقها.
المتطلبات
يتطلب هذا الدرس نظام macOS أو Linux، لأن Qiskit.jl لا يدعم Windows بعد (Qiskit.jl issue #15). وتحتاج أيضًا إلى ما يلي:
-
Julia 1.11، من صفحة تنزيل Julia أو باستخدام
juliaup add 1.11، وحزمةIJulia:julia -e 'using Pkg; Pkg.add("IJulia")' -
لمثال العتاد، حساب IBM Quantum® Platform مع وصول إلى QPU فيه 96 كيوبت على الأقل، وبيانات اعتماد محفوظة. وبدون حساب، يمكنك تشغيل مثال العتاد من القياسات المحفوظة لتشغيل
ibm_fezالذي أنتج النتائج في هذا الدرس. أما الأقسام الأخرى فتعمل بدون حساب.
يستخدم الدفتر Qiskit.jl وQiskitIBMRuntime.jl لبناء الدوائر وتشغيلها، وRandomMeas.jl [4] للقياسات العشوائية (وهو يوفر أيضًا ITensors.jl وITensorMPS.jl)، وNPZ.jl وJSON.jl وPlots.jl. اختُبر هذا الدرس مع Qiskit.jl 0.6.1 وQiskitIBMRuntime.jl 0.3.2 وRandomMeas.jl 0.3.1.
هناك طريقتان لإعداد البيئة:
-
الخيار 1: ثبّت أحدث الإصدارات المتوافقة من الحزم في بيئة مؤقتة. شغّل الخلية التالية دون تغييرات.
-
الخيار 2: أعد إنتاج البيئة المختبرة تمامًا. اضبط
download_toml_files = trueفي الخلية التالية. تنزّل الخليةProject.tomlوManifest.tomlمن مستودع التوثيق إلى مجلدenv_tutorial/classical-shadows/بجوار هذا الدفتر، ثم تثبّت الإصدار الدقيق لكل حزمة يسجلها ملف manifest، بما في ذلك الاعتماديات غير المباشرة. للتفاصيل، راجع توثيق Julia حول هذه الملفات.
using Pkg
using Downloads

download_toml_files = false

if !download_toml_files
    # Option 1: Install the latest compatible versions into a temporary environment
    Pkg.activate(mktempdir(); io=devnull)
    Pkg.add([
        PackageSpec(name="Qiskit", version="0.6"),
        PackageSpec(name="QiskitIBMRuntime", version="0.3"),
        PackageSpec(name="RandomMeas", version="0.3"),
        PackageSpec(name="NPZ"),
        PackageSpec(name="JSON"),
        PackageSpec(name="Plots"),
    ]; io=devnull)
else
    # Option 2: Install the exact tested versions recorded in Project.toml and Manifest.toml
    base_url = "https://raw.githubusercontent.com/Qiskit/documentation/main/docs/tutorials/assets/classical-shadows/julia"
    env_dir = joinpath(@__DIR__, "env_tutorial", "classical-shadows")
    mkpath(env_dir)
    for file in ("Project.toml", "Manifest.toml")
        Downloads.download("$base_url/$file", joinpath(env_dir, file))
    end
    Pkg.activate(env_dir; io=devnull)
    Pkg.instantiate(; io=devnull)
end
الإعداد
using RandomMeas  # also loads ITensors and ITensorMPS
using Qiskit, QiskitIBMRuntime
using Random, LinearAlgebra, Statistics
using Downloads, SHA, NPZ, JSON, Plots

# Download the helper module that implements the learner, unless a copy exists
docs_url = "https://raw.githubusercontent.com/Qiskit/documentation/main"
helper_file = joinpath(@__DIR__, "env_tutorial", "classical-shadows", "mpo_learning.jl")
if !isfile(helper_file)
    mkpath(dirname(helper_file))
    helper_url = "$docs_url/docs/tutorials/assets/classical-shadows/julia/mpo_learning.jl"
    Downloads.download(helper_url, helper_file)
end
include(helper_file)
using .ShadowMPOLearning
BLAS.set_num_threads(1)  # the learner multiplies many small matrices
تنفّذ الوحدة المساعدة mpo_learning.jl، التي تنزّلها خلية الإعداد، المتعلّم. يستدعي الدرس منها الدوال التالية:
| الدالة | الغرض |
|---|---|
kicked_ising_reference(N, D; depolarization) | MPO الدقيق لحالة إيزينغ المركولة المثالية، أو للحالة بعد ضوضاء إزالة استقطاب محلية |
split_settings(group; seed, train_fraction) | تعيين إعدادات القياس عشوائيًا إلى مجموعتي التدريب والاختبار (النصف لكل منهما افتراضيًا) |
training_marginals(train; ell, prior) | تقديرات الظلال لكل نافذة تعلّم، من إعدادات التدريب فقط |
fitted_prior(ideal, train) | الأولية للقياسات العشوائية المشتركة (CRM)، مُلاءمة لنقاوة كل نافذة المقيسة، كما في الورقة |
learn_mpo(marginals, N; ell, maxbond, sweeps) | مسح تحديث الموقع الواحد الوارد في الورقة على طول السلسلة، بدءًا من الحالة المختلطة تمامًا |
max_fidelity(a, b), mpo_overlap(a, b) | قيمة الدقيقة و بين MPO اثنين |
afc_estimate, afc_statistics, afc_prefix_curve | تقديرات AFC لـ و من إعدادات الاختبار، مع أشرطة خطأ جاكنايف |
يخزّن المتعلّم MPO في أساس باولي. وهذا يُبقي النموذج هيرميتيًا بأثر واحد، لكنه لا يفرض أن يكون النموذج شبه معرّف موجب، ولذلك يبلغ الدفتر عن مدى سالبية قيمه الذاتية.
مثال المحاكي صغير النطاق
ابدأ بنظام صغير بما يكفي لحساب كل شيء بدقة: حالة إيزينغ المركولة ذات العمق واحد على ثمانية كيوبتات، مع إزالة استقطاب محلية بنسبة 12% لنمذجة العتاد. ولأن الحالة المشوشة معروفة، يمكنك مقارنة النموذج المتعلَّم بها مباشرة.
الخطوة 1: ربط المدخلات الكلاسيكية بمسألة كمية
تعيد الدالة kicked_ising_reference الحالة الدقيقة على شكل MPO. وعند depolarization=0.12، ينكمش متجه بلوخ لكل كيوبت بنسبة 12% بعد الدائرة.
N = 8
ideal = kicked_ising_reference(N, 1)
rho = kicked_ising_reference(N, 1; depolarization=0.12)
println("Purity of the noisy state: ", round(mpo_overlap(rho, rho), digits=3))
println("F_max between the noisy and ideal states: ", round(max_fidelity(rho, ideal), digits=3))
Purity of the noisy state: 0.327
F_max between the noisy and ideal states: 0.56
الخطوة 2: تحسين المسألة للتنفيذ على العتاد الكمي
يأخذ هذا المثال عينات من نتائج القياس كلاسيكيًا، ولذلك لا توجد دائرة لتحويلها بالـ transpile. يغطي مثال العتاد هذه الخطوة.
الخطوة 3: التنفيذ باستخدام Qiskit primitives
استخدم RandomMeas.jl لسحب 2,048 إعداد قياس عشوائي بمقياس هار وخذ 256 لقطة من كل منها، ثم قسّم الإعدادات بالتساوي إلى مجموعتي تدريب واختبار. قسّم حسب الإعداد لا حسب اللقطة: اللقطات من الإعداد نفسه تتشارك دوراناته، ولذلك فهي ليست مستقلة.
Random.seed!(20260921)
sites = siteinds("Qubit", N)
settings = [LocalUnitaryMeasurementSetting(N; site_indices=sites, ensemble=Haar) for _ in 1:2048]
measurements = MeasurementGroup(to_itensor_mpo(rho, sites), settings, 256)
split = split_settings(measurements; seed=20260921)
println(length(split.train_ids), " training settings, ", length(split.test_ids), " testing settings")
1024 training settings,
1024 testing settings
الخطوة 4: المعالجة اللاحقة وإرجاع النتيجة بالصيغة الكلاسيكية المطلوبة
تعلّم النموذج بمعاملات الورقة للعمق واحد: نوافذ تمتد كيوبت على كل جانب من الموتر المحدَّث، وبُعد رابطة يساوي 4، و20 مسحة بدءًا من الحالة المختلطة تمامًا. تحدّث المسحة الأولى أزواج الموترات المتجاورة، مما يتيح لبُعد الرابطة أن ينمو من 1 إلى 4؛ وتحدّث كل مسحة لاحقة موترًا واحدًا في كل مرة عند بُعد الرابطة الثابت ذاك.
لتقليل الضوضاء الإحصائية للظلال، تستخدم الورقة القياسات العشوائية المشتركة (CRM) [5]. في كل إعداد، تطرح متوسط الظل الذي سينتجه تخمين أولي للحالة في الإعداد نفسه، ثم تضيف القيمة الدقيقة للتخمين الأولي. يتلاشى متوسط التصحيح إلى الصفر، ولذلك يغيّر التخمين الأولي حجم الخطأ الإحصائي لكنه لا يغيّر ما يُقدَّر. هنا التخمين الأولي هو الحالة المثالية مع إزالة استقطاب محلية بنسبة 10%، وهي قريبة من النسبة الحقيقية 12%. وعلى العتاد، يكون مستوى الضوضاء مجهولًا، ولذلك يلاءم مثال العتاد التخمين الأولي مع نقاوات مقيسة بدلًا من ذلك، كما تفعل الورقة.
prior = kicked_ising_reference(N, 1; depolarization=0.10)
marginals = training_marginals(split.train; ell=2, prior)
fit = learn_mpo(marginals, N; ell=2, maxbond=4, sweeps=20)
sigma = fit.model
plot([h.sweep for h in fit.history], [h.local_loss for h in fit.history];
    xlabel="sweep", ylabel="mean squared residual", label="training windows",
    size=(680, 320), left_margin=5Plots.mm, bottom_margin=5Plots.mm)
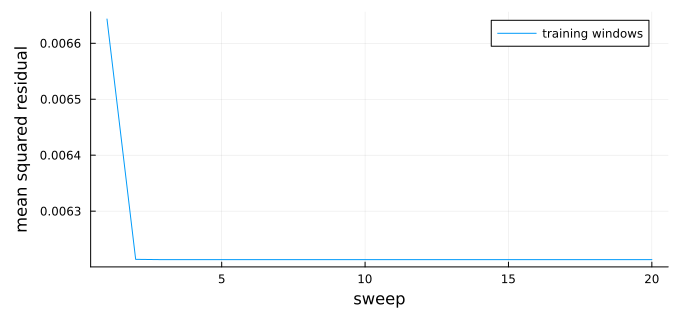
يقيس المتبقي مدى بُعد نوافذ النموذج عن ظلال التدريب. ينخفض عندما تبدأ تحديثات الموقع الواحد، في المسحة الثانية، ثم يبقى ثابتًا تقريبًا بدلًا من أن يصل إلى الصفر، لأن الظلال تحتوي ضوضاء إحصائية لا يستطيع نموذج ببُعد رابطة صغير إعادة إنتاجها.
ولأن هذه الحالة معروفة، يمكنك مقارنة النموذج المتعلَّم بها بدقة، ومقارنة أبسط تخمينين بها أيضًا: التخمين الأولي لـ CRM والحالة المثالية.
eigenvalues = eigvals(Hermitian(dense_operator(sigma)))
println("F_max with the noisy state")
println("  learned model: ", round(max_fidelity(rho, sigma), digits=3))
println("  CRM prior:     ", round(max_fidelity(rho, prior), digits=3))
println("  ideal state:   ", round(max_fidelity(rho, ideal), digits=3))
println("Most negative eigenvalue of the model: ", round(minimum(eigenvalues), digits=4))
println("Total negative eigenvalue weight:      ", round(-sum(min.(eigenvalues, 0)), digits=4))
F_max with the noisy state
learned model: 0.993
  CRM prior:     0.911
  ideal state:   0.56
Most negative eigenvalue of the model: -0.0076
Total negative eigenvalue weight:      0.0348
النموذج المتعلَّم أقرب إلى الحالة المشوشة من التخمين الأولي ومن الحالة المثالية، ولذلك فقد تعلّم الضوضاء من البيانات. وتأتي قيمه الذاتية السالبة الصغيرة من العدد المحدود للقياسات.
على العتاد، تكون الحالة مجهولة، ولذلك تقدّر من إعدادات الاختبار بدلًا من ذلك. يقسّم AFC السلسلة إلى كتل من كيوبتات ويقرّب النقاوة بالعلاقة
و بالنسبة نفسها من التداخلات المحلية. عندما ، تغطي الكتلتان الكيوبتات الثمانية كلها وتكون الصيغة دقيقة؛ وعندما ، تعتمد على افتراض التحليل إلى عوامل. أشرطة الخطأ الخاصة بطريقة jackknife، التي تستبعد إعداد اختبار واحدًا في كل مرة، تغطي الخطأ الإحصائي لبيانات الاختبار فقط، وليس عشوائية التدريب أو تقريب AFC.
for k in (2, 4)
    estimate = afc_estimate(sigma, split.test; k, statistics=afc_statistics(split.test, k; prior))
    println("k = $k: held-out F_max = ", round(estimate.fidelity, digits=3), " ± ",
        round(estimate.fidelity_sem, digits=3))
end
println("Exact F_max:              ", round(max_fidelity(rho, sigma), digits=3))
k = 2: held-out F_max = 0.966
± 0.036
k = 4: held-out F_max =
0.958 ± 0.049
Exact F_max:              0.993
كلا التقديرين على البيانات المحجوزة يتطابقان مع القيمة الدقيقة ضمن أشرطة الخطأ.
مثال على عتاد واسع النطاق
شغّل الآن التجربة على سلسلة من 96 كيوبت على ibm_fez، وهو معالج Heron r2. مثل ibm_brisbane، لديه خريطة اقتران heavy-hex ومستوى ضوضاء مشابه.
جمع البيانات يتطلب 1,024 مهمة Sampler وحوالي 34 دقيقة من وقت QPU. إذا لم يكن لديك وصول إلى QPU يحتوي على 96 كيوبت على الأقل، أو كان الطابور طويلًا، شغّل مثال العتاد من القياسات المسجلة على ibm_fez في 27 سبتمبر 2026، والتي أنتجت النتائج المعروضة في هذا الدرس. مع use_saved_data = true، ينزّل الدفتر هذه القياسات (15 ميغابايت) من Zenodo [6] في الخطوة 1 ويتخطى إرسال المهام في الخطوة 3. لجمع بياناتك الخاصة، اضبطه على false.
use_saved_data = true; # set to false to collect new measurements on hardware
الخطوة 1: ربط المدخلات الكلاسيكية بمسألة كمّية
كل إعداد يحتاج إلى دائرة واحدة: دائرة kicked-Ising، وبوابة على كل كيوبت من أجل ، وقياس لكل كيوبت. أخذ العينات ، مع و و موزعة بانتظام في ، يجعل عشوائيًا وفق مقياس Haar. تعيد الدالة u3_matrix مصفوفة ، التي تستخدمها الخطوة 4.
الميزانية هي 1,024 إعدادًا بـ 1,024 لقطة لكل منها، أي نصف عدد الإعدادات في الورقة، مقسمة بالتساوي بين التدريب والاختبار. مع البيانات المحفوظة، تحمّل الخلية الزوايا المسجلة. وإلا فإنها تولّد زوايا جديدة وتحفظها قبل أن ترسل أي شيء، لأنك لا تستطيع تحليل النتائج بدونها. إذا كان الملف موجودًا بالفعل، تحمّله الخلية، بحيث تظل الزوايا متطابقة مع النتائج المحفوظة بعد إعادة تشغيل الجلسة.
"Matrix of the U(θ, ϕ, λ) gate, as used by `qc.u` in Qiskit."
u3_matrix(θ, ϕ, λ) = [cos(θ/2)              -exp(im*λ)*sin(θ/2);
                      exp(im*ϕ)*sin(θ/2)    exp(im*(ϕ + λ))*cos(θ/2)]

"Angles (θ, ϕ, λ) for which `u3_matrix(θ, ϕ, λ)` is a Haar-random unitary."
random_u3_angles() = (2asin(sqrt(rand())), 2π*rand(), 2π*rand())

N_hw, NU_hw, NM_hw = 96, 1024, 1024
data_directory = joinpath(@__DIR__, "classical-shadows-data")
saved_file = joinpath(data_directory, "ibm-fez-run.npz")
run_directory = joinpath(data_directory, "new-run")
settings_file = joinpath(run_directory, "settings.npz")
if use_saved_data
    saved_url = "https://zenodo.org/records/24116174/files/ibm-fez-run.npz?download=1"
    saved_sha256 = "c42f4d8d42e5083e9e152b4fec0846884ebe3be003e5ab528deebf4f00c9fe50"
    if !isfile(saved_file)
        mkpath(data_directory)
        println("Downloading the saved ibm_fez run (15 MB)...")
        Downloads.download(saved_url, saved_file * ".part")
        mv(saved_file * ".part", saved_file)
    end
    bytes2hex(open(sha256, saved_file)) == saved_sha256 ||
        error("$saved_file is incomplete or corrupted; delete it and run this cell again")
    saved_run = npzread(saved_file)
    angles = saved_run["angles"]
elseif isfile(settings_file)
    angles = npzread(settings_file)["angles"]
else
    mkpath(joinpath(run_directory, "outcomes"))
    Random.seed!(20260927)
    angles = Array{Float64}(undef, NU_hw, N_hw, 3)
    for r in 1:NU_hw, i in 1:N_hw
        angles[r, i, :] .= random_u3_angles()
    end
    npzwrite(settings_file, Dict("angles" => angles))
end
println("Measurement settings: ", size(angles, 1), " × ", size(angles, 2), " qubits")
Measurement settings: 1024
× 96 qubits
الخطوة 2: تحسين المسألة للتنفيذ على العتاد الكمّي
السلسلة بقوة أضعف كيوبت فيها، لذلك اختر الكيوبتات الفيزيائية الـ 96 بنفسك. الدالة transpile في Qiskit.jl لا تقبل بعد تخطيطًا أوليًا ثابتًا، وفي اختبار على ibm_phoenix، احتوى التخطيط الذي اختارته على كيوبت بخطأ قراءة 51%. السلسلة التالية هي المسار المكوّن من 96 كيوبت في خريطة اقتران ibm_fez الذي اختاره التخطيط الواعي بالأخطاء في الدالة transpile من Qiskit بلغة Python (مع optimization_level=3) من بيانات المعايرة بتاريخ 27 سبتمبر 2026. متوسط خطأ القراءة فيها 1.6%، لكن شبكة heavy-hex فيها مسارات قليلة من 96 كيوبت، وهذه تتضمن الكيوبت 35 الذي لديه خطأ قراءة 15%. المعايرات تتغير، لذلك اختر سلسلة جديدة من بيانات المعايرة الحالية قبل التشغيل في يوم آخر أو على QPU آخر.
للإبقاء على هذه السلسلة، اكتب الدوائر مباشرة بالبوابات الأصلية بدل تحويلها بالـ transpile. بوابة تساوي حتى طور عام. يغطي هذا التحليل كلًا من الدورانات العشوائية والركلة . البوابة تساوي بوابة CZ يتبعها على كلا الكيوبتين، حتى طور عام. ولأن بوابات هذه قطرية، فإنها تتبادل مع بوابات CZ، لذلك يجمع كل كيوبت واحدًا لكل رابطة قبل دوران القياس الخاص به.
num_device_qubits = 156
# Physical qubits of ibm_fez, in IBM numbering, forming the chain
chain_physical = [
    2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15, 19, 35, 34, 33, 39, 53, 54, 55, 59, 75, 74,
    73, 79, 93, 94, 95, 99, 115, 114, 113, 119, 133, 132, 131, 130, 129, 128, 127, 137, 147, 146,
    145, 144, 143, 136, 123, 124, 125, 117, 105, 106, 107, 108, 109, 110, 111, 98, 91, 90, 89,
    88, 87, 86, 85, 77, 65, 66, 67, 68, 69, 70, 71, 58, 51, 50, 49, 48, 47, 46, 45, 37, 25, 24,
    23, 22, 21, 36, 41, 42, 43, 56, 63]
chain = chain_physical .+ 1  # Qiskit.jl numbers qubits from 1

"Apply U(θ, ϕ, λ) to qubit q with native gates: rz(λ), sx, rz(θ + π), sx, rz(ϕ + π)."
function native_u!(qc, q, θ, ϕ, λ)
    qc.rz(λ, q)
    qc.sx(q)
    qc.rz(θ + π, q)
    qc.sx(q)
    qc.rz(ϕ + π, q)
end

"Kicked-Ising circuit on `chain`, then the rotations of one setting and a measurement."
function native_setting_circuit(chain, angles, num_device_qubits)
    n = length(chain)
    qc = QuantumCircuit(num_device_qubits, n)
    for q in chain
        native_u!(qc, q, π/4, -π/2, π/2)       # e^{-iπ/8 X}
    end
    for i in 1:n-1
        qc.cz(chain[i], chain[i + 1])          # e^{iπ/4 ZZ}, up to the S† gates below
    end
    for (i, q) in enumerate(chain)
        bonds = (i > 1) + (i < n)
        qc.rz(-π/2 * bonds, q)                 # one S† per bond
        native_u!(qc, q, angles[i, 1], angles[i, 2], angles[i, 3])
        qc.measure(q, i)                       # outcome of chain qubit i goes to bit i
    end
    qc
end

circuits = [native_setting_circuit(chain, angles[r, :, :], num_device_qubits) for r in 1:NU_hw]
println(length(circuits), " circuits, each with ", count(inst -> inst.name == "cz", circuits[1].data), " CZ gates")
1024 circuits, each with
95 CZ gates
الخطوة 3: التنفيذ باستخدام primitives في Qiskit
تشغّل QiskitIBMRuntime.jl دائرة واحدة لكل مهمة Sampler، لذلك يتطلب جمع البيانات 1,024 مهمة. تُبقي الخلية التالية ما يصل إلى 32 مهمة في الطابور وتحفظ نتائج كل إعداد بمجرد انتهاء مهمته. تُعاد كل لقطة كمتجه من البتات، حيث العنصر هو نتيجة الكيوبت في السلسلة.
يجب أن تسترجع النتائج في الجلسة نفسها التي أرسلت المهام، لأن QiskitIBMRuntime.jl لا تستطيع بعد البحث عن مهمة بمعرّفها (qiskit-ibm-runtime-c issue #28). إذا فشلت مهمة، تصدر الخلية تحذيرًا وتستمر. إذا توقفت الجلسة، شغّل الخطوات من 1 إلى 3 مرة أخرى. إعادة تشغيل الخلية ترسل فقط الإعدادات التي نتائجها مفقودة. مع use_saved_data = true، لا ترسل الخلية شيئًا.
outcome_file(r) = joinpath(run_directory, "outcomes", "setting_$(lpad(r, 4, '0')).npz")

"Save the outcomes of setting `r` as a (shots × N) matrix of 0/1 values."
function save_outcomes(r, job)
    try
        samples = get_sampler_job_results(job, service)
        bits = UInt8.(permutedims(reduce(hcat, samples)))
        npzwrite(outcome_file(r), Dict("bits" => bits))
    catch err
        @warn "Setting $r failed and was not saved; run this cell again to resubmit it" err
    end
end

if use_saved_data
    println("Using the saved ibm_fez measurements; no jobs submitted")
else
    backend_name = "ibm_fez"
    service = Service()  # uses the credentials saved on this computer
    backend = only(b for b in backend_search(service) if b.name == backend_name)
    open(joinpath(run_directory, "metadata.json"), "w") do io
        JSON.print(io, Dict("backend" => backend_name, "N" => N_hw, "depth" => 1, "settings" => NU_hw,
                            "shots" => NM_hw, "chain" => chain_physical), 2)
    end
    in_flight = []
    for r in 1:NU_hw
        isfile(outcome_file(r)) && continue
        push!(in_flight, (r, run_sampler_job(service, backend, circuits[r], NM_hw)))
        length(in_flight) >= 32 && save_outcomes(popfirst!(in_flight)...)
    end
    foreach(job -> save_outcomes(job...), in_flight)
    println("Saved outcomes: ", count(r -> isfile(outcome_file(r)), 1:NU_hw), " of ", NU_hw, " settings")
end
Using the saved ibm_fez measurements; no jobs submitted
الخطوة 4: المعالجة اللاحقة وإرجاع النتيجة بالصيغة الكلاسيكية المطلوبة
تقرأ هذه الخطوة البيانات المحفوظة فقط: تشغيل ibm_fez المنزَّل إذا كانت use_saved_data صحيحة، أو الملفات التي كتبتها الخطوة 3 في غير ذلك. لذلك يمكنك تشغيلها في جلسة جديدة دون إرسال مهام (شغّل خلية الإعداد وخلية use_saved_data والخطوة 1 أولًا). يخزّن الملف المنزَّل النتائج الـ 96 لكل لقطة مضغوطة في 12 بايت، بدءًا بالبت الأكثر أهمية، لذلك يفك المحمِّل ضغطها. تسمّي RandomMeas.jl النتائج 1 و2، لذلك يضيف المحمِّل أيضًا 1 إلى كل بت.
"Build a `MeasurementGroup` from the angles and a function `outcomes(r)` that returns
the (shots × N) 0/1 outcomes of setting `r`."
function measurement_group(angles, outcomes)
    settings_count, n = size(angles, 1), size(angles, 2)
    sites = siteinds("Qubit", n)
    data = map(1:settings_count) do r
        rotations = Array{ComplexF64}(undef, n, 2, 2)
        for i in 1:n
            rotations[i, :, :] = u3_matrix(angles[r, i, :]...)
        end
        MeasurementData(Int.(outcomes(r)) .+ 1;
            measurement_setting=LocalUnitaryMeasurementSetting(rotations; site_indices=sites))
    end
    MeasurementGroup(data)
end

if use_saved_data
    packed = saved_run["outcomes"]  # settings × shots × 12 bytes
    # Bit i of a shot is in byte (i - 1) ÷ 8 + 1, most significant bit first
    unpack(r) = [(packed[r, s, (i - 1) ÷ 8 + 1] >> (7 - (i - 1) % 8)) & 0x01
                 for s in 1:size(packed, 2), i in 1:N_hw]
    group_hw = measurement_group(angles, unpack)
else
    group_hw = measurement_group(angles, r -> npzread(outcome_file(r))["bits"])
end
println(group_hw.NU, " settings × ", group_hw.NM, " shots on ", group_hw.N, " qubits")
1024 settings ×
1024 shots on 96 qubits
قبل التعلّم، افحص البيانات. الكيوبت المعطوب أو البوابة سيئة المعايرة تجعل الحالة المقيسة أكثر اختلاطًا بكثير حولهما، وقد تجعل المتعلِّم يتباعد. نقاء بضعة كيوبتات متجاورة هو معيار لا يعتمد على نموذج لهذه الضوضاء: تقدّر الدالة get_purity من RandomMeas.jl القيمة لنظام فرعي بمقارنة أزواج من اللقطات من الإعداد نفسه. احسب إنتروبيا Rényi-2 لكل نافذة من ستة كيوبتات متجاورة، وقارنها بالنافذة نفسها من الحالة المثالية. القيمة المثالية ليست صفرًا، لأن كل نافذة متشابكة مع بقية السلسلة؛ الضوضاء ترفعها، والكيوبت المعطوب يدفع كل نافذة تحتويه نحو الحد الأقصى وهو ستة.
ideal_hw = kicked_ising_reference(N_hw, 1)
width = 6
starts = 1:N_hw - width + 1
window_entropy(rho, w) = -log2(mpo_overlap(segment_mpo(rho, w), segment_mpo(rho, w)))
measured_entropy = [-log2(get_purity(group_hw, collect(j:j + width - 1))) for j in starts]
ideal_entropy = [window_entropy(ideal_hw, j:j + width - 1) for j in starts]
worst = argmax(measured_entropy)
println("S₂ of six-qubit windows: median ", round(median(measured_entropy), digits=2), "; highest ",
    round(measured_entropy[worst], digits=2), " (chain positions ", worst, " to ", worst + width - 1, ")")
println("Ideal state: ", round(minimum(ideal_entropy), digits=2), " to ", round(maximum(ideal_entropy), digits=2))
plot(starts, measured_entropy; marker=:circle, markersize=2, label="measured",
    xlabel="first chain position of the window", ylabel="S₂ of six qubits", ylims=(0, width),
    legend=:topright, size=(800, 280), left_margin=5Plots.mm, bottom_margin=5Plots.mm)
plot!(starts, ideal_entropy; linestyle=:dash, label="ideal state")
S₂ of six-qubit windows: median 0.9
; highest 1.43 (chain positions 30 to 35)
Ideal state: 0.19 to 0.39
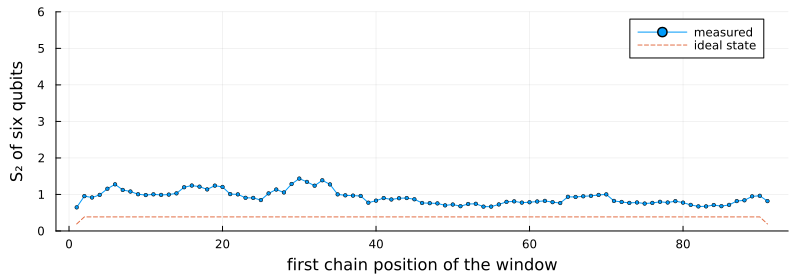
كل نافذة أكثر اختلاطًا من الحالة المثالية، بنحو نصف بت إلى بت واحد، وأكثر المقاطع ضجيجًا حول مواضع السلسلة من 30 إلى 35. لا توجد نافذة قريبة من الحد الأقصى وهو ستة، لذلك لا يوجد كيوبت معطوب، ويستخدم التحليل سلسلة الـ 96 كيوبت كاملة. لو كانت لبعض النوافذ إنتروبيا قريبة من ستة، لأزلت الكيوبت المشترك بين تلك النوافذ وتعلّمت أطول جزء من السلسلة بدونه.
النقاءات نفسها تحدد المعلومة المسبقة CRM. لكل نافذة، تأخذ fitted_prior الحالة المثالية وتلائم قوة إزالة استقطاب محلية بحيث يطابق نقاؤها النقاء المقيس في إعدادات التدريب، كما في الورقة.
تؤدي الدالة learn_and_validate في الخلية التالية بقية التحليل. إنها تتعلم النموذج من إعدادات التدريب، ثم تقدّر و على إعدادات الاختبار لأول كيوبت من السلسلة، بخطوات من 12. هذه هي الكميات الموجودة في الشكل 1(c,d) من الورقة. تُقيَّم الحالة المثالية على بيانات الاختبار نفسها كخط أساس.
تشغّل الخلية الدالة مع ثم تكررها مع و لترى مدى أهمية حجم نوافذ التعلّم. أبعاد الرابطة (bond dimension) يمكن أن تصل إلى على الأكثر، لذلك يتعلم حالة جداء: كل كيوبت وحده، دون ارتباطات بين الكيوبتات.
function learn_and_validate(group; ideal, ell=2, k=3, sizes=12:12:group.N, seed=20260921, train_fraction=0.5)
    split = split_settings(group; seed, train_fraction)
    prior = fitted_prior(ideal, split.train)
    marginals = training_marginals(split.train; ell, prior)
    fit = learn_mpo(marginals, group.N; ell, maxbond=min(4, 4^ell), sweeps=20)
    last(fit.history).purity <= 1 ||
        @warn "The model has purity above one, so the fit diverged. Collect more settings or shots."
    statistics = afc_statistics(split.test, k; prior)
    learned = afc_prefix_curve(fit.model, statistics, split.test.NU; k, sizes)
    baseline = afc_prefix_curve(ideal, statistics, split.test.NU; k, sizes)
    model_entropy = [-log2(mpo_overlap(prefix_mpo(fit.model, n), prefix_mpo(fit.model, n))) for n in sizes]
    (; ell, fit, split, learned, baseline, model_entropy)
end

function plot_validation(results, title)
    n = [r.n for r in first(results).learned]
    # Marker, size, and line style per ℓ. The ℓ = 1 squares are small enough to sit inside the
    # ℓ = 2 circles, so both stay visible where the two curves overlap.
    style = Dict(2 => (:circle, 7, :solid), 1 => (:rect, 3.5, :dash), 0 => (:utriangle, 5, :dot))
    fidelity = plot(yscale=:log10, ylims=(1e-6, 1.5), legend=:bottomleft, xlabel="number of qubits N",
        ylabel="held-out F_max", title=title)
    entropy = plot(xlabel="number of qubits N", ylabel="Rényi-2 entropy S₂", legend=:topleft)
    held_out = first(results).learned
    # Draw every error bar before any marker, so the bars stay behind the symbols
    for (color, result) in enumerate(results)
        scatter!(fidelity, n, [r.fidelity for r in result.learned]; yerror=[r.fidelity_sem for r in result.learned],
            markersize=0, markerstrokecolor=color, label="")
    end
    scatter!(entropy, n, [r.entropy for r in held_out]; yerror=[r.entropy_sem for r in held_out],
        markersize=0, markerstrokecolor=:black, label="")
    for (color, result) in enumerate(results)
        marker, markersize, linestyle = style[result.ell]
        label = "learned model, ℓ = $(result.ell)"
        plot!(fidelity, n, [r.fidelity for r in result.learned]; color, marker, markersize, linestyle,
            markerstrokewidth=0, label)
        plot!(entropy, n, result.model_entropy; color, linestyle, linewidth=2, label)
    end
    plot!(fidelity, n, [r.fidelity for r in first(results).baseline]; marker=:diamond, markersize=5,
        linestyle=:dashdot, color=:black, label="ideal state")
    scatter!(entropy, n, [r.entropy for r in held_out]; marker=:circle, markersize=4, color=:black,
        label="held-out AFC estimate")
    plot(fidelity, entropy; layout=(1, 2), size=(1000, 400), left_margin=7Plots.mm, bottom_margin=7Plots.mm)
end

function summarize(result)
    final = last(result.learned)
    println("ℓ = ", result.ell, ", N = ", final.n, ": held-out F_max = ", round(final.fidelity, sigdigits=3), " ± ",
        round(final.fidelity_sem, sigdigits=2), " (ideal state: ", round(last(result.baseline).fidelity, sigdigits=2), ")")
    println("  S₂ = ", round(final.entropy, digits=2), " ± ", round(final.entropy_sem, digits=2),
        " held out; ", round(last(result.model_entropy), digits=2), " from the model")
    lowest = minimum(minimum(eigvals(Hermitian(operator_from_coefficients(local_coefficients(result.fit.model, w)))))
                     for w in unique(learning_windows(final.n, max(result.ell, 1))))
    println("  Most negative eigenvalue in any learning window: ", round(lowest, digits=4))
end

results_hw = [learn_and_validate(group_hw; ideal=ideal_hw, ell) for ell in (2, 1, 0)]
foreach(summarize, results_hw)
plot_validation(results_hw, "ibm_fez, 96-qubit chain")
ℓ = 2
, N = 96: held-out F_max = 0.591 ± 0.1 (ideal state: 0.0035)
  S₂ = 10.04 ± 0.28 held out; 10.21 from the model
  Most negative eigenvalue in any learning window: -0.0523
ℓ = 1, N = 96: held-out F_max = 0.554 ± 0.094 (ideal state: 0.0035)
  S₂ = 10.04 ± 0.28 held out; 10.26 from the model
  Most negative eigenvalue in any learning window: -0.0215
ℓ = 0, N = 96: held-out F_max = 6.18e-6 ± 1.1e-6 (ideal state: 0.0035)
  S₂ = 10.04 ± 0.28 held out; 32.01 from the model
  Most negative eigenvalue in any learning window: 0.0012
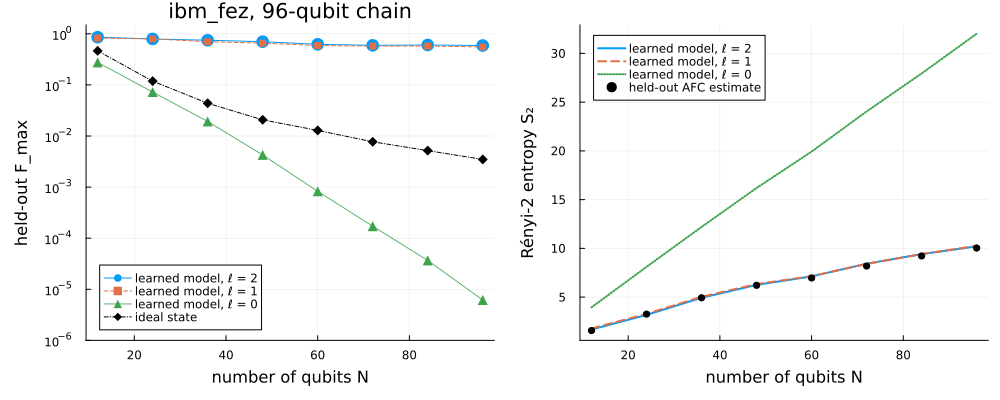
تعيد النتائج إنتاج ادعاءَي الورقة على معالج مختلف:
-
النموذج يصف البيانات أفضل بكثير من الحالة المثالية. عند ، قيمة على البيانات المحجوزة لنموذج هي 0.59 ± 0.10، مقارنة بـ 0.0035 للحالة المثالية. تذكر الورقة حوالي 0.75 على
ibm_brisbane. -
إنتروبيا النموذج تتفق مع بيانات الاختبار عند كل . عند ، تبلغ 10.2 من النموذج و10.0 ± 0.3 من بيانات الاختبار، أي ، مقارنة بـ 0.14 إلى 0.15 على
ibm_brisbaneالأقدم.
تُظهر مقارنة أحجام النوافذ أين توجد المعلومات. مع ، يكون النموذج جيدًا تقريبًا بالقدر نفسه ()، لذلك في هذه البيانات، الارتباطات التي تتجاوز بضعة كيوبتات تضيف القليل. مع ، تفوّت حالة الجداء التشابك بين الكيوبتات المتجاورة: تنمو إنتروبياها إلى 32 بدل 10، وتهبط قيمة لها أسرع من الحالة المثالية، إلى عند .
ضع القيود التالية في بالك عند قراءة هذه الأرقام:
-
تقسيم التدريب. أشرطة الخطأ تغطي الخطأ الإحصائي لبيانات الاختبار فقط. تقسيمات عشوائية أخرى للإعدادات نفسها تعطي بين 0.49 و0.59 عند لـ .
-
المسح الأخير. يعيد المتعلِّم دائمًا النموذج من المسح الأخير، لذلك لا تؤثر بيانات الاختبار أبدًا في النموذج.
-
الموجبية. النموذج غير مقيَّد بأن يكون شبه معرَّف موجبًا؛ وأكثر قيمه الذاتية سلبية في نافذة تعلّم تبلغ نحو . لذلك فإن و له يصفان مؤثرًا، وليس خصائص موثَّقة لحالة فيزيائية.
-
التحليل إلى عوامل. كل تقدير على البيانات المحجوزة يعتمد على افتراض AFC، الذي لا تستطيع القياسات نفسها التحقق منه.
الخطوات التالية
-
كرر التجربة بعمق اثنين مع معاملات الورقة لذلك العمق ( وأقصى بُعد رابطة 8)، وحدد عدد إعدادات القياس التي يحتاجها المتعلِّم.
-
تعلّم بالتحديث ثنائي الموقع بدلًا من ذلك (
update=:two_siteفيtraining_marginalsوlearn_mpo)، الذي يقتطع بُعد الرابطة بعد كل خطوة، وانظر كيف يتصرف مع عدد أقل من إعدادات التدريب. -
تعلّم بدون المعلومة المسبقة CRM (
prior=nothing) وقارن الدقة (fidelity) على البيانات المحجوزة. -
طبّق التحليل نفسه على قياسات
ibm_brisbaneالتي نشرها المؤلفون. -
اقرأ ملحق الورقة لمعرفة اشتقاق التحديث ومقدّرات AFC.
-
استكشف بروتوكولات القياس العشوائي الأخرى في أمثلة
RandomMeas.jl.
المراجع
-
M. Votto, M. Ljubotina, C. Lancien, J. I. Cirac, P. Zoller, M. Serbyn, L. Piroli, and B. Vermersch, "Learning mixed quantum states in large-scale experiments", Phys. Rev. Lett. 136, 090801 (2026). arXiv:2507.12550
-
A. Elben, S. T. Flammia, H.-Y. Huang, R. Kueng, J. Preskill, B. Vermersch, and P. Zoller, "The randomized measurement toolbox", Nat. Rev. Phys. 5, 9 (2023). arXiv:2203.11374
-
H.-Y. Huang, R. Kueng, and J. Preskill, "Predicting many properties of a quantum system from very few measurements", Nat. Phys. 16, 1050 (2020). arXiv:2002.08953
-
A. Elben and B. Vermersch, "RandomMeas.jl: A Julia package for randomized measurements in quantum devices", Quantum 10, 2086 (2026). arXiv:2509.12749
-
B. Vermersch, A. Rath, B. Sundar, C. Branciard, J. Preskill, and A. Elben, "Enhanced estimation of quantum properties with common randomized measurements", PRX Quantum 5, 010352 (2024). arXiv:2304.12292
-
H. Zou, "Randomized measurements of a 96-qubit kicked-Ising state on ibm_fez", Zenodo (2026). doi:10.5281/zenodo.24116174